Exowatt 用 SageMaker 无服务器模型定制,精度超越前沿模型且成本低至 1/49
Exowatt beats frontier models on accuracy with SageMaker serverless model customization
AI 导读
Exowatt 借助 Amazon SageMaker AI 的无服务器模型定制,为边缘告警分诊和云端能源市场分析构建了可复用的微调流水线,模型精度超过前沿模型,成本最高降低 49 倍。
摘要与补充说明
该方案先基于 Qwen3-1.7B 做边缘告警分诊,再以同样方法对 Qwen3-14B 做云端能源市场分析,微调采用 LoRA 与 SFT。流水线串联 S3、SageMaker 无服务器微调与评估、Model Registry、Bedrock Custom Model Import 及 Lambda 与 EventBridge,无需管理实例、集群或端点。
正文· AI 翻译
Exowatt 构建模块化、可调度的太阳能系统,为 AI 数据中心等能源密集型应用提供可靠电力。其旗舰产品 Exowatt P3 通过光学透镜捕获太阳能,将其以热量形式储存在长时热电池中,并通过热机按需调度电力。与并网光伏太阳能系统不同,P3 直接在电表后端为数据中心供电,帮助数据中心无需等待长达数年的电网互联排队即可上线。Exowatt 构建了一支 AI 智能体集群,用于监控和分诊实时告警,并为太阳能系统的运营决策提供支持,这些智能体通常部署在边缘侧,网络连接有限甚至完全没有连接。随着其集群从测试台架扩展到制造环节以及数千台现场部署单元,运行这些系统的智能层也必须随之扩展。
在本文中,我们展示 Exowatt 如何利用 Amazon SageMaker AI 无服务器模型定制构建可重复的 AI 流水线。该流水线为边缘和云端两个部署目标生成任务专用的微调模型,在成本最高降低 49 倍的情况下实现比前沿模型更高的准确率。
这里描述的两个模型是该流水线的首批产出,而非最终目标。此次合作更持久的成果是流水线本身:一条从原始运营数据到经认证的训练集、微调模型和经过评估的部署产物的可重复路径。Exowatt 现在可以在数天内而非数月内走完这条路径。告警分诊和能源市场分析只是众多狭窄、高价值任务中的两个,同样的方法也适用于其他任务。
挑战:物理能源基础设施上的 AI
Exowatt 的能源管理系统(EMS)运行在日益增长的运营站点集群上。每个站点持续产生告警:硬件组件运行超出规格、连接中断、电压读数超出范围等类似事件。随着集群扩展到数千台现场单元,人工操作员无法实时监控每个站点。Exowatt 需要一个 AI 智能体,能够读取每个站点的告警状态,并自主、可靠地采取或建议正确的下一步行动。
前沿模型无法解决这个问题,原因有三:
- 任务狭窄且专有。Exowatt EMS 上的告警分诊依赖于其特定的硬件、数据和运营逻辑。通用前沿模型并不专门针对此任务。
- 它必须在边缘运行,没有 GPU,且通常没有互联网。许多站点连接有限或时断时续,因此依赖云端调用前沿模型的智能体在连接中断时会让操作员失去覆盖。
- 成本在集群层面无法扩展。将数千个站点的每个运营决策都路由到前沿模型,对于持续重复的决策来说并不经济。
这正是 Exowatt 转向模型定制的原因。Exowatt 最初的微调工作流依赖于选择开放权重模型、构建容器并创建自定义训练配方,然后才能运行任何实验。这是模型实验的一大障碍。此外,他们还必须决定模型微调的 GPU 硬件需求。随着团队加快实验节奏,每次运行首先需要选择特定的 GPU 实例类型,然后等待自行选择的容量变得可用。当所选实例类型不可用时,这可能会延迟运行的启动,甚至完全阻塞运行。
他们需要一个足够小的模型,能在无 GPU 的边缘控制器上运行,同时在特定任务上足够准确,能与前沿模型相媲美,从而自主行动。微调弥补了这一差距:一个紧凑、任务专用的模型,既可在云端部署,也可在边缘部署。
解决方案概述
Exowatt 通过在 Amazon SageMaker AI 上采用云原生、无服务器的模型定制方法应对了这些挑战。同一训练流水线为两个部署目标生成微调模型:边缘和云端。
Exowatt 在第一个用例(边缘告警分诊)中基于 Qwen3-1.7B 模型实施了这一方法,随后将同样的方法应用于第二个用例(云端能源市场分析)的 Qwen3-14B 模型。该公司计划复用这一解决方案,在整个机队中构建更小的任务专用模型。
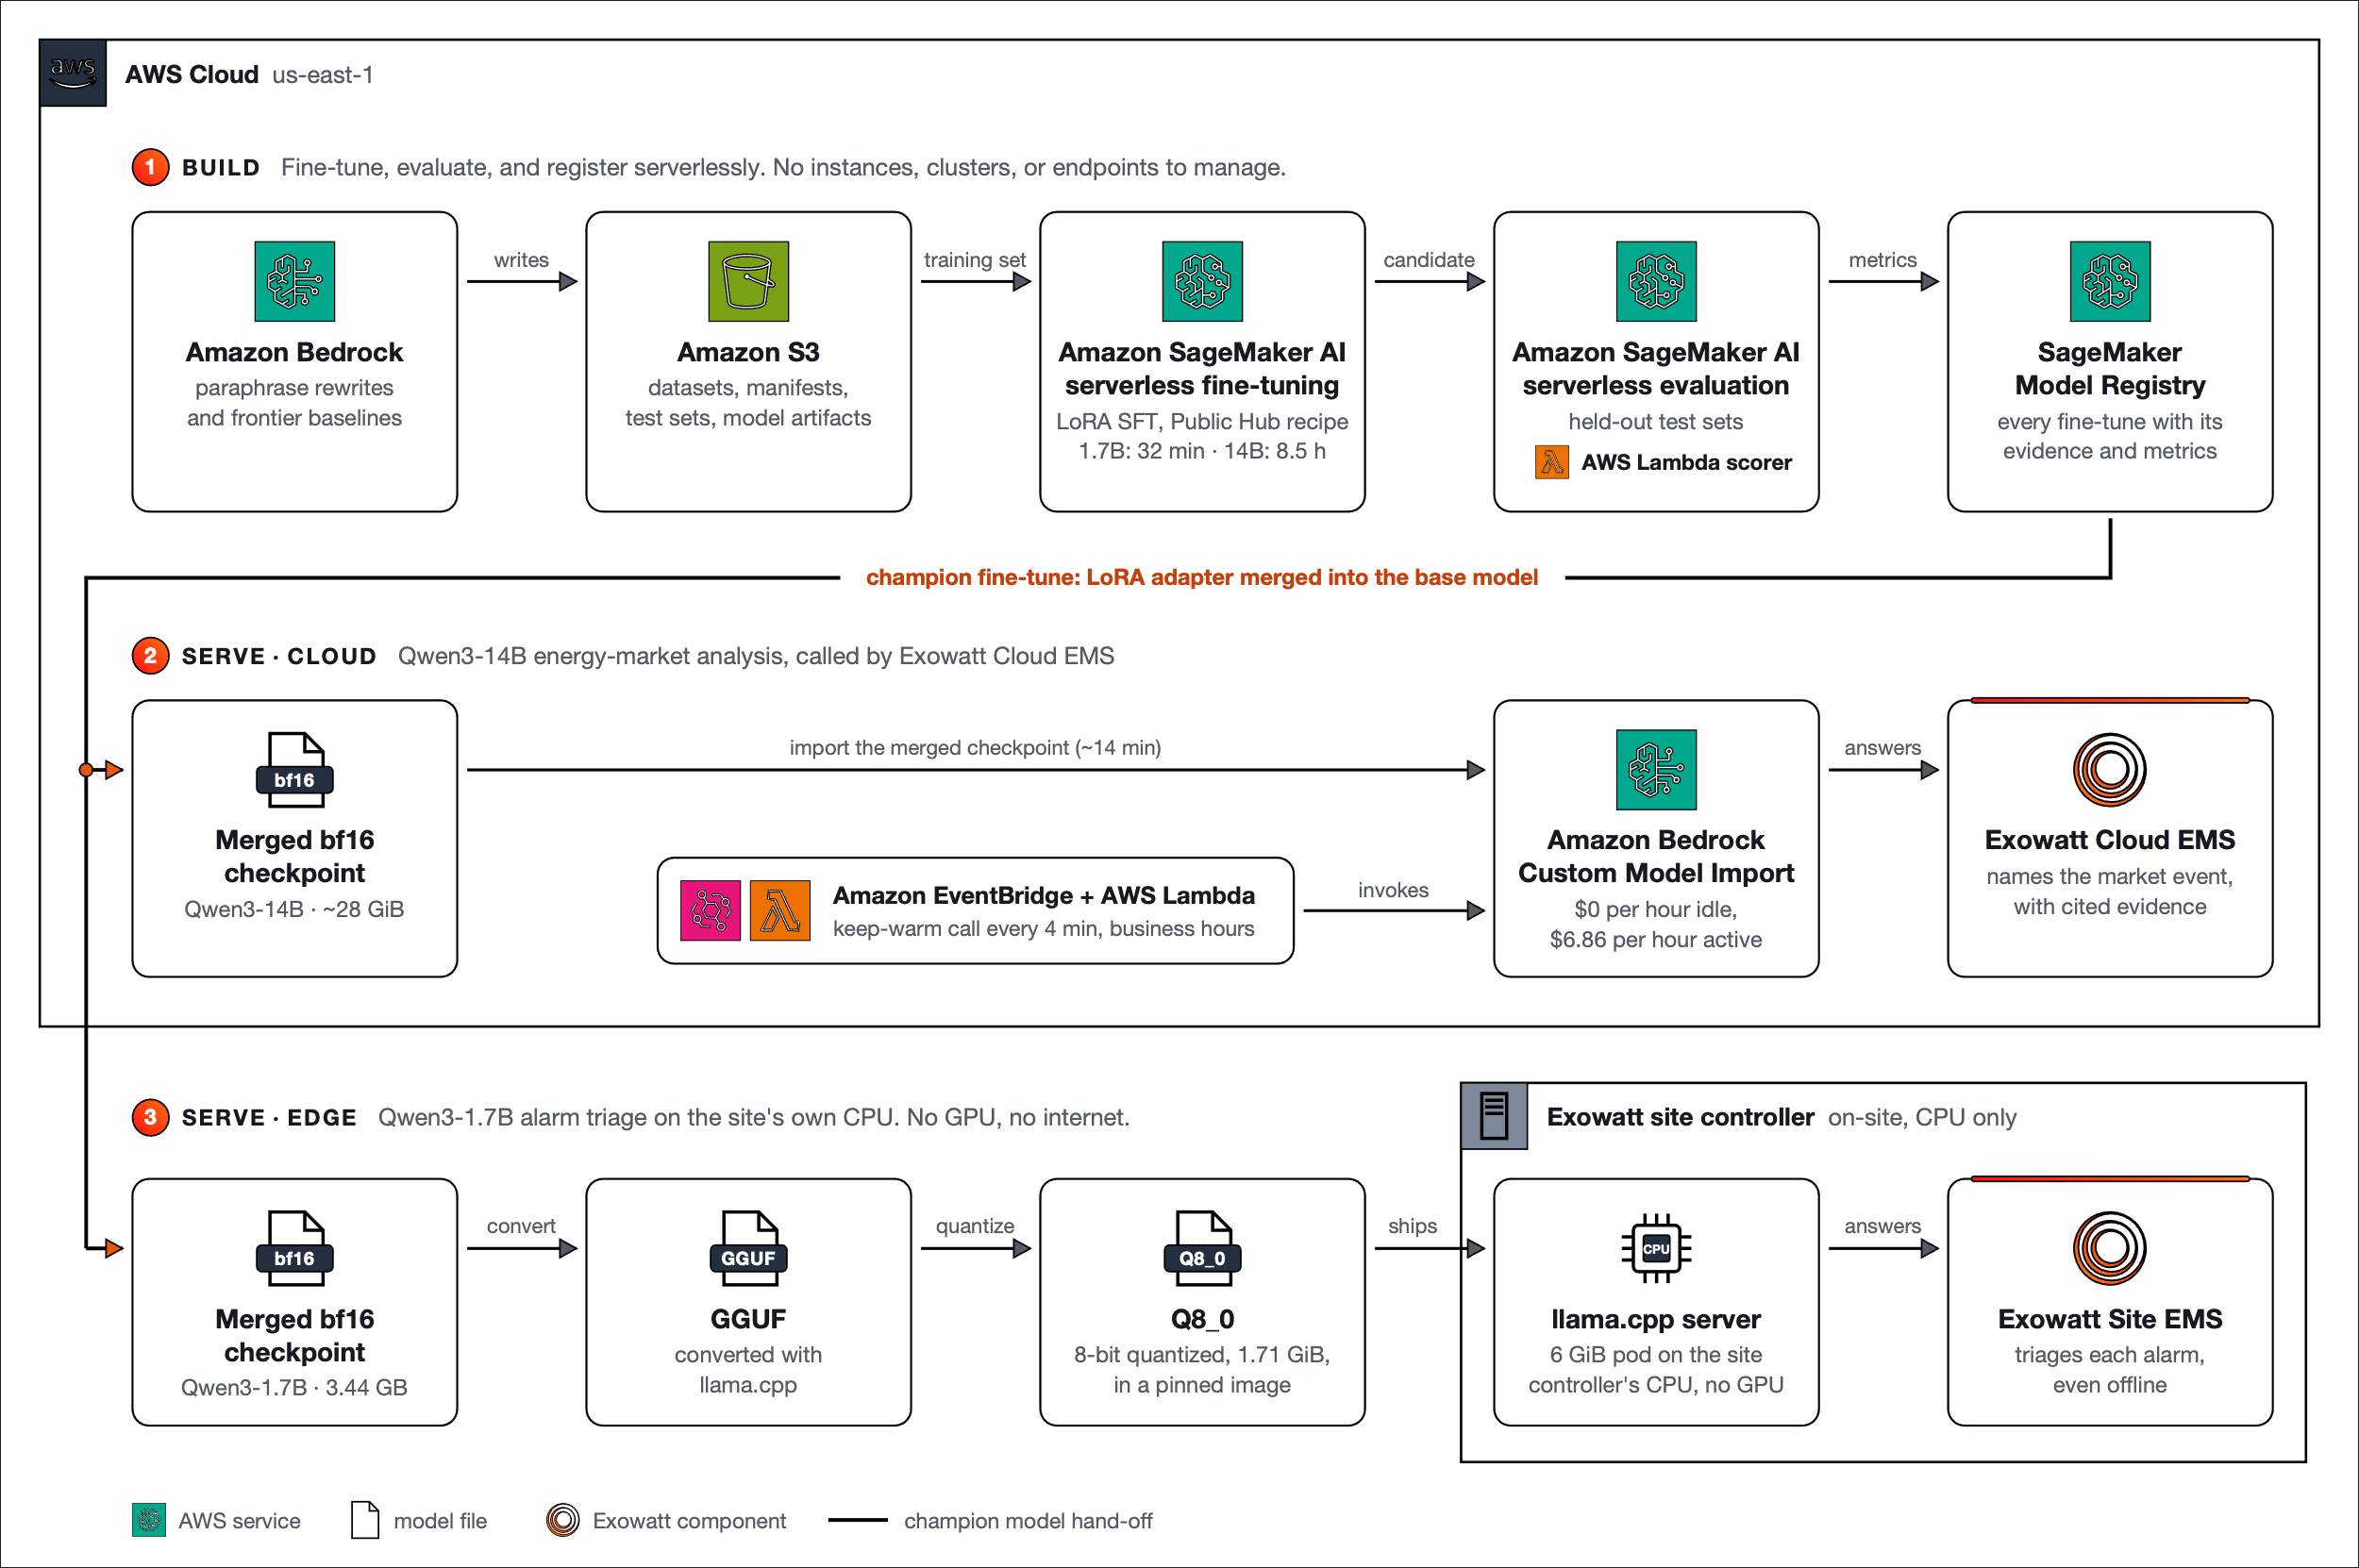
图 1:Exowatt 微调与部署流水线,涵盖构建、云服务与边缘服务三个阶段
以下七项 AWS 服务为 AI 流水线提供支持,无需管理任何实例、集群或端点:
| AWS 服务 | 用途 |
| Amazon Simple Storage Service (Amazon S3) | 数据、清单、模型产物和测试集 |
| Amazon SageMaker AI 无服务器微调 | 每次微调运行,均从 Public Hub 配方启动 |
| Amazon SageMaker AI 无服务器评估 | 每个候选模型 2,000 条答案,作为托管作业评分 |
| SageMaker Model Registry | 每次完成的微调及其证据和指标 |
| Amazon Bedrock Custom Model Import | 为 Cloud EMS 托管微调后的 Qwen3-14B,由 Cloud EMS 服务私有调用。无闲置成本 |
| Amazon Bedrock(Claude、Qwen3) | 改写(训练数据中每条答案三次重写)和前沿模型基准测试 告警分诊的改写使用 Amazon Bedrock 上的 Qwen3-VL-235B。能源市场的改写使用 Amazon Bedrock 上的 Claude Sonnet 4.6。 |
| AWS Lambda + Amazon EventBridge | 无服务器评估评分器,以及自定义模型的定时保活调用 |
该工作流分为三个阶段:
模型定制(云端):Exowatt 在 SageMaker AI 上使用无服务器模型定制、低秩适配(LoRA)和监督微调(SFT)对开放权重基础模型进行微调。由于无服务器训练按需分配容量,团队每天可运行多个实验,而无需等待自行选择的 GPU。评估后,最佳模型会注册到 SageMaker AI Model Registry。
边缘部署:对于告警分诊等延迟敏感、连接受限的工作,微调后的 Qwen3-1.7B 模型会被冻结、量化为 GGUF 格式,并使用 llama.cpp 在边缘的 Kubernetes Pod 内通过现场控制器运行。此路径无需 GPU,且无需互联网连接即可运行。
云端部署(弹性):对于联网的机队级分析,微调后的 Qwen3-14B 能源市场模型通过 Amazon Bedrock Custom Model Import 提供服务,无闲置成本,仅在模型活跃时计费。
为什么选择 Amazon SageMaker AI 无服务器模型定制
Amazon SageMaker AI 无服务器模型定制服务通过 SageMaker Public Hub 提供多种开放权重模型以及现成的微调配方,因此团队无需构建和优化自定义训练容器,而这项工作原本可能需要数周时间。对 Exowatt 而言,这使微调从一项稀缺的、需要排期的活动转变为一项常规的、按需进行的活动。这使得快速实验与测试循环变得可行,同时保持较低的实验成本。
在预置 GPU 上进行微调需要选择特定的实例类型、申请该容量、等待其可用、运行作业,并在持有实例期间持续付费。持有时间通常包括实验之间的空闲时间,因为专用实例会一直保持运行。对于运行大量实验的小团队来说,这会拖慢创新并增加成本。Amazon SageMaker AI 无服务器模型定制会自动管理和编排运行微调作业所需的基础设施,消除容量管理的烦恼,并且仅按微调作业运行的时间收费。
用例 1:使用 Qwen3-1.7B 进行边缘告警分诊
Exowatt 站点全天候产生告警。一个紧凑的现场模型会读取每条告警以及站点自身的状态和遥测数据,并返回一小组固定分类之一,同时附上引用的证据(例如系统离线、组件降额或传感器不匹配),或在证据不足时明确弃权。
模型选择与训练数据
团队首先尝试了带提示和防护措施的 Qwen3-8B,但其表现停滞在目标值(0.735 macro-F1)以下。经过微调的 Qwen3-1.7B 改变了这一局面:在这个狭窄的单轮任务上,它以大约五分之一的参数量超越了 Qwen3-8B 加提示的设置,同时保持足够小,可用于无 GPU 的边缘推理。跨 12 个数据集版本的 13 个微调 Qwen3-8B 候选模型从未击败带提示的 8B 基线。而更小的模型配合更多样化的数据做到了。
训练集规模小且经过精心筛选:2,522 个示例,由针对生成的站点场景的 684 个已验证决策,加上 1,838 条经过认证的改写组成,这些改写保持每个决策不变,同时重写文本。改写由 Amazon Bedrock 上的 Qwen3-235B 生成,成本约为 3.72 美元。仅当确定性检查确认决策、标签、证据引用和每个数字均未改变时,才保留每条改写(2,218 个候选中通过了 1,838 个)。一个故障族被完全排除在训练之外,并保留了 320 个案例用于测试。
训练与部署
在 SageMaker 无服务器微调上,训练在大约 32 分钟内完成,成本约为 20–25 美元。量化为 8 位(约 1.71 GiB)后,该模型可在站点现有 CPU 服务器上的 6 GiB llama.cpp pod 中离线运行。它也可在 t3.2xlarge 实例类型上运行。
用例 2:使用 Qwen3-14B 进行云能源市场分析
可调度储能将时机转化为运营决策:每个站点必须持续决定为其负荷保留多少储存能量以及何时释放,而对于并网站点,市场状况会影响这一选择。经过微调的模型读取六小时的实时市场数据包(约 90 行实时价格、日前预测和电网通知),并在约四秒内返回五种市场事件之一(例如价格飙升或稀缺附加费)。每项声明都与特定数据行关联,以指导调度策略。
为什么选择 Qwen3-14B
选择 Qwen3-14B 是因为 Amazon Bedrock Custom Model Import 支持它,它以 SageMaker Public Hub 模型的形式提供,并附带现成的 LoRA 配方(无需管理自定义容器或实例类型),而且它约 28 GiB,足够小,可以经济高效地提供服务。
训练数据与流程
Exowatt 基于来自五年历史(12 张表约 1.63 亿行)的公开 Electric Reliability Council of Texas (ERCOT) 市场数据对该模型进行了微调。团队通过规则将这些数据标注为 25,000 个示例(22,000 个用于训练、1,000 个用于验证、2,000 个留出用于测试)。随后,他们让 Amazon Bedrock 上的 Anthropic Claude Sonnet 4.6 重写每个示例的文本,同时保持其标签和数值字段不变,从而将训练集扩展到 86,281 行。
训练为单轮 LoRA(rank 16,alpha 32),在托管无服务器微调中约 8.5 小时完成,最多同时运行四个作业。从初始计划到冠军模型在 Cloud EMS 中提供服务,团队在六天内运行了 23 个作业,约 155 小时的托管训练。
决定性的改进来自释义多样性:为每个答案增加三次重写,将 macro-F1 从 0.950 提升到 0.975。基础模型仅得分 0.415 macro-F1。它能生成有效的 JSON,但尚不了解市场。微调解决了这个问题。
部署
合并后的检查点在大约 14 分钟内导入到 Amazon Bedrock Custom Model Import。该模型运行时没有空闲成本,仅在活跃时按每小时 $6.86 计费。
基准测试结果
在边缘告警分诊任务上,微调后的 Qwen3-1.7B 从一个无法生成有效答案的模型提升到在 320 个测试用例上达到 0.911 macro-F1,领先于所有前沿基线。将相同的微调与评估循环应用于具有 2,000 个测试用例的能源市场任务,Qwen3-14B 达到 0.975 macro-F1,再次领先于前沿基线,且成本仅为一小部分。在这两种情况下,一个小型微调模型在特定任务上击败了规模大得多的通用模型。
两个模型都返回严格的 JSON,其中每个声明都引用特定的输入数据行。任何不受支持的声明在到达操作员之前都会被丢弃,这正是团队能够在自主的物理环境中信任小型模型的原因。
| 模型 | Macro-F1 | $ / 1,000 次决策 | 离线? |
| Claude Haiku 4.5 | 0.519 | ~$4.70 | 否 |
| Claude Opus 4.7 | 0.680 | ~$22 | 否 |
| Claude Sonnet 4.6 | 0.698 | ~$15 | 否 |
| 微调后的 Qwen3-1.7B | 0.911 | $0* | 是 |
| 基础 Qwen3-1.7B | 无分数(未通过有效性门槛) |
表 1:边缘告警分诊结果,微调后的 Qwen3-1.7B 与前沿模型对比
每 1,000 次决策 $0 意味着没有按量计费的 API 或 GPU 推理成本。量化模型在站点现有的 CPU 上运行。
| 模型 | Macro-F1 | 事件准确率 | 有效 JSON | $ / 1,000 个答案 |
| 基础 Qwen3-14B | 0.415 | 0.54 | 0.834 | $0.64 |
| Claude Sonnet 4.6 | 0.538 | 0.584 | 0.991 | $17.79 |
| Claude Opus 4.7 | 0.625 | 0.718 | 0.9995 | $29.26 |
| 微调后的 Qwen3-14B | 0.975 | 0.983 | 1.000 | $0.60 |
表 2:云能源市场分析结果,微调后的 Qwen3-14B 与前沿模型对比
成本为 Amazon Bedrock 标价乘以每个答案实测的 token 数。微调将一个开放模型从最后一名提升到第一名:比 Claude Opus 4.7 高 +0.35 macro-F1(95% 置信区间 0.324 至 0.371),而每 1,000 个答案的成本约低 49 倍($0.60 对 $29.26)。该模型在第二个、更晚的测试集上保持了 0.968 macro-F1。
业务收益
更快的迭代与更快的上市时间:Exowatt 仅用九天就将定制模型从实验推进到生产环境。如果团队必须自行构建和优化自定义容器与训练配方、配置 GPU 并管理基础设施,这一过程可能需要数月。借助 SageMaker AI 无服务器模型定制,团队训练 Qwen3-1.7B 约用 32 分钟,训练 Qwen3-14B 约用 8.5 小时,无需申请容量,最多可同时运行四个训练作业。针对能源市场用例,Exowatt 运行了 23 个作业,总计约 155 小时的托管训练,并在六天内从基础模型推进到在 Cloud EMS 中提供服务的微调模型。合并后的检查点导入 Amazon Bedrock 约用 14 分钟。端到端流水线使用了七项 AWS 无服务器服务,Exowatt 无需管理任何实例、集群或端点。
相比前沿模型具有更高准确率:两个微调模型在各自任务上都优于更大的前沿模型:Qwen3-1.7B 的 macro-F1 为 0.911(Claude Sonnet 4.6 为 0.698),Qwen3-14B 为 0.975(Claude Opus 4.7 为 0.625)。
两种部署方式的成本都更低:在云端,Qwen3-14B 每 1,000 条回答收费 0.60 美元,而 Claude Opus 4.7 为 29.26 美元(约低 49 倍),没有闲置成本,仅在 Amazon Bedrock Custom Model Import 上活跃时每小时收费 6.86 美元。在边缘端,量化后的 Qwen3-1.7B 在站点现有 CPU 上运行,没有每次推理成本,也不依赖网络连接。
有依据、低风险的输出:在两个模型中,证据围栏移除了所有无引用依据的声明(任何证据引用的来源、字段或值无法与输入字面匹配),边缘模型在不确定时会弃权而不是猜测。正因如此,团队才能让它在站点云托管副本上以影子模式自主运行。
经验教训
对于特定任务,更小的微调大语言模型可以胜过大型前沿模型:微调后的 Qwen3-1.7B 和 Qwen3-14B 模型在目标任务上都优于前沿模型,以更小的模型实现了更高准确率和更低成本。
数据质量和多样性比原始数据量和额外训练轮次更重要:对于范围严格限定的任务,数据质量比模型规模或数据量更重要。在告警分诊模型上,更多经过验证的训练多样性将 macro-F1 从 0.584(仅用 684 条已验证决策训练)提升到 0.911(使用经释义扩展的 2,522 行数据集)。仅对相同数据行运行更多轮次效果更差:一项对照运行在 684 条原始数据行上训练 11 个轮次(相同步数),仅达到 0.879。在整个过程中,精选数据比数据集规模更重要。
移除配置步骤会改变团队的工作方式:当训练运行不再需要等待 GPU 容量时,微调就从罕见事件转变为常规的迭代工作。
一条训练流水线服务两个部署目标:将模型训练与部署分离,使 Exowatt 能够将同一流水线同时用于离线边缘部署和联网的机群级分析,从而简化运维并加速云端模型部署。
结论
Exowatt 现在拥有一个可复用的 AI 流水线,它将任务从针对特定模型的数据准备推进到模型部署。Exowatt 并不打算为不同任务调优同一个模型,而是计划将相同的微调原则应用于不同任务,每个任务都有自己的数据、特定模型和评估,并随着新设备类型和市场任务上线,在整个设备集群中推广。
这一模式可以推广到能源行业之外。各行业的 AI 工程师、数据科学家和客户都可以采用相同的原则。使用 Amazon SageMaker AI 无服务器模型定制作为低开销的 AI 流水线,微调小型、任务特定的模型,然后将它们部署到工作发生的地方:当连接性或延迟有要求时部署到边缘,对于弹性工作负载则通过 Amazon SageMaker AI 这样的托管云端点部署。
要了解更多信息,请参阅 Amazon SageMaker AI 无服务器模型定制 和 Amazon Bedrock。
关于作者

Purna Sanyal
Purna 是 AWS 的 GenAI 专家架构师,帮助客户构建具有自定义模型和大规模推理的 Agentic AI 应用,并成功采用云原生架构。他专注于数据战略、GenAI 基础设施和应用 AI。他热衷于架构可扩展的 AI 系统,以推动创新和用户影响。

Tim Child
Tim 是 Exowatt 的软件与 AI 首席工程师,负责领导公司为 AI 数据中心提供清洁、可调度能源背后的软件、AI 和数字系统。他领导运行 Exowatt 站点的能源管理系统、公司的 AI 战略,以及全公司依赖的 AI 工具和代理。在加入 Exowatt 之前,他在不列颠哥伦比亚大学获得了物理学(量子计算)博士学位。

Felipe Arce
Felipe 是 Exowatt 的首席软件工程师,工作于 AI 与能源基础设施的交汇处。他构建了微调模型工厂,并帮助构建运行 Exowatt 站点的能源管理系统,以及在仿真中让这些站点活起来的数字孪生。在加入 Exowatt 之前,他在 Microsoft Azure 的事件平台工作了四年。他热爱基础设施,尤其是其他工程师在其上构建的平台。

Jingchao Yang
Jingchao 是 AWS 的初创企业高级解决方案架构师,专长于为代理系统构建湖仓架构。Jingchao 拥有 8 年以上数据工程经验,并拥有地理信息科学博士学位。