Deepgram 如何用 AWS Trainium 优化大规模语音 AI
How Deepgram optimized voice AI at scale with AWS Trainium
AI 导读
Deepgram 将 Nova-3 语音转文字模型迁移到 AWS Trainium2,在离线批处理负载上每美元处理的音频量比原有算力方案提升 11%–70%。
摘要与补充说明
迁移从标准 PyTorch 代码起步,借助 TorchNeuron 编译后模型全部运算均在 Trainium2 上执行、无 CPU 回退,并通过 NKILib 融合算子与手写 NKI 内核继续调优:FFN 内核在 batch size 96 时延迟降低 2.0x,depthwise conv1d 提速 1.5x,自研 conv2d 内核解锁了 32 以上的 batch size。
正文· AI 翻译
随着语音成为 AI 的一等模态,Deepgram 的模型覆盖语音转文本、文本转语音和语音智能体。如今,他们每年为超过 200,000 名开发者和 1,400 家组织处理数千万亿级的音频 token。客户通过 Deepgram API 使用这些模型,或在自己的环境中运行它们,包括在 Amazon SageMaker AI 上。
对 Deepgram 而言,服务效率决定了在给定基础设施预算下系统能处理多少音频。高吞吐的批处理工作负载会给该预算带来巨大压力,因此每个加速器小时的使用效率越高,Deepgram 就能在同一集群上服务更多音频。这使得推理效率成为一个自然的目标,Deepgram 转而采用 AWS AI 芯片来提升效率。他们与 AWS 合作,将其 Nova-3 语音转文本模型引入 AWS Trainium2,用于联络中心分析和医疗转录等离线批处理工作负载。
合作始于 Deepgram 以标准 PyTorch 代码交付 Nova-3。在数月时间里,Deepgram 与 AWS Forward Deployed Engineering (FDE) 团队将 Nova-3 以 PyTorch 重构方式移植到 AWS Trainium2,并针对新硬件进行调优。最终配置在单台 Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge 实例上运行八个模型副本。在 Deepgram 面向吞吐的离线批处理工作负载上,该配置每美元处理的音频量比 Deepgram 此前运行的计算方案多 11%–70%。我们使用评估时的实例定价进行了测量。这些收益帮助 Deepgram 高效扩展、持续交付更好的模型,并以更低价格提供给客户。这些优势也可惠及在 Amazon SageMaker AI 上于自己的虚拟私有云 (VPC) 中自托管 Deepgram 模型的客户。在那里,Deepgram 和 AWS 继续改进设置的便捷性、可靠性和可观测性。
在本文中,我们完整介绍在 Trainium 上的推理优化工作:将 Nova-3 移植到 AWS Neuron 软件栈、随后的内核级调优、让 Deepgram 自有模型服务器能够调用 Trainium 的数据并行 Rust 运行时,以及我们在批处理转录上测得的吞吐量和成本结果。
使用原生 PyTorch 将 Nova-3 优化到 Trainium2
从标准 PyTorch 代码开始,我们使用了 TorchNeuron——Neuron Compiler 的原生 PyTorch 集成,它同时支持 eager 执行和 torch.compile。我们首先在 Trainium2 上以 eager 模式运行 Nova-3,检查哪些操作回退到了 CPU,然后使用 torch.compile 进行编译。编译后的路径在 Trainium2 上运行了所有模型操作,未检测到 CPU 回退。
我们使用 torch.compile 将编码器和解码器编译为独立的静态形状图。在整个过程中,我们在两个层面检查数值精度:与 CPU 对比的层级输出一致性,以及端到端的词错误率 (WER),后者必须与 Deepgram 的参考值和目标保持一致。
在这个可用的基线之上,我们通过用公共 NKI Library (NKILib) 中的融合内核替换若干层,启动了优化工作。NKILib 是一组使用 Neuron Kernel Interface (NKI) 编写的预构建参考内核。这些内核涵盖融合 QKV 投影、融合前馈网络 (FFN) 层和深度可分离一维卷积等操作。
我们针对吞吐量以及由此带来的成本效率进行了优化,面向 Deepgram 的离线推理工作负载。吞吐量以相对于基线配置的相对增益来报告,而非以每秒处理的绝对音频量来报告,并且我们扫描了 1–128 的批大小,以找到使吞吐量最大化的批大小。
使用 Neuron Explorer 和 NAD 进行内核级调优
启用内核只是优化飞轮的第一步:启用一个 NKI 内核(自定义的或来自 NKILib 的),对工作负载进行性能分析,然后根据分析洞察要么调优现有内核,要么用新内核替换它。这个循环会重复进行,直到达到性能目标。在每一步中,Neuron 栈的不同部分都会加速这项工作:NKILib 提供可直接替换的内核,Neuron Explorer 是对 Neuron 工作负载进行性能分析的首选工具,而 Neuron Agentic Development(NAD)工具包则通过其性能分析和内核编写技能来加速性能分析分析和内核调优。
在我们的案例中,NKILib 内核帮助我们完成了大部分工作,而性能分析则显示出在哪些地方手写内核会表现更好。每一次,NAD 的性能分析技能都帮助我们从 Neuron Explorer 的性能分析结果追溯到根本原因,而 NAD 的内核编写技能则帮助生成了替换内核。
| 层 | 我们的发现与改动 | 增益 |
| FFN | 参考内核的分块调度会为每个 token 分块从片外内存重新加载完整的投影权重集合,因此随着 token 数量增长,内存带宽限制了吞吐量。我们手工调优的内核会一次性加载每个权重分块,在多个 token 分块之间复用它,并将权重读取与片上计算流水线化。 | 在批大小为 96 时,相比参考内核延迟降低 2.0 倍 |
| Depthwise conv1d | 实验性的 NKILib 内核将该操作构建为隐式通用矩阵乘法(GEMM),导致 Tensor Engine 利用率偏低。我们将其重写为 Vector Engine 上的广播乘累加循环,达到了引擎的满利用率,足以抵消 Vector Engine 较低的峰值吞吐量。 | 在批大小为 96 时,相比参考内核加速 1.5 倍 |
| Conv2d | 模型的 conv2d 层遇到了编译瓶颈:当批大小超过 32 时,这些层会导致模型无法作为单个图编译。由于 NKILib 没有 conv2d 内核,我们用 NKI 从头编写了一个。该内核按照前面描述的飞轮流程,经过了几轮由性能分析器指导的迭代,从而解锁了大于 32 的批大小。 | 在批大小 ≤32 时,卷积模块最高提升 50 倍 |
Rust 中的数据并行运行时
每个 Trainium2 设备具有八个物理 NeuronCore,默认暴露为四个逻辑 NeuronCore(LNC2)。由于每个 Nova-3 模型实例可以轻松容纳在单个物理核心上,我们将每个逻辑核心的物理核心数减少到一个(LNC1)。这种配置使我们能够在每个 Trainium2 设备上托管八个模型副本(DP8)。输入被并发处理,同时最大化每设备吞吐量。数据并行运行时由一个工作窃取队列驱动,每个副本一个线程。
Deepgram 的生产服务栈是用 Rust 编写的,因此将 Nova-3 移植到 Trainium2 上不仅仅需要编译模型:它还必须在服务路径中不依赖 Python 或 PyTorch 运行。因此,我们构建了一个轻量级运行时,其中 Rust 通过共享的工作窃取队列协调模型副本。一个 C 层通过 Neuron Runtime API 直接加载并执行提前编译的 Neuron 可执行文件格式(NEFF)(libnrt)。该运行时直接与 Deepgram 的服务架构集成,并在所有测试的批大小下精确复现了参考 token 序列。
我们将其与多线程(MT)和多进程(MP)Python 数据并行运行时进行了基准测试。与 MP 基线相比,Rust 运行时完全消除了 Python 解释器的开销。与 MT 基线相比,它进一步缓解了全局解释器锁(GIL)串行化问题,因此来自并发工作线程的调度调用不再在单个进程内争用。这些收益之所以重要,是因为 Nova-3 会为每个音频块执行一系列小型解码器调用,使得主机侧调度在低批大小下成为瓶颈。因此,吞吐量提升在低批大小下最大,即使在吞吐量最大化的批大小下也仍然有意义。在那里,Rust 运行时相比多进程 Python 基线实现了 7.5% 的吞吐量提升。
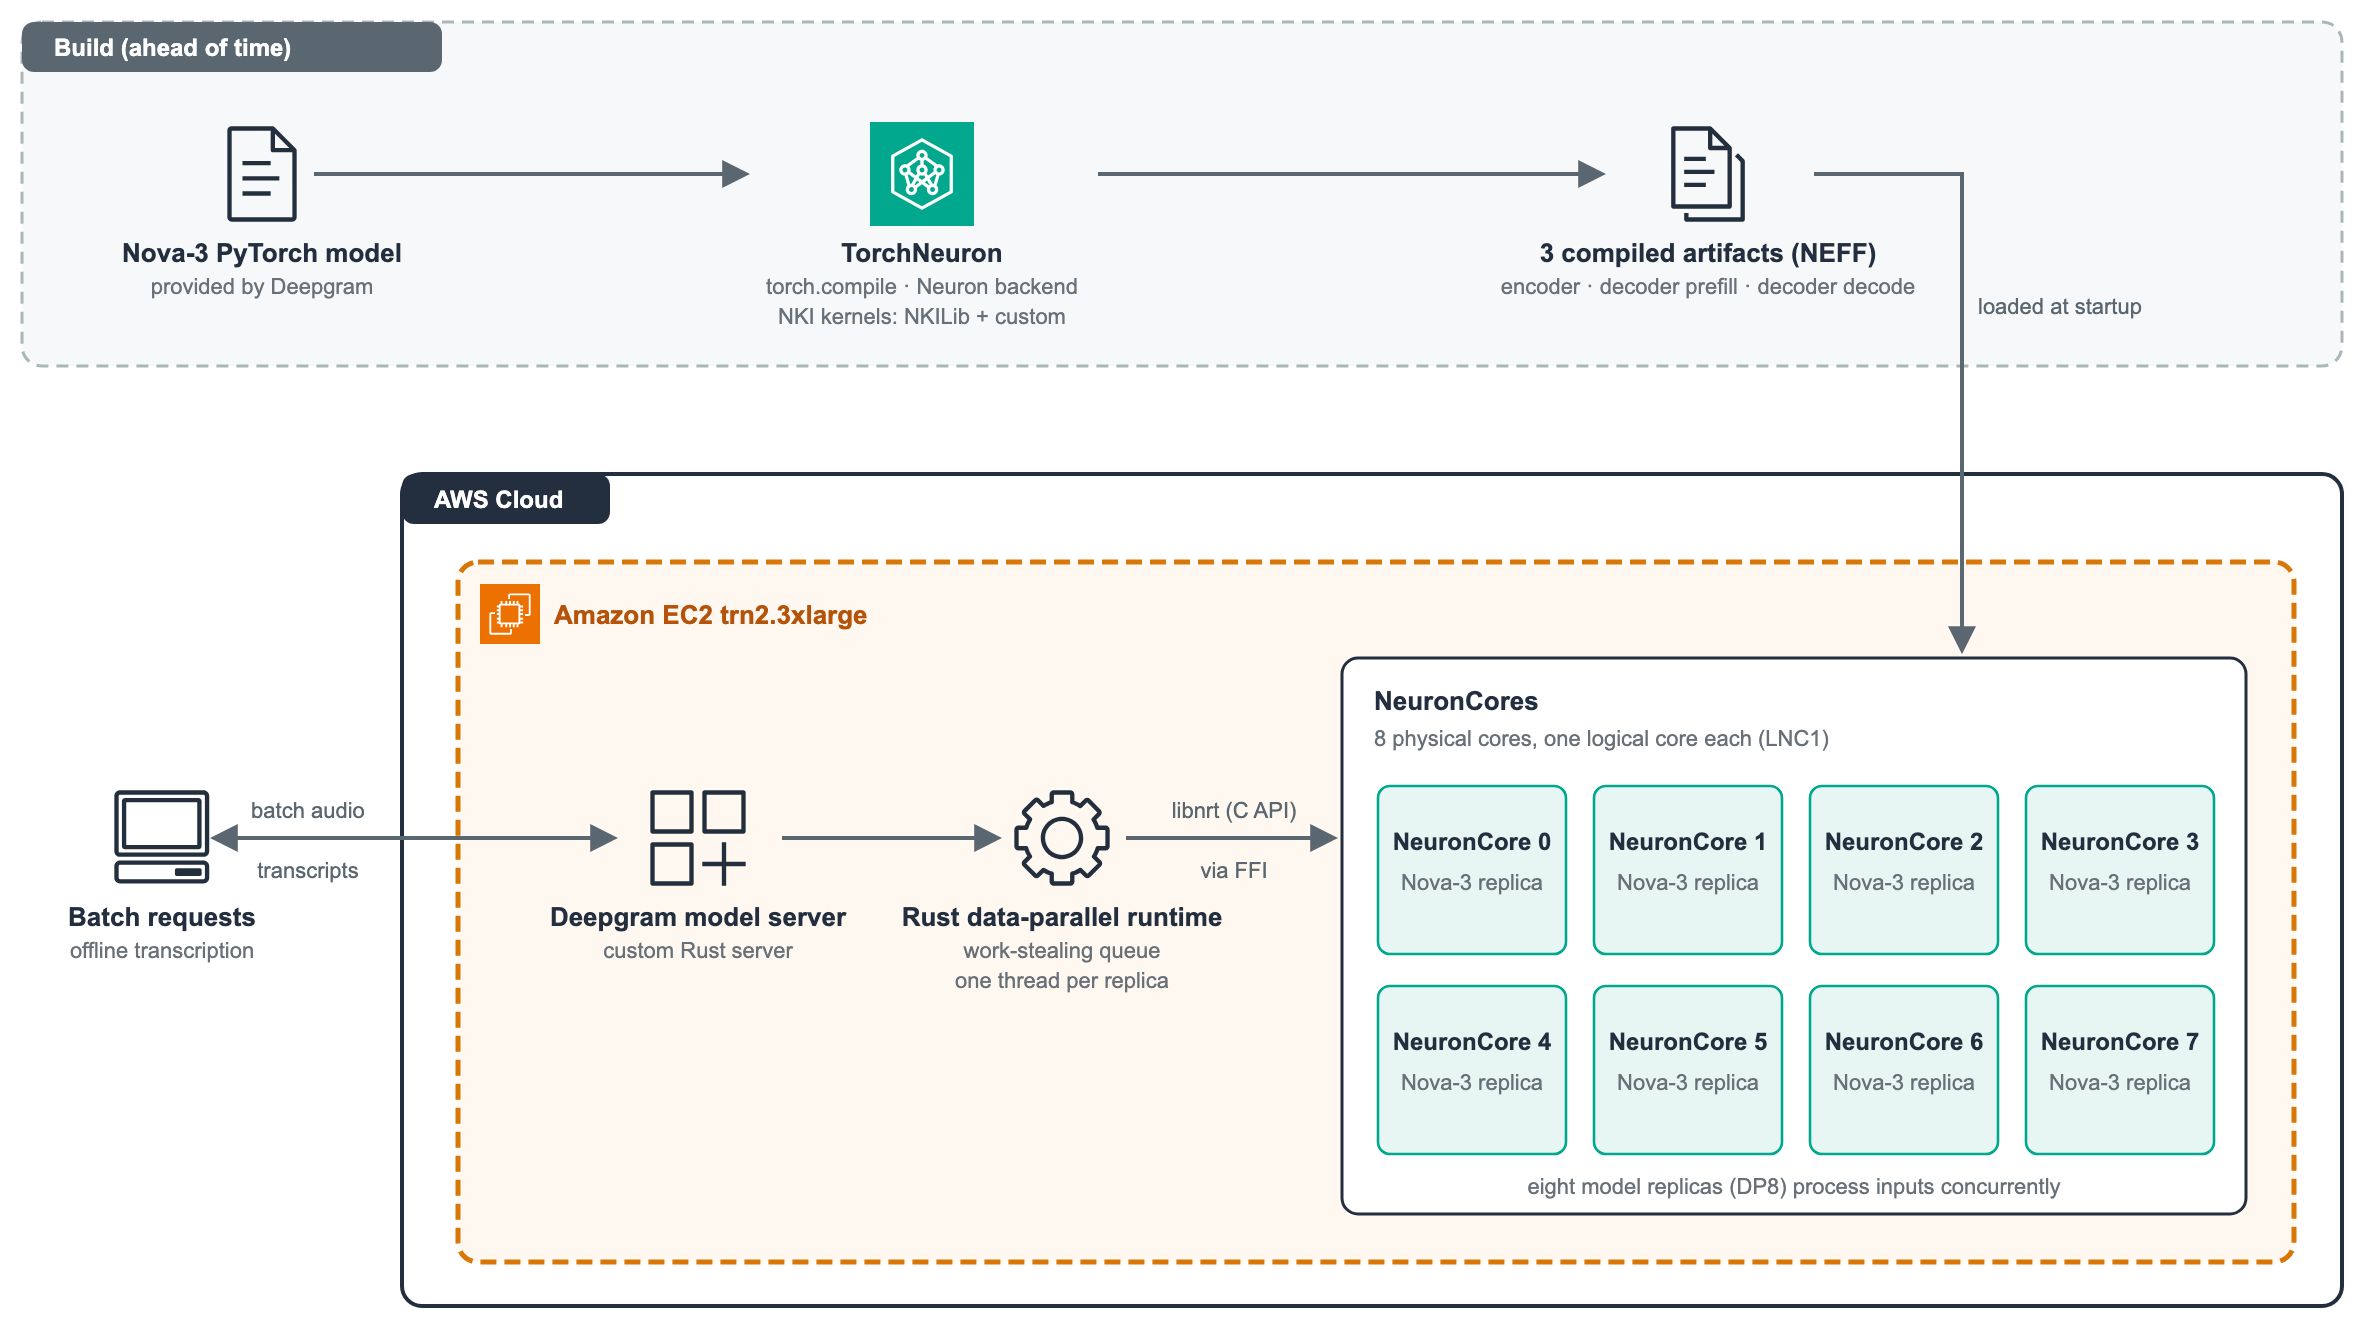
图 1:在 AWS Trainium2 上运行 Deepgram Nova-3,提前编译并由 Rust 提供服务
成本节约影响
我们以每美元处理的音频量来衡量性价比。在 Deepgram 面向吞吐量的离线批处理工作负载上,单设备 Trainium2 配置(trn2.3xlarge)每美元处理的音频量比 Deepgram 此前运行的计算选项多 11% 至 70%。
结论
在本文中,我们展示了 Deepgram 和 AWS FDE 如何使用 TorchNeuron 将 Nova-3 语音转文本 PyTorch 模型移植到 Trainium 硬件上,TorchNeuron 为 AWS Trainium 提供了原生 PyTorch 框架集成。我们通过直接用 NKILib 的预构建内核替换层来提升性能。随后,我们使用 Neuron Explorer 评估性能,并使用 Neuron Agentic Development(NAD)性能分析技能查询性能分析数据并加速性能故障排查。基于这些洞察,我们使用 NAD 内核编写技能调整了内核源代码。最后,我们为 AWS Trainium 构建了一个轻量级 Rust 数据并行运行时,从 Rust 调用 Neuron Runtime API。我们的配置在面向吞吐量的离线场景中展示了成本节约,验证了 AWS Trainium 是 Deepgram 推理工作负载的可行且高效的选择。
要在你自己的模型上尝试这种方法,请从 AWS Neuron 文档开始,其中涵盖了编译器、运行时以及支持的框架。Neuron 内核接口(NKI)指南解释了如何编写本文所述的内核,NKI 示例仓库包含我们起步时使用的参考内核。Neuron 开发者工具文档涵盖了我们在此使用的性能分析和智能体工具,包括 Neuron Explorer 和 Neuron Agentic Development。有关实例规格和定价,请参阅 Amazon EC2 Trn2 实例。如需帮助评估类似的移植项目,请联系 AWS Forward Deployed Engineering。
关于作者

Pierre Lienhart
Pierre 是 AWS Forward Deployed Engineering 团队驻伦敦的高级机器学习工程师。他与模型提供商和 AI 公司合作,帮助他们在多种计算类型上充分释放推理工作负载的潜力,从而在生产环境中以更快的速度和更低的成本提供模型服务。

Victor Wang
Victor 是 Deepgram 的资深软件工程师,并担任工程副总裁的技术顾问。加入 Deepgram 之前,Victor 曾在 AWS 担任多个职位,包括高级解决方案架构师、技术项目经理、Proserve 顾问和软件开发人员。他热衷于学习新技术和环游世界,累计飞行里程已超过 200 万英里。

Andre Gomes
Andre 是 AWS Annapurna Labs ML 的解决方案架构师,拥有帮助初创公司运行大规模训练和实时推理的经验。作为前初创公司联合创始人兼 CEO,他与创始人合作,在 Trainium 和 Inferentia 上扩展其工作负载。Andre 在 UFMG 获得博士学位,并曾在剑桥大学进行研究,将大语言模型和神经主题建模应用于大规模数据分析和决策。

Elyse Zhang
Elyse 是 AWS 的高级 GenAI 策略师,帮助企业客户和初创客户完成模型定制之旅。她专注于将业务需求转化为跨行业的有效定制策略。

Haotian An
Haotian 是 AWS Forward Deployed Engineering 团队的机器学习工程师,专长于定制基础模型和优化大规模推理。他与客户紧密合作,将生成式 AI 适配到其特定用例,帮助他们解锁新能力并推动可衡量的业务成果。

Niraj Chaudhari
Niraj 是 AWS Forward Deployed Engineering 团队的深度学习架构师。他与企业客户合作,通过监督微调和强化微调定制基础模型、构建智能体系统并优化 AI 工作负载。他还帮助客户在 Amazon SageMaker AI 和 Amazon Bedrock 上将生成式 AI 应用从概念验证推进到生产环境。

Rohit Thekkanal
Rohit 担任 AWS Forward Deployed Engineering 团队模型定制方向的机器学习工程高级经理,负责领导专注于模型优化的可扩展生成式 AI 应用开发。他在 Amazon 工作近十年,参与了多项对 Amazon 零售商品目录产生重大影响的机器学习项目。Rohit 拥有芝加哥大学布斯商学院 MBA 学位和卡内基梅隆大学硕士学位。