在 Amazon Bedrock 上用 Grok 4.7 构建长时程智能体
Build long-horizon agents with Grok 4.7 on Amazon Bedrock
AI 导读
AWS 博客介绍 SpaceXAI 的 Grok 4.7 已在 Amazon Bedrock 上线,并演示如何用它搭建工具调用智能体。
摘要与补充说明
作者用三个可穷举验证的任务实测 Grok 4.7 四档推理强度,给出准确率与 token 成本的取舍数据,方法可迁移到自建智能体评测。
正文· AI 翻译
SpaceXAI 的 Grok 4.7 现已在 Amazon Bedrock 上线,该平台提供来自多家提供商的基础模型(FM)供选择。据 SpaceXAI 介绍,Grok 4.7 经过训练,能够在更困难的任务上持续工作更长时间,并且知道何时检查自己的工作。这一点对智能体最为重要,因为智能体要执行多步骤任务,并且必须在过程中验证所发现的内容。
以这种方式工作的智能体不能只是查找信息。它必须形成一个候选答案,将其与已学到的内容进行核对,并不断改进,直到答案合适为止。Grok 4.7 提供了一个推理强度设置,用于控制每次响应前进行多少思考;对于智能体工作负载而言,一个实际问题是应该运行在哪个级别。
在本文中,我们在 Grok 4.7 上构建了一个工具调用智能体,并在三个需要搜索而非查找的任务上对其进行评估。这三个任务分别是:根据告警诊断双服务故障、在相互作用的约束下安排维护,以及在预算限制下选择最优的迁移集合。每个任务都恰好有一个正确答案,并通过暴力枚举进行验证。我们在每个推理强度级别上运行了全部三个任务,每个级别六次,共 72 次智能体运行。
该智能体在 72 次运行中正确回答了 67 次。在 xhigh 下,它正确回答了全部 18 次;在 low 下,它正确回答了 18 次中的 15 次,同时使用的输出 token 约为前者的八分之一。这提供了一个清晰的权衡,你可以根据每个请求进行调整;我们还将展示如何在你自己的任务上衡量这一权衡,以及如何在生产环境中监控它。
我们在全文中报告 token 数量而非货币金额。token 价格会变化,而 token 数量是你自身成本的来源,因此以 token 表示的测量结果始终有效。
SpaceXAI 对 Grok 4.7 的说明
据 SpaceXAI 介绍,Grok 4.7 使用了比 Grok 4.6 更大的基础模型,并在更困难的任务组合上进行了更长时间的强化学习训练。该任务组合侧重于需要数小时才能完成的问题。SpaceXAI 报告称,该模型更擅长验证自己的工作以及管理更长的上下文。
SpaceXAI 公布的基准测试结果也体现了这一重点。相对于 Grok 4.6 的最大提升出现在衡量持续工作而非单轮回答的类别中。
| 基准测试 | 类别 | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | 多小时终端工作 | 20.3% | 37.6% |
| EEBench | 电气工程 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 法律工作 | 15.8% | 19.6% |
| CursorBench 4.0 | 长时间运行的编码 | 40.4% | 46.3% |
| HealthBench Professional | 临床推理 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 多小时办公工作 | 1,546 | 1,657 |
来源:SpaceXAI,Introducing Grok 4.7(https://x.ai/news/grok-4-7)。分数为 SpaceXAI 在模型发布时公布的数据。
基准测试展示了模型在标准任务上的表现。对于你自己的负载,有用的下一步是在与你任务形态相似的任务上进行测量,本文的其余部分将对此进行介绍。
SpaceXAI 列出 Grok 4.7 的上下文窗口为 500K token,支持文本和图像输入以及文本输出。在 Amazon Bedrock 上,该模型支持可配置的推理强度、工具调用和结构化输出。
如何在 Amazon Bedrock 上访问 Grok 4.7
Grok 4.7 运行在 bedrock-runtime 端点上,并通过 跨区域推理配置文件进行访问。有两个配置文件可用:
| 推理配置文件 | 路由 | 使用场景 |
| us.xai.grok-4.7 | 美国地理范围内 | 您有美国数据驻留要求 |
| global.xai.grok-4.7 | 商业 AWS 区域 | 您没有驻留限制,并且希望获得最大容量 |
跨区域推理会将请求路由到多个 AWS 区域,从而在不需逐区域管理容量的情况下获得更高吞吐量。请求需指定某个推理配置文件,而不是裸模型 ID。
该模型支持 OpenAI 兼容的 Chat Completions 和 Responses API,以及 Amazon Bedrock Converse API。在 Converse 上,推理内容会以 reasoningContent 块的形式与 text 块一同返回。在 inferenceConfig 中,仅设置 maxTokens,并将模型特定参数(例如推理强度)放入 additionalModelRequestFields。
有关当前支持的区域、服务层级和 token 价格的列表,请参阅 Amazon Bedrock 用户指南中的 Grok 4.7 模型卡以及 Amazon Bedrock 定价页面(https://aws.amazon.com/bedrock/pricing/)。
先决条件
- 一个可访问 Amazon Bedrock 的 AWS 账户,并且已为 Grok 4.7 启用模型访问权限。
- Python 3.9 或更高版本,并已安装
openai、boto3和aws-bedrock-token-generator。 - 已在您的环境中配置 AWS 凭证。
您的 AWS Identity and Access Management (IAM) 身份需要在推理配置文件和账户的默认项目上均具有 bedrock:InvokeModel:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7或等效的global.。arn:aws:bedrock:{region}:{account-id}:project/default。
请在策略语句中包含这两个资源。除推理配置文件外,还需要默认项目权限。
连接到模型
对于生产环境使用,我们建议从现有 AWS 凭证生成短期 bearer token,这样身份验证始终与您的 IAM 身份绑定,并且不会存储长期密钥:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
推理 token 计入输出 token,并在生成答案文本之前消耗 max_completion_tokens,因此请设置限制时为两者都留出空间。如果在推理期间达到限制,响应将不返回答案文本,因此请在代理代码中检查内容是否为空,若发现为空则提高限制。我们的运行使用了 32,768 个 token 的限制,这在每个强度级别都留有余量。
Grok 4.7 支持四个强度级别:low、medium、high 和 xhigh。强度级别可能随模型版本变化,因此值得向服务确认,而不是硬编码列表:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
设计需要推理的任务
许多代理评估测试的是勤勉程度:读取记录、筛选记录、将其相加。这些任务值得保留,但要看出推理强度带来的贡献,任务必须要求搜索:答案不能直接从数据中读出,而必须提出假设然后进行验证。
我们构建了一个由 20 个服务组成的合成环境,通过七个工具暴露,并在其上构建了三个任务。每个任务都恰好有一个正确答案,并且每个任务的设计都使快速启发式方法不足以找到答案。
| 任务 | 代理需要做什么 | 为什么这是推理任务 |
| two_fault_diagnosis | 两个服务在 03:00 静默失败,另外 12 个服务发出了警报。找出失败的两个服务 | 失败的服务不会发出警报,因此答案不在发出警报的服务之中。共有 190 种可能的配对,只有一种能准确解释观察到的警报 |
| maintenance_schedule | 在四个晚上为八个服务打补丁,每晚两个,需满足十项约束以及一条规则:同一团队的两个服务永远不能安排在同一晚 | 共有 2,520 种可能的排期,只有一种有效。团队规则依赖于代理必须查找的数据 |
| migration_budget | 在预算范围内选择要迁移的候选对象,以最大化风险降低,包括传递性先决条件 | 53 个可行集合,一个最优解。优先选择最佳比例得到的集合比最优解少九分 |
四项实践让这样的测量保持可信,而且它们适用于大多数 agent 评估。
明确列出评分器依赖的每一条规则。 如果提示词留下了一个未明确的边缘情况,一个合理的答案可能会被判为错误,评估最终衡量的是规范而不是模型。例如,诊断提示词明确说明,失败的服务不会自行发出警报。
证明每个任务只有一个答案。 每个环境都小到可以枚举,因此我们在运行任何东西之前检查了每一个候选答案。对于排程,这只需几行:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
只对必需的最终行评分,而不是整个回复。 每个提示词都要求 agent 以一行如 FINAL: auth, checkout 的内容结尾。评分器只读取那一行,因此一个在解释推理时讨论了其他候选答案的回复,会按其结论评分:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
将格式与正确性分开跟踪。 缺少最终行与最终行错误是不同的信号。在我们的运行中,全部 72 个回复都包含了一个可评分的最终行。
在有效值已知的地方,用 enum 约束工具参数,使每次工具调用都指向真实资源:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
系统提示词刻意保持简短,并要求 agent 在给出答案前先检查:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
agent 循环是一个标准的工具调用循环:在设置 reasoning_effort 的情况下调用模型,执行每个返回的工具调用,以 tool_call_id 为键追加结果,并重复直到模型停止请求工具。在整个循环中跟踪 prompt_tokens 和 completion_tokens 可得到下一节中报告的 token 计数。
结果
每个任务在每个 effort 级别下运行六次,共 72 次运行。agent 正确回答了 67 次。
| 任务 | low | medium | high | xhigh |
| two_fault_diagnosis | 6 次中 5 次 | 6 次中 6 次 | 6 次中 6 次 | 6 次中 6 次 |
| maintenance_schedule | 6 次中 5 次 | 6 次中 5 次 | 6 次中 5 次 | 6 次中 6 次 |
| migration_budget | 6 次中 5 次 | 6 次中 6 次 | 6 次中 6 次 | 6 次中 6 次 |
| 全部三个任务 | 18 次中 15 次 | 18 次中 17 次 | 18 次中 17 次 | 18 次中 18 次 |
| 每次运行 | low | medium | high | xhigh |
| 平均输出 token 数 | 1,184 | 6,430 | 6,778 | 9,147 |
| 输出 token 数相对于 low | 1.0x | 5.4x | 5.7x | 7.7x |
| 平均工具调用次数 | 17.2 | 18.7 | 17.8 | 18.1 |
| 耗时中位数 | 18s | 98s | 89s | 106s |
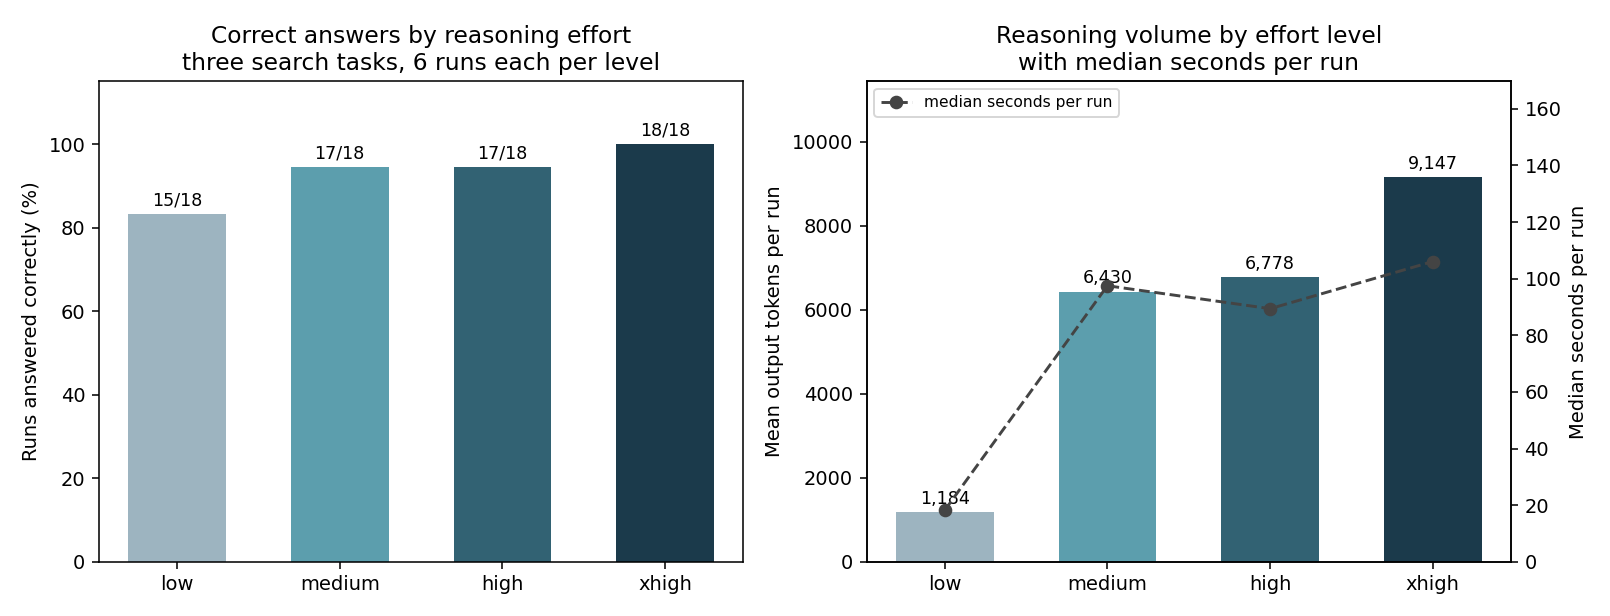
图 1:每个推理 effort 级别下正确回答的运行占比(左),以及每次运行的平均输出 token 数并叠加每次运行的耗时中位数(右)
三点观察。
xhigh 在每次运行中都正确回答。 三个任务的全部 18 次运行在 xhigh 下都正确,而 medium 和 high 各正确回答了 18 次中的 17 次。每个任务和级别只有六次运行,因此级别之间的差异是指示性的,而非统计上的定论,但方向在全部三个任务中是一致的。
Effort 改变的是 agent 推理的多少,而不是它探索的多少。 工具调用次数基本持平,在每个级别下每次运行都在 17.2 到 18.7 之间。无论 effort 如何,agent 收集的事实都相同,改变的是它对这些事实应用了多少推理,输出 token 数从 low 下的 1,184 上升到 xhigh 下的 9,147。
low 提供了很强的成本质量比。在 low 下,该 agent 在 18 次运行中正确回答了 15 次,所用输出 token 约为 xhigh 的八分之一,运行时间中位数为 18 秒。如果稍低的完成率可以接受,或者答案会在下游接受审核,那么 low 是一个高效的选择。如果每个答案都必须一次就正确,那么更高的级别是更稳妥的默认选择。
努力程度如何塑造答案
这些任务围绕一种特定类型的难度设计,观察每个努力级别如何处理它们,可以说明额外的推理在何时值得付出。
优化。迁移任务奖励的是考虑组合,而不是一次只对选项排序。选择个体比率最佳的候选者会产生一个合理的答案,但比最优解低九分。在 medium 及以上,该 agent 在全部 18 次运行中都找到了最优集合。
假设检验。诊断任务要求从两个方向检查候选对:每个告警都必须得到解释,每个保持静默的服务都必须与答案一致。在 medium 及以上,该 agent 在全部 18 次运行中都识别出了正确的配对。
约束满足。调度任务将十项列出的约束与一条依赖查询所得归属数据的团队规则结合起来。xhigh 在每次运行中都生成了有效调度,而这是最高级别带来最明显差异的任务。
这三者呈现出的模式是:当 agent 必须在多个候选答案之间相互权衡,而不是沿着单一路径得出结果时,额外的推理努力最有价值。
在生产环境中监控推理
在生产环境中,你没有已知答案可以用来评分,但你确实知道每次运行使用了多少输出 token 和工具调用。这些会给你一个有用的运营信号。
每个级别下的正确运行都保持在明确的推理量下限之上。在 medium 及以上,每次正确运行至少使用 1,739 个输出 token,典型运行则使用数千个。一次没有进行任何工具调用、或产生的输出远少于其级别正常水平的运行,值得标记出来供审查:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
根据你已经评分的运行,按任务和努力级别校准基线,然后将其应用到尚未评分的运行上。把标记视为检查或重新运行的提示。在 low 下,每次运行都很简短,输出量是较弱的信号,因此要配合抽查。
在系统提示中要求 agent 验证其答案是值得保留的,因为这样在你审查一次运行时,agent 的推理会很容易跟进。在存在已知答案的地方,将其与自动评分配合使用,这样质量就能独立于对话记录来衡量。
选择推理努力程度
这些结果给出了几条实用规则。
让努力程度与任务类型相匹配。涉及搜索、优化或检验假设的任务从 medium 或更高级别中获益最多。遵循单一路径、或答案会在下游接受审核的任务,可以在 low 下高效运行。
按请求设置努力程度,而不是按 agent 设置。努力程度是一个请求参数,因此 agent 可以在更高级别运行其规划和验证步骤,而在 low 下运行其机械步骤,例如格式化工具结果。这样就把更高级别的大部分可靠性与更低的 token 成本结合了起来。
在你自己的任务上测量,并重复运行。每种配置只运行一次只能得到一个观测值。将每种配置重复运行多次,才能看出它有多稳定。
监控推理量。按 effort 级别跟踪每次运行的输出 token 数和工具调用次数,可以在结果被使用之前,提前获得需要复查某次运行的信号。
本次测量的局限性
每个任务和 effort 级别运行六次。足以在三个任务上显示出一致的方向,但不足以给出置信区间。请将级别之间的差异视为指示性结果。
合成环境。工具读取的是由代码生成的数据,正因如此才能证明每个任务恰好只有一个答案,并实现自动评分。真实工具会带来延迟、部分结果和错误,这些在此次测试中均未涉及。
以分钟计,而非小时。运行时间中位数从 low 的 18 秒到 xhigh 的 106 秒不等。这是长周期工作的缩小版代理。方法可以迁移,绝对数值则不能。
单一模型版本、单一区域、每个任务单一提示词。同一任务的不同措辞可能改变结果,这也是为什么明确陈述每条规则很重要。
统计的是 token 数,而非成本。要换算成货币,请根据 Amazon Bedrock 定价页面上适用于你的推理配置和服务层级的当前费率进行计算。Global 和 US Geo 配置的定价不同,Flex 和 Priority 服务层级还会应用乘数。
Agent 工作负载的运维控制
内置重试。发起大量调用的 agent 应将重试视为设计的一部分。设置请求超时,只重试可重试的错误,采用带抖动的指数退避,并在收到 Retry-After 响应头时遵循其指示:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
按需吞吐量会随时间逐步提升,因此新的高流量工作负载应逐步增加,而不是一开始就以全速运行。
审计一次运行。模型调用日志会将请求和响应数据写入 Amazon Simple Storage Service(Amazon S3)或 Amazon CloudWatch Logs。这样你就能获得想要事后复查的运行的完整记录。
大规模监控推理量。Amazon CloudWatch 指标提供 token 使用量的聚合视图,前面所述的各级别基线正是在这里变成可以设置告警的对象。
按 agent 归集支出。AWS Cost Explorer 和 AWS Cost and Usage Report 中的成本明细可按模型拆分用量,结合每个任务的 token 数,你既能得到单位经济性,也能得到总账单。
让成本与紧急程度相匹配。服务层级按请求设置,因此同一个部署可以将夜间分析通过 Flex 层级发送,将交互式请求通过 Priority 层级发送。对于以更高 effort 级别运行的工作负载,层级选择是进一步控制成本的杠杆。
选择路由配置。跨区域推理扩大了长时间运行可用的容量池。Global 配置从你选择的商业 AWS 区域提供服务,每 token 定价通常低于地理路由。US 配置将处理保留在美国境内。请根据你的数据驻留要求以及成本来选择。
清理
本文中的示例除了按请求计费的 token 用量外,不会创建任何产生费用的 AWS 资源。如果你生成了长期 Amazon Bedrock API 密钥,请在完成后于 Amazon Bedrock 控制台中将其删除,因为该密钥在被撤销之前一直有效。由 IAM 凭证生成的短期令牌会自行过期。
如果你在测试时启用了将模型调用日志记录到 Amazon S3,请检查该存储桶并删除不再需要的对象。
结论
SpaceXAI 训练 Grok 4.7 在更困难的任务上工作更长时间,并让它知道何时检查自己的工作。在三个需要搜索而非查找的任务中,该智能体在 72 次运行中正确回答了 67 次,且每次运行都在 xhigh。由于推理强度是按请求设置的,你可以选择智能体的每一步在彻底性与 token 成本之间的权衡中处于什么位置。
有三点值得带入你自己的评估中。设计具有一个可证明答案的任务,并说明评分器所依赖的每一条规则。重复运行,以便了解每种配置的一致性如何。并按推理强度监控输出 token 和工具调用,这样你就能在质量测量之外拥有一个运营信号。
延伸阅读
- 在 Amazon Bedrock 上推出 Grok
- Grok 4.7 现已在 Amazon Bedrock 上可用
- 使用跨区域推理在 AWS 区域之间路由模型推理请求
- Amazon Bedrock 入门
- Chat Completions API
- Amazon Bedrock 定价
- 推出 Grok 4.7 (SpaceXAI)
关于作者

Suheel Farooq
Suheel 是 AWS 的首席解决方案架构师,专攻人工智能、机器学习和生成式 AI。他帮助基础模型提供商客户在 AWS 上设计、构建、现代化和扩展其 AI/ML 与生成式 AI 工作负载——从将基础模型引入 Amazon Bedrock,到优化训练和推理,再到构建 Agentic AI 解决方案。他的经验涵盖 AWS AI/ML 和生成式 AI 产品组合,尤其是 Amazon Bedrock、Amazon Bedrock AgentCore 和 Amazon SageMaker AI。闲暇时,Suheel 喜欢健身和徒步。

Anirban Gupta
Anirban 是 AWS 的首席工程师,常驻美国西雅图,专注于为 Amazon Bedrock 设计安全、大规模模型服务基础设施。他推动了该平台上多个基础模型发布背后的技术工作。在加入 Amazon Bedrock 之前,他曾是 AWS Outposts 的首席工程师,构建混合本地云基础设施。

James Wang
James 是 SpaceXAI 的高级产品增长经理。此前,他曾担任 Cerebras 的产品营销总监,负责推出 Cerebras Inference 和 CS-3 AI 加速器。在那之前,James 是 ARK Invest 的首席 AI 分析师。他的职业生涯始于 NVIDIA,在深度学习早期推出了首批支持 CUDA 的 GPU。

Ikenna Izugbokwe
Ikenna 是 AWS 的首席解决方案架构师,专攻网络、容器和 AI 基础设施。他指导模型提供商扩展其训练和推理系统,同时支持在 AWS 上快速部署不断演进的前沿模型。他的工作日益涵盖智能体 AI——构建可靠、高性价比的多智能体系统及其背后的生产推理基础设施。