Qlik 如何用 Amazon Bedrock 构建企业级可信 AI
How Qlik built grounded, enterprise-scale AI with Amazon Bedrock
AI 导读
Qlik 基于 Amazon Bedrock 打造 Qlik Answers,为全球超 4 万家客户提供带来源引用的自然语言问答,2026 年 2 月正式可用后其 Discovery Agent 已为客户发现超 10 万条洞察。
正文· AI 翻译
在 Amazon Bedrock 上构建有据可依的 AI,Qlik Answers 解决了一个常见的企业难题:员工并不缺少数据,他们缺少的是一种快速的方式,能对数据提出真正的问题,并得到可信的答案。分析师们花费数小时翻阅文档、仪表盘和机构记忆,只为回答同事一句话就能提出的问题。而当组织试图用生成式 AI 来弥合这一差距时,许多组织都撞上了同一堵墙:答案没有来源、无法验证结果,也没有在受监管环境中部署该工具的路径。
Qlik 是数据集成、数据质量、分析和 AI 领域的全球领导者,它为全球 40,000 多家客户构建了 Qlik Answers 来解决这一问题。自 2026 年 2 月正式可用以来,Qlik Answers 已从一项早期能力转变为日常使用:仅 Qlik 的 Discovery Agent(一个 AI 驱动的异常与离群值检测代理)自推出以来就已为客户发现了超过 100,000 项发现,而启用了代理式工具的 Qlik Cloud 账户中,大多数都在积极使用这些工具。
本文介绍 Qlik 如何构建这一推动上述采用率的工具,以及 Amazon Bedrock 如何在全球规模上为其提供支持。
挑战
Qlik 确定了要将其客户群中的 Qlik Answers 投入生产,需要同时解决的三个问题:
- 编排专业化推理,同时不拖慢任何人。企业问题千差万别:有些需要快速查询,另一些则需要从结构化分析、非结构化文档、术语表定义或自动化中提取。单一的通用助手随着能力不断增加,往往会变得更慢、更不准确。
- 满足各区域的数据主权要求。Qlik 服务于欧洲、亚太和美洲的客户,每个地区都有各自的数据驻留期望。单一的全球部署模式无法满足这些要求,而 11 个独立的区域构建版本又难以一致地维护和改进。
- 提前数月预测模型容量。Token 消耗和模型可用性需要在重大发布前 3–6 个月进行规划。随后,Qlik 在客户开始使用产品后,用实际使用情况验证这些预测,这样采用率的增长就不会变成容量问题。
解决方案概览
Qlik Answers 为员工(而不仅是分析师)提供了一个统一的地方,可以用自然语言提问,并获得有据可依、带有来源的答案。根据问题的不同,答案可以来自知识库、实时分析应用、术语表定义或文档。底层系统会决定采用哪条路径。
三个部署案例展示了这对客户而言意味着什么:
- Bystronic 是一家全球钣金加工专家,它在 15 分钟内部署了一个 AI 聊天机器人,让员工能够查询实时运营数据,并获得跨部门的有来源答案。
- Lintech International 在 Qlik Answers 中索引了超过 17,000 份技术文档,减少了人工研究时间,并将响应时间加快了 75%,这为业务经理每周节省了多达 7 小时。
- TouchPoint Support Services 服务于 650 个医疗站点,并计划将规模翻倍,它使用 Qlik Answers 为在受监管、快节奏环境中工作的 15,000 名员工提供快速且符合合规要求的指导。
为了在规模化场景下支撑这一能力,Qlik 围绕清晰的架构边界而非单一大型助手来构建系统。关键分层如下:
- 入口层。Qlik Cloud 内一个稳定的对话入口,使新增后端能力时无需改变客户与助手的交互方式。
- 路由层。一个轻量层,读取用户消息和对话上下文,并决定请求应发往何处。它唯一的职责是快速、准确地做出路由决策,而非解决任务本身。
- 回答层。在请求完成路由后协调响应生成,在面向简单请求的快速路径与更审慎的路径之间做选择——后者会将问题拆解为子问题并从多个来源获取信息。
- 专家智能体层。共享的 swarm 运行时定义了专家智能体、工具、状态和人在回路步骤的运作方式,使新增专家无需各自发明编排模型。
- 对话式分析层。处理结构化数据问题,将其路由到专为分析而非通用文本生成构建的应用感知推理路径。
- 检索层。非结构化文档的索引与检索运行在 Amazon OpenSearch Service 上,该服务存储并搜索为 Qlik Answers 回答知识库和文档问题提供依据的内容。
- 模型访问层。通过 Qlik 自有的大型语言模型(LLM)网关访问,该层连接 Amazon Bedrock 以支持对话、流式传输、嵌入和重排序。它还会对每个请求和响应应用 Amazon Bedrock Guardrails:针对提示注入、个人身份信息(PII)、密钥和被拒绝话题的内容过滤,以及对生成答案的接地验证检查。当客户依赖的模型尚未通过 Bedrock 在区域内提供时,Qlik 会将其托管在 Amazon SageMaker AI 上,待区域可用性跟上后再将该工作负载迁回 Bedrock。有关各 AWS 区域的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域划分的支持模型。
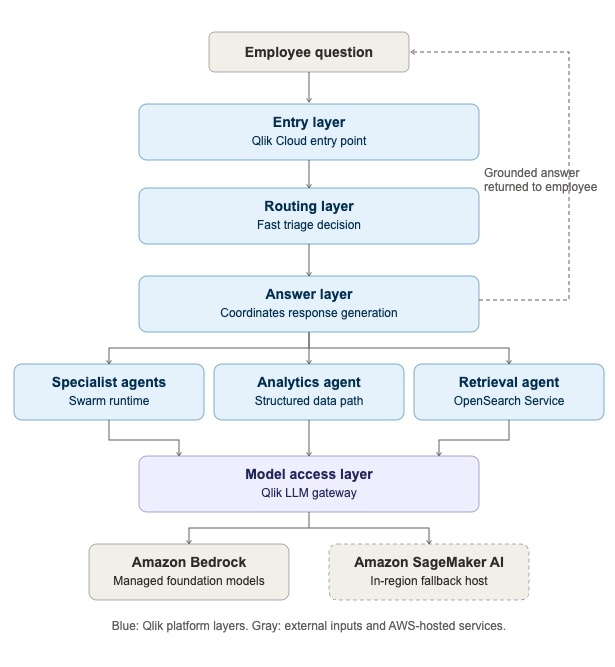
图 1:员工问题流经入口层、路由层和回答层,然后分支到专家智能体、分析智能体和检索智能体(由 Amazon OpenSearch Service 支持),再汇聚到模型访问层,该层访问 Amazon Bedrock 上可用的基础模型,并以 Amazon SageMaker AI 作为区域内回退方案
将答案建立在真实来源之上
接地是该框架中较为重要的设计决策之一。回答层会根据问题从多种上下文中获取信息:结构化应用元数据、检索到的知识库内容、术语表定义、自动化上下文,以及用于摘要的文档内容。在完整答案的各要素返回后,整个响应会被组装并呈现给用户。
仅靠检索并不能保证准确性。Qlik 还会对生成的答案执行接地验证检查,利用 Amazon Bedrock Guardrails 中的上下文接地能力,将每个答案与其所引用的源内容进行比对。这将接地从检索步骤转变为经过检查的生产控制。对于非结构化问题,该工具从 Amazon OpenSearch Service 检索特定问题的内容,并向前传递该上下文,使最终答案包含引用。对于结构化问题,它将工作交给对话式分析路径。更多能力(包括术语表查询、自动化和文档摘要)随能力控制一同推出,因此 Qlik 可以扩展该工具的功能,而不会同时破坏每位客户的默认体验。租户特定的能力选项意味着 Qlik 可以按请求重建可用的编排路径,从而可以选择性地开启能力,同时整体架构在所有客户之间保持一致。
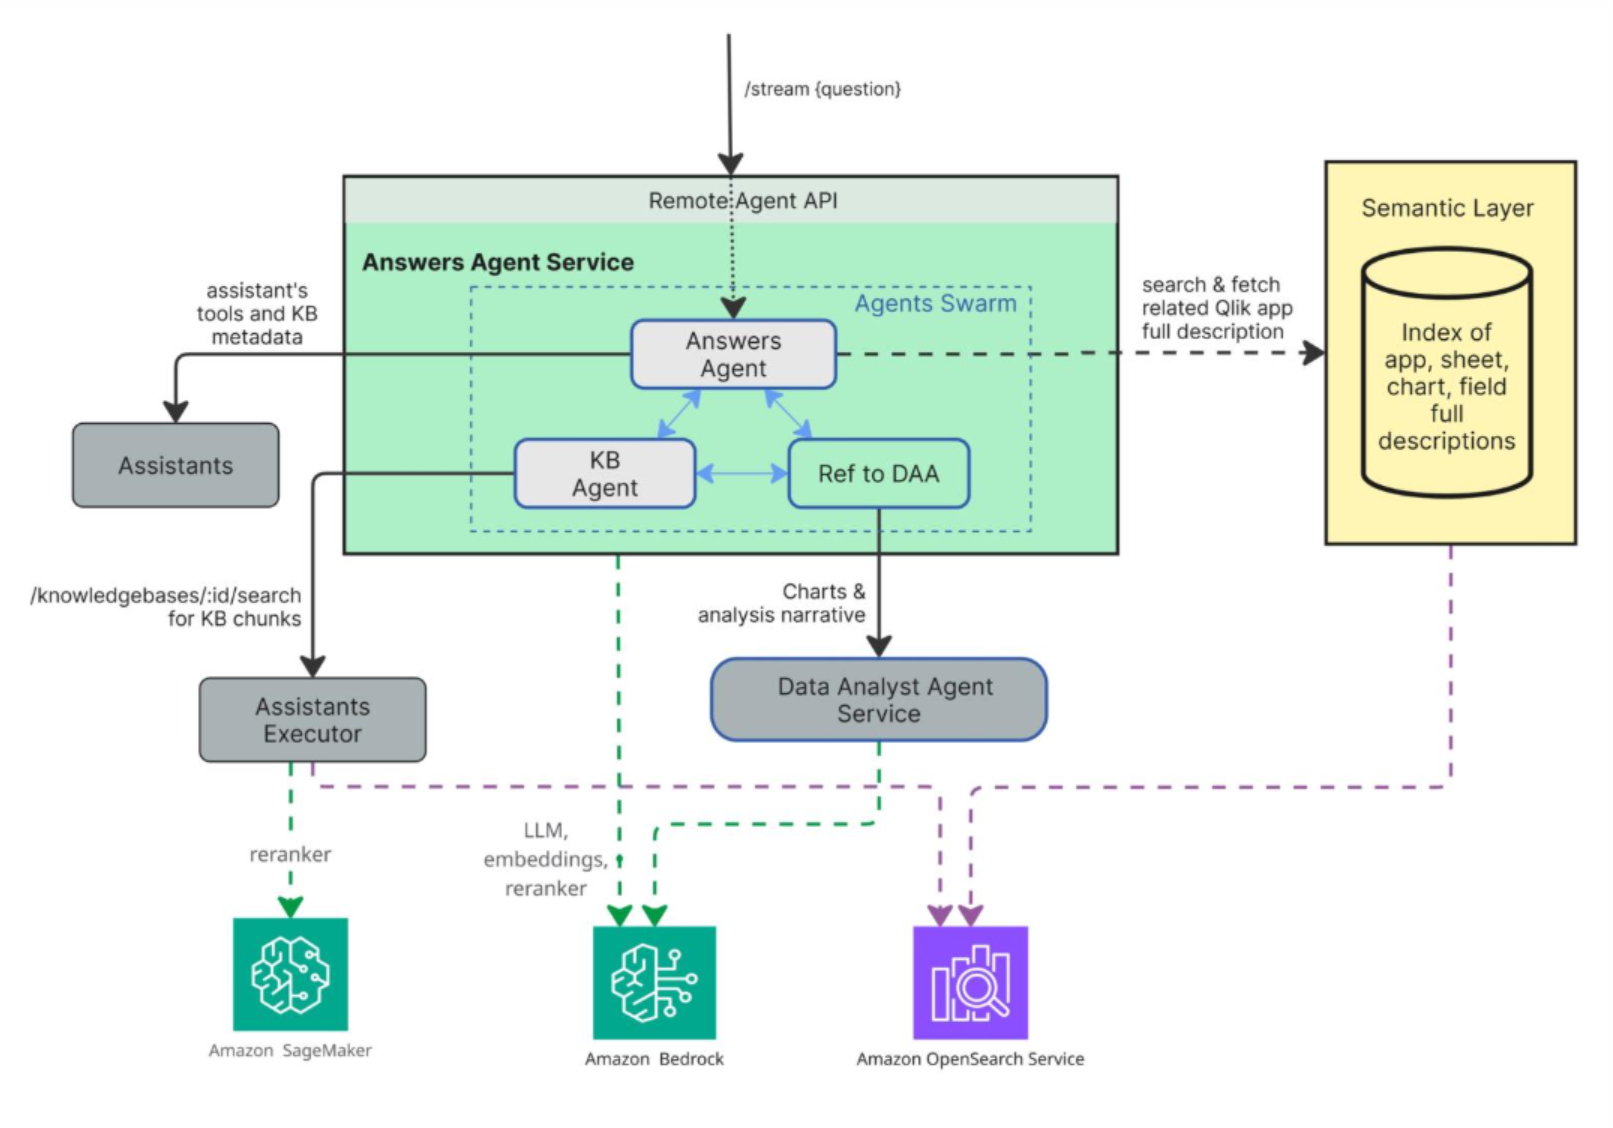
图 2:专家智能体集群,共享状态、工具和人在回路步骤让新的专家智能体接入通用运行时
为什么选择 Amazon Bedrock
Qlik 针对前面描述的三大问题评估了其模型策略,Amazon Bedrock 直接解决了每一个问题。
多模型灵活性。借助 Bedrock,Qlik 可以为每个智能体的任务分配最合适的模型,而不是将整个系统锁定在单一模型的权衡之下。
大规模数据主权。借助 Amazon Bedrock 跨区域推理(CRIS),Qlik 可以在全部 11 个区域提供服务,同时将数据保留在合规要求所在的位置。这将全球覆盖与主权控制结合在单一托管能力中。
选择性采用托管服务的空间。AWS 区域部署模型和容量预留选项为 Qlik 提供了今天持续扩展的余量。准备就绪后,Amazon Bedrock AgentCore 等服务让 Qlik 可以选择为特定工作负载卸载更多运维开销,而无需为此进行完整迁移。
Qlik 通过自己的 LLM 网关使用 Bedrock,而不是将应用逻辑直接绑定到某一个模型。产品团队可以按任务更改模型选择,而无需重写周边应用。对于预期模型策略将持续演进的系统而言,这种分离至关重要。
提前规划容量
由于 Qlik 在重大发布前 3–6 个月预测模型容量,团队构建了一个工作模型,按功能和区域预测 token 消耗,然后在每次推出后对照这些预测检查实际使用情况。这种纪律是 2 月正式可用版本在自身采用率下扩展而未承压的部分原因。
业务成果与客户影响
自 2026 年 2 月 Qlik 的智能体体验正式可用以来,Discovery Agent 已为客户呈现超过 100,000 项发现,并且大多数启用了智能体工具的 Qlik Cloud 账户正在积极使用其智能体,而不是尝试一次就停止。
单独报告的客户级成果包括Lintech International 的响应时间加快 75%,每周为业务经理节省最多 7 小时,以及Bystronic 的 15 分钟聊天机器人部署。
经验教训
在超过 40,000 家客户中构建和扩展 Qlik Answers 的过程中,我们总结出一些经验,或许能帮助其他在 Bedrock 上构建智能体工具的团队:
- 尽早将快速路由与深度推理分离。将二者捆绑在一起,意味着每个请求都要付出超出其所需的处理开销。
- 为多智能体执行统一采用一个编排框架,而不是让每个新的专用智能体自行发明运行时。运维一个应用比运维一组彼此割裂的智能体系统更容易。
- 将安全与依据性检查视为系统级关卡,而不是每个功能的事后补充。在模型访问层统一运行一次,意味着每个新的专用智能体都会自动继承相同的保护措施。
- 在租户级别使用功能开关来逐步扩展能力。这样可以避免新的、尚未充分验证的能力影响核心体验的可靠性。
- 在需要之前就养成容量预测的习惯。每次发布后,将预测用量与实际用量进行核对,正是这一步让容量规划从猜测变为可重复的流程。
下一步
Qlik 的路线图刻意保持架构的开放性和适应性。团队正在评估将 Amazon Bedrock AgentCore 用于部分工作负载,在这些场景中,托管式智能体运行时能够降低运维开销;同时,在能够为 Qlik 带来更多成本、延迟或可移植性控制的地方,继续基于开放标准和自有编排层进行构建。目标是保留在托管服务确有帮助时采用它们的选项,同时又不围绕任何单一服务来设计框架。Qlik 还在构建一个用于评估模型性能的系统化框架。这意味着 Qlik 可以在出现更合适的模型时迁移过去,而不会干扰客户已经依赖的体验。
结论
Qlik Answers 自 2026 年 2 月发布以来的采用情况,反映出一套刻意“不挡路”的架构:在速度重要的地方快,在准确性重要的地方审慎,全程以真实来源为依据,并且足够安全,足以让受监管行业放心依赖。Amazon Bedrock 中的模型灵活性、区域主权控制,以及基于 Guardrails 的内容过滤和依据性验证,为 Qlik 提供了在全球范围内构建这一体验的基础。迄今为止的成果包括:呈现了超过 100,000 项发现,为 Lintech 和 TouchPoint 等公司的员工节省了数小时时间,并且大多数启用了智能体工具的账户在试用后继续使用其智能体。
要了解 Qlik Answers 能如何利用你的数据,请开始 Qlik Cloud Analytics 免费试用,申请 Qlik Answers 演示或 Qlik 与 AWS 演示,或访问 Qlik Answers 产品页面了解更多信息。
关于作者

Sunil Yerkola
Sunil 是 AWS 的高级解决方案架构师。他为独立软件供应商(ISV)客户提供支持,帮助他们构建高度可扩展、成本优化的云解决方案。Sunil 已在 AWS 工作超过 4 年,帮助客户在 AWS 上迁移和扩展其基础设施。Sunil 喜欢与家人和朋友共度时光,也喜欢观看或参与体育运动。

Sathisan Vannadil
Sathisan 是 AWS 的高级合作伙伴解决方案架构师,通过平台战略和生态系统领导力,帮助领先的数据与 AI ISV 在 AWS 上大规模设计和运营企业 AI 系统。

Kent McLean
Kent 是 Qlik 的工程高级总监,负责支持为 Qlik 的客户和合作伙伴提供预测式 AI 和生成式 AI 解决方案的团队。Kent 热衷于组织和构建能够在任何规模下放大价值的系统。Kent 将他对创造和构建的热爱延伸到家中和社区里的爱好与项目之中。