Amazon SageMaker AI 上的 MoE 内核工程优化实践
Mixture-of-Experts kernel engineering on Amazon SageMaker AI
AI 导读
针对 MoE 模型在解码阶段因 token 批量过小导致 Hopper GPU 利用率低的问题,AWS 通过 Swap-AB 转置让专家维度 N=8192 占据 WGMMA 首个操作数位置,在 H200 上为大规模 MoE 模型带来 2–4% 端到端输出吞吐提升,该优化已合入 vLLM 0.24.0 及以上版本。
正文· AI 翻译
Mixture-of-Experts(MoE)是一种稀疏激活架构,它能在保持单 token 计算量较低的同时扩展大语言模型(LLM)的容量。由于其运算在总计算时间中占很大比例,这里的低效会直接提高请求延迟和成本。因此,通过内核工程优化 MoE 运算,是获得性能提升的最大机会。
Fused MoE 是 MoE 架构的一项关键优化技术。融合 MoE 系统将 token 路由、数据重排和专用网络计算合并为 GPU 上的单一批处理操作。这取代了将那些路由和专家计算作为独立的顺序循环操作来执行的方式。虽然这带来了延迟优势,但也带来了内核实现和调试能力方面的复杂性。该架构要实现高 GPU 利用率,需要针对硬件的特定优化。
在这篇文章中,我们介绍了为融合 MoE 模型实现的不同内核优化,并展示你如何从这项工作中受益。我们使用一个有代表性的 MoE 模型作为主要示例。
Swap-AB 以提升 WGMMA 利用率
为了最大化张量处理吞吐量,NVIDIA Hopper 架构依赖 Warp Group Matrix Multiply Accumulate(WGMMA)指令协议,该协议在由 128 个线程组成的协作 warpgroup 上集体执行。这种操作数不对称本质上是指令集架构(ISA)层面的属性。在底层的 wgmma.mma_async 汇编定义中,硬件将矩阵行维度(M)固定为常数 64,以定义其并行线程映射拓扑。列维度(N)则保持高度可变。操作数 A 严格映射到这个固定的 M 维度上(使用寄存器或共享内存),操作数 B 则通过共享内存描述符映射到可变的 N 维度上。因此,这些操作数槽位在结构上不可互换。 consequently,峰值硬件 tile 利用率受这些刚性形状编码的支配,要求 M 维度等于或超过 64,以防止计算执行通道处于空闲状态。
这种结构性偏好源于 Hopper Tensor Cores 划分内存块的方式。硬件对第一个操作数的主维度强制实施固定的最小布局形状,将块高度锁定为恰好 64(M=64)。当一个数学矩阵在这个主槽位中具有较大且连续的主维度时,Hopper 的内部硬件调度器可以清晰地将数据映射并分布到物理计算网格上。
这种结构性不对称在 MoE 网络的解码阶段成为严重的性能瓶颈。在标准 MoE 层中,支配专家计算的线性代数使用传统矩阵记法表示:
A[M,K] x B[K,N] —> C[M,N]
其中(M)表示 token 行数(或批大小),(K)表示隐藏特征维度,(N)表示扩展的专家输出维度。
在解码阶段,系统一次只处理每个用户序列的一个 token。因此,批空间或 token 行大小非常薄,通常会降到(M < 64)的情况,并且经常低至单行(M = 1)。在这种标准结构布局下:
矩阵(A)变成一个薄的、碎片化的水平向量(例如,1 x 4096)。
矩阵(B)(核心专家权重)保持为一个大而密集的垂直块(例如,4096 x 8192)。
由于行数(M)极小,矩阵(A)在物理上无法填满硬件为操作数 A 固定的(64)行布局桶。当 WGMMA 指令在此布局上执行时,物理 Tensor Core 容量的大部分会完全处于饥饿状态。芯片会花费时钟周期处理空的空间槽位,导致硬件利用率低下。
在标准的稠密 LLM 层中,权重矩阵是静态的、统一的,并且完全连续。然而,在 MoE 层中,工作负载被分散到一组独立的子网络(专家)上。这造成了独特的内存和布局瓶颈,使其对 Hopper GPU 的 WGMMA 约束极为敏感。在标准稠密层中,矩阵乘法是将一个 token 向量与单个层权重矩阵相乘。输出维度(N)是模型的隐藏大小(例如 4096)。
在 Fused MoE 内核中,GPU 并非只与一个专家进行乘法运算。它会同时对所有活跃专家进行分组并运行数学运算,以避免为每个专家启动单独的内核。对于标准稠密层,N 是隐藏大小(4,096)。对于融合 MoE 层,N 是所选专家数量乘以专家中间大小。对于运行 topk=8 例程的模型,融合内核内部的有效 N 维度会膨胀到数万或数十万个参数。由于 N 维度与极小的解码 token 大小(M=1)相比如此不成比例地大,布局不对称性变得极端。转置矩阵会将这个巨大的、合并的 MoE 维度移入主槽位,从而以标准稠密层无法匹敌的规模解锁硬件预取。
为了在不改变模型底层数学完整性的情况下解决这种硬件错位,我们利用矩阵转置的代数性质:
BT[N,K] x AT[K,M] —> CT[N,M]
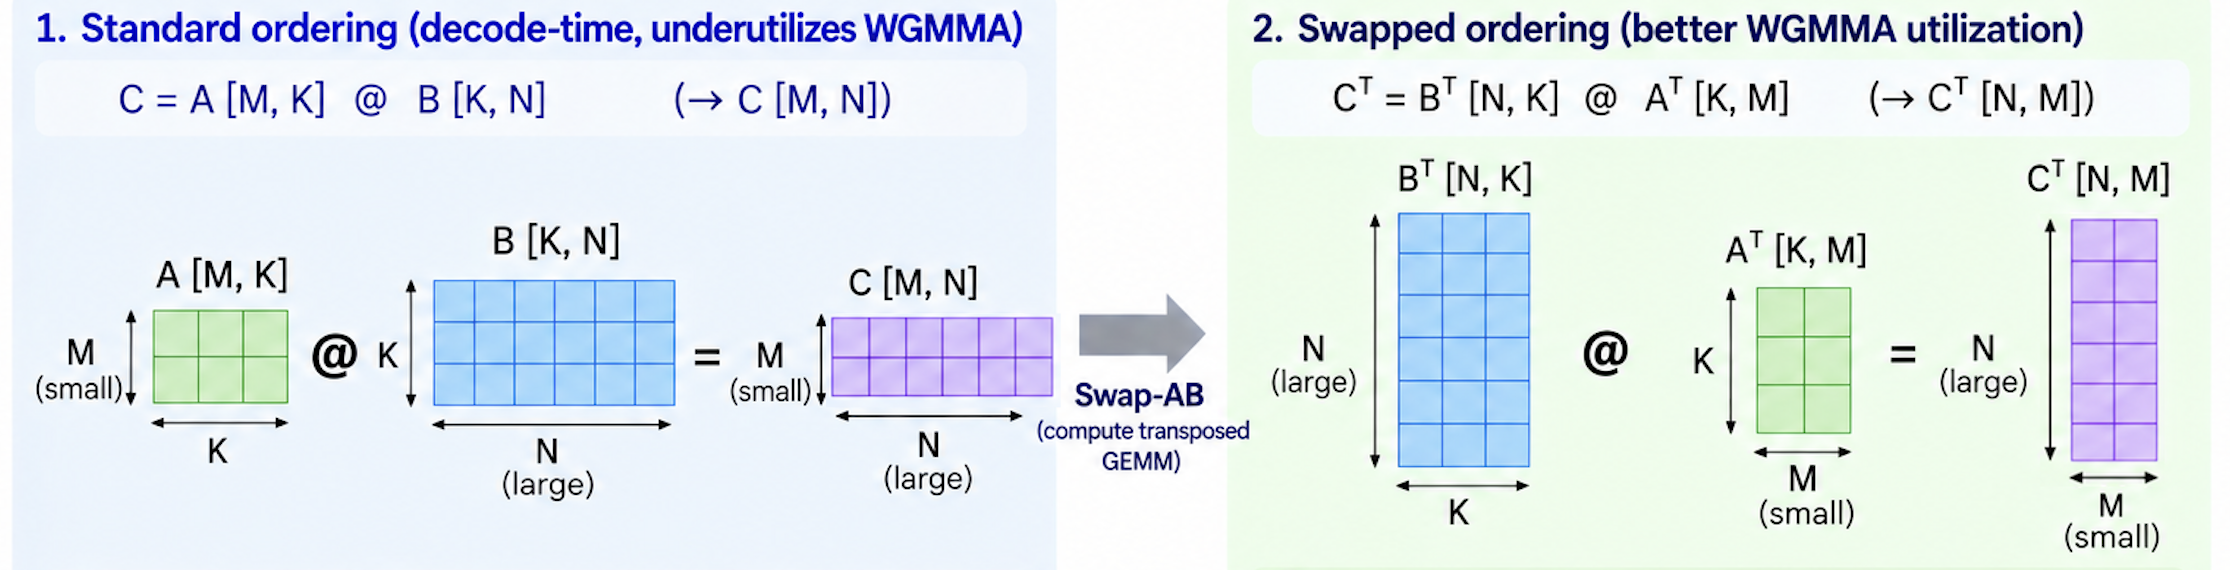
图 1:用于 WGMMA 利用率的 Swap-AB
通过在矩阵乘法到达 PTX 汇编层之前以编程方式翻转它,我们重新调整了软件,使其与 Hopper 芯片的精确地形相匹配。这种转置在 GPU 上触发了两个直接的架构优势。首先,它使物理布局饱和。庞大的专家维度(N = 8192)被提升到第一个操作数位置(BT),并且由于(N)很大,它很容易淹没硬件强制要求的(64)行阈值。然后 Tensor Core 以最大局部密度运行,没有浪费的执行周期。其次,它激活了异步预取。Hopper 专用的硬件复制引擎可以在数学执行块触发之前,异步地将内存地址从共享内存直接预取到寄存器中。将连续的大权重块(BT)放在前导槽位,可以让这些引擎平滑地追踪数据布局,并在无需 CPU 干预的情况下保持计算流水线饱和。这在 H200 上的大规模 MoE 模型中带来了 2–4% 的端到端输出吞吐量提升。我们已将这项优化上游到 vLLM,它可在 0.24.0 或更高版本中使用。
FP8 张量量化的后端路由
除了内核内部实现之外,选择哪个后端来执行 MoE 计算也会对性能产生很大影响。vLLM 的 MoE oracle 会将不同的量化方案路由到 Triton、FlashInfer+CUTLASS 或其他后端。性能分析显示,对于 Hopper 上的 FP8 张量量化模型,Triton 后端始终优于默认的 FLASHINFER_CUTLASS 路径。
Triton 后端在低并发 MoE 工作负载中优于 CUTLASS,主要是因为它用自定义的算子级寄存器融合取代了僵化的框架级矩阵数学配置。CUTLASS 依赖标准 C++ 模板结构,将 FP8 张量缩放、矩阵乘法和专家聚合视为离散的数学运算。而 Triton 后端则将整个流水线整合为一次硬件执行过程。数据仅从全局高带宽内存(HBM)中读取一次,完全在 GPU 超快的本地 SRAM 寄存器和计算执行文件中处理,然后再流式写回最终矩阵目标位置。这消除了缓慢的全局显存读写往返,而 CUTLASS 在被迫不断执行中间张量缩放步骤时,正是受困于这种往返开销。
此外,这种寄存器级融合还专门搭配了围绕可变 token 分桶设计的动态调度布局,解决了传统编译模板中的一个严重结构性缺陷。CUTLASS 原生针对稠密、大型且可预测的矩阵维度进行优化。当它遇到实时解码生成阶段典型的流动、超薄批次配置(M < 64 或 M = 1)时,其默认的块分块和线程映射结构会变得极其低效,导致严重的 warp 利用率不足或高昂的内存填充开销。相反,Triton MoE 后端擅长将这些小而碎片化的 token 数组动态映射到活跃专家权重的物理边界上。即使在极低批次大小下处理高度不稳定的工作负载,这也能让硬件的内部预取流和 Tensor Core 流水线保持完全饱和。
更新路由策略只是纯配置变更,无需修改任何内核代码。尽管如此,它仍为 H200 上的 FP8 量化融合 MoE 模型带来了端到端吞吐量提升 10%。这一改进已在 AWS 大型模型推理(LMI)v28 容器中提供。
消除 Triton JIT 重编译
GPU 推理中最具影响力的性能问题之一,也是最不显而易见的问题之一:不必要的内核重编译。Triton 是 vLLM 许多自定义内核所依赖的编译器框架,它默认会对整数参数进行特化。每当内核以某个特化参数此前未见过的值被调用时,Triton 就会触发一次新的即时(JIT)编译。在序列长度和批次大小持续变化的服务工作负载中,这会产生源源不断的编译开销,从而推高延迟,尤其是首 token 时间(TTFT)。
在 MoE 模型服务中,_fused_inv_rope_fp8_quant_per_head 内核(负责融合旋转位置嵌入和 FP8 量化)会在每个新的 num_tokens 值出现时重新编译。为可变长度参数添加 do_not_specialize 注解后,这些重编译被完全消除,在 H200 上以 8 路张量并行运行时将 TTFT 提升了 9%(PR #42849)。
在多 GPU 集群中,全部 8 块 GPU 必须以完美的微秒级同步执行各自的内核。如果哪怕有一块 GPU 因为其本地 token 批次数量发生变化而必须停下来重新编译本地的 _fused_inv_rope_fp8_quant_per_head 内核,其余七块 GPU 就会空转等待它。通过消除整个集群范围内的重新编译,我们消除了多 GPU 协调开销,使用户的首次响应延迟获得了 9% 的加速。这里的原则是把编译器当作一等优化面。理解 Triton 如何特化语义,并识别参数何时是死参数或可变参数,就能以极少的代码改动释放延迟改进。
我们已将这项优化上游贡献给 vLLM,它在 0.22.0 或更高版本中可用。
结论
通过与 vLLM 社区的合作,我们为融合 MoE 模型实现并开源了多项内核优化。我们在 Amazon SageMaker AI 上的 LMI Deep Learning Container 中应用了这些优化。这些优化共同带来了最高 10% 的吞吐量提升和最高 9% 的 TTFT 加速。要开始使用自定义模型托管,请参阅 Amazon SageMaker AI 托管文档。
关于作者

Mona Mona
Mona 是 AWS 的专家解决方案架构师,专注于机器学习基础设施和 AI/ML 服务。她帮助客户使用 Amazon SageMaker 设计和优化其 ML 流水线。

Sadaf Fardeen
Sadaf 是 SageMaker、HyperPod 和 Amazon Bedrock 推理优化项目的 SDM。她的团队为开源大语言模型开发 GPU 性能优化,并且是 vLLM 的活跃贡献者。Sadaf 还领导模型服务器和优化 GenAI 推荐服务的开发。

Xin Yang
Xin 是 AWS 的高级软件开发工程师,专攻大规模深度学习推理和性能优化。她致力于构建和优化大语言模型的模型服务系统,重点关注 GPU 性能、分布式推理以及 vLLM 等开源技术。