在 Amazon SageMaker AI 上用 Kokoro TTS 为 AI 智能体流式输出低延迟语音
Stream low-latency speech from AI agents using Kokoro TTS on Amazon SageMaker AI
AI 导读
在 Amazon SageMaker AI 上托管的 Kokoro-82M 文本转语音模型可让 AI 语音智能体按句流式合成,第一句生成后即开始播放,无需等整段回复完成。
摘要与补充说明
Kokoro-82M 仅 8200 万参数,可跑在单台 ml.g5.xlarge GPU 实例上,从而压低延迟与推理成本。容器暴露 POST /invocations 与 WS /invocations-bidirectional-stream 两条路由,分别对应单次完整输入和跨多条消息的双向长连接。
正文· AI 翻译
客户向 AI 语音代理提出一个问题,然后等待。代理其实已经有了答案,正在生成一段很长的多段式回复,但客户在五秒钟内什么也没听到。等答案终于到来时,客户已经感到沮丧、困惑,也不再关注了。
文本转语音集成恰恰制造了这样的空档。一句回复可能在 600 毫秒内生成,但完整回复需要五秒钟,而集成会等全部内容生成完毕才开始合成。
本文介绍如何弥合这一空档。代理每生成一句话,我们就立即将其流式传输到 Amazon SageMaker AI 上托管的 Kokoro-82M 文本转语音(TTS)模型,因此合成从第一句就开始,而不是等到整个回复完成。把音频传回浏览器也需要专门的方案,因此我们还会介绍实现这一点的两种传输方式,以及它们在实际使用中的各自代价。
解决方案概述
该方案通过让合成与生成并行流式进行,而不是等待生成完成,来弥合这一空档。代理每生成一句话,该句就立即流式传输到托管的 Kokoro-82M 文本转语音模型,因此音频播放可以在代理说完完整回复之前就开始。Kokoro-82M 仅有 8200 万参数,小到可以在单台中端 GPU 实例上低成本运行。这使处理真实流量的语音代理能够同时保持低延迟和低推理成本。
Kokoro-82M 运行在 SageMaker AI 实时端点上的自定义容器中,部署于 ml.g5.xlarge GPU 实例。该容器暴露两条路由:POST /invocations,针对单个完整输入流式返回响应;以及 WS /invocations-bidirectional-stream,在双向通信中通过一条连接承载多条消息。
下图展示了从客户端到模型的请求路径:
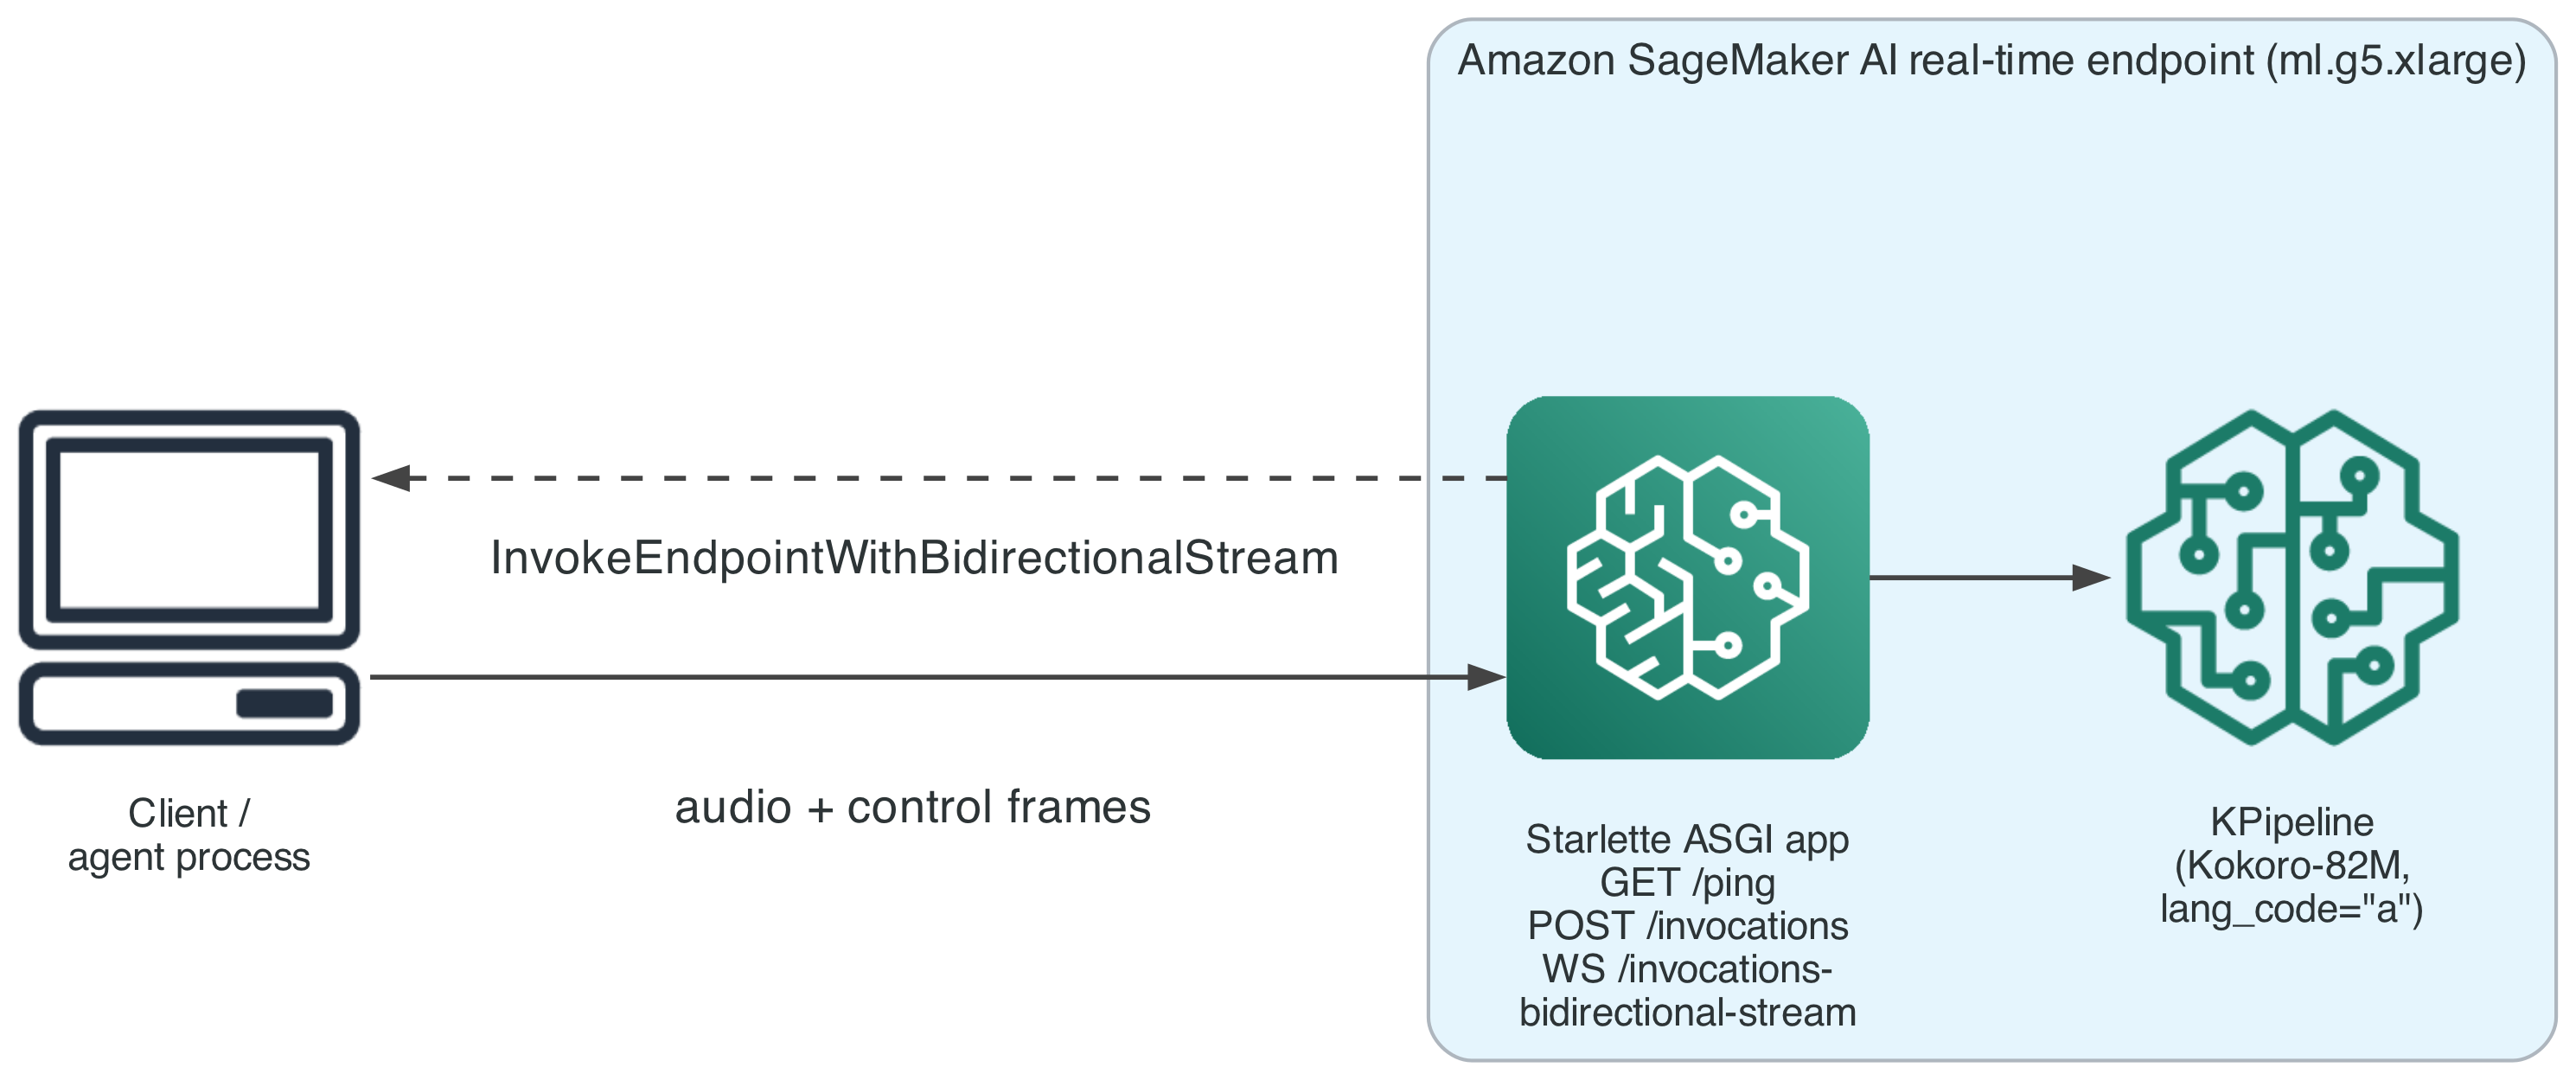
图 1:客户端通过双向流到 SageMaker AI 实时端点的请求路径
先决条件
开始之前,你需要:
- 一个 AWS 账户,具有创建 SageMaker AI 端点、AgentCore 运行时(Amazon Bedrock AgentCore 的一项能力)、AWS Identity and Access Management(IAM)角色以及 Amazon Elastic Container Registry(Amazon ECR)仓库的权限,至少包括
sagemaker:CreateEndpoint、sagemaker:CreateEndpointConfig、sagemaker:CreateModel、sagemaker:InvokeEndpointWithBidirectionalStream和bedrock:InvokeModelWithResponseStream操作。 - 示例容器固定使用了一个带有已知安全公告的旧版 PyTorch(
PYSEC-2026-2286,已在 torch 2.10.0 中修复)。在任何非概念验证用途之前,请审查并升级该固定版本。 - AWS Cloud Development Kit (AWS CDK) v2,已在目标账户和 AWS 区域中安装并完成引导。
- 一个从声明了
com.amazonaws.sagemaker.capabilities.bidirectional-streaming=trueDocker 标签的容器部署的 SageMaker AI 实时端点。 - Python 3.12 或更高版本、uv 以及 Docker,用于构建容器镜像(底层 HTTP/2 客户端仅为 Python 3.12 及更新版本提供预构建 wheel)。
- 支持
invoke_endpoint_with_bidirectional_stream的 AWS SDK for Python(Boto3)。 - 熟悉 WebSockets 和 Starlette 或类似的 ASGI 框架。
- 本文引用的 GitHub 仓库 中的部署代码。
操作步骤
本操作步骤首先部署端点和代理,然后逐步介绍客户端侧的改动,使增量流式传输能够端到端工作。
部署端点和代理
Kokoro-82M 端点和代理运行时通过两个 CLI 工具部署,每个工具封装各自的 AWS CDK 堆栈:
uv run speech-infra deploy kokoro-82m
uv run agent-infra deploy --bedrock-model-id <your-bedrock-model-id>
speech-infra deploy 负责配置 Kokoro-82M 端点。这包括基础栈和模型缓存栈,它们创建底层 IAM 角色,并将模型权重同步到 Amazon Simple Storage Service(Amazon S3)。随后,端点栈构建容器镜像,并创建 SageMaker AI 模型、端点配置和端点。agent-infra deploy 负责配置托管 Strands agent 的 Amazon Bedrock AgentCore 运行时,该运行时调用你刚刚部署的端点,因此请先部署端点。
第 1 步:处理 SageMaker AI 实际发送的 WebSocket 帧类型
SageMaker AI 使用的双向传输会将客户端消息的每一部分以二进制 WebSocket 帧的形式发送到你的容器。编写 Starlette WebSocket 处理程序的一种常见方式是调用 receive_text(),它会读取 message["text"],如果该键不存在则抛出 KeyError。由于此客户端发送的每条消息都以二进制形式到达,该处理程序会在每个请求上失败。
这种故障常被误诊。一个将 str(e) 转发给客户端的通用异常处理程序会把 KeyError('text') 变成一条错误帧,内容为 'text',看起来像是缺少字段,而不是帧格式问题。端点本身始终报告 InService,因为它接受连接并响应每条消息,但每次都会出错。
应显式接受任一帧类型,而不是假设只会出现其中一种:
from starlette.websockets import WebSocket, WebSocketDisconnect

async def _receive_message(websocket: WebSocket) -> str:
    message = await websocket.receive()
    if message["type"] == "websocket.disconnect":
        raise WebSocketDisconnect(message.get("code", 1000))
    payload = message.get("text")
    if payload is None:
        payload = message.get("bytes", b"").decode("utf-8")
    return payload
当没有文本字段时,这段代码会将字节按 UTF-8 解码,而不是假设只有一种帧类型。通过发送二进制帧来测试它,因为这种故障模式会产生格式正确的错误帧和健康的端点状态,而不是明显的崩溃。
第 2 步:在消息之间保持会话打开
当你的容器完成一条消息的音频合成后,本能反应是关闭会话,就像 HTTP 周期结束那样。但在这里这是错误的。在发送一条消息的音频和一个 synthesis_complete 控制帧之后,容器循环应回到等待 receive(),以在同一仍然打开的会话上接收下一条消息。仅当客户端发送显式的 {"type": "close"} 消息时才关闭连接。
下图展示了一个会话按顺序承载两个句子,仅在最后关闭:
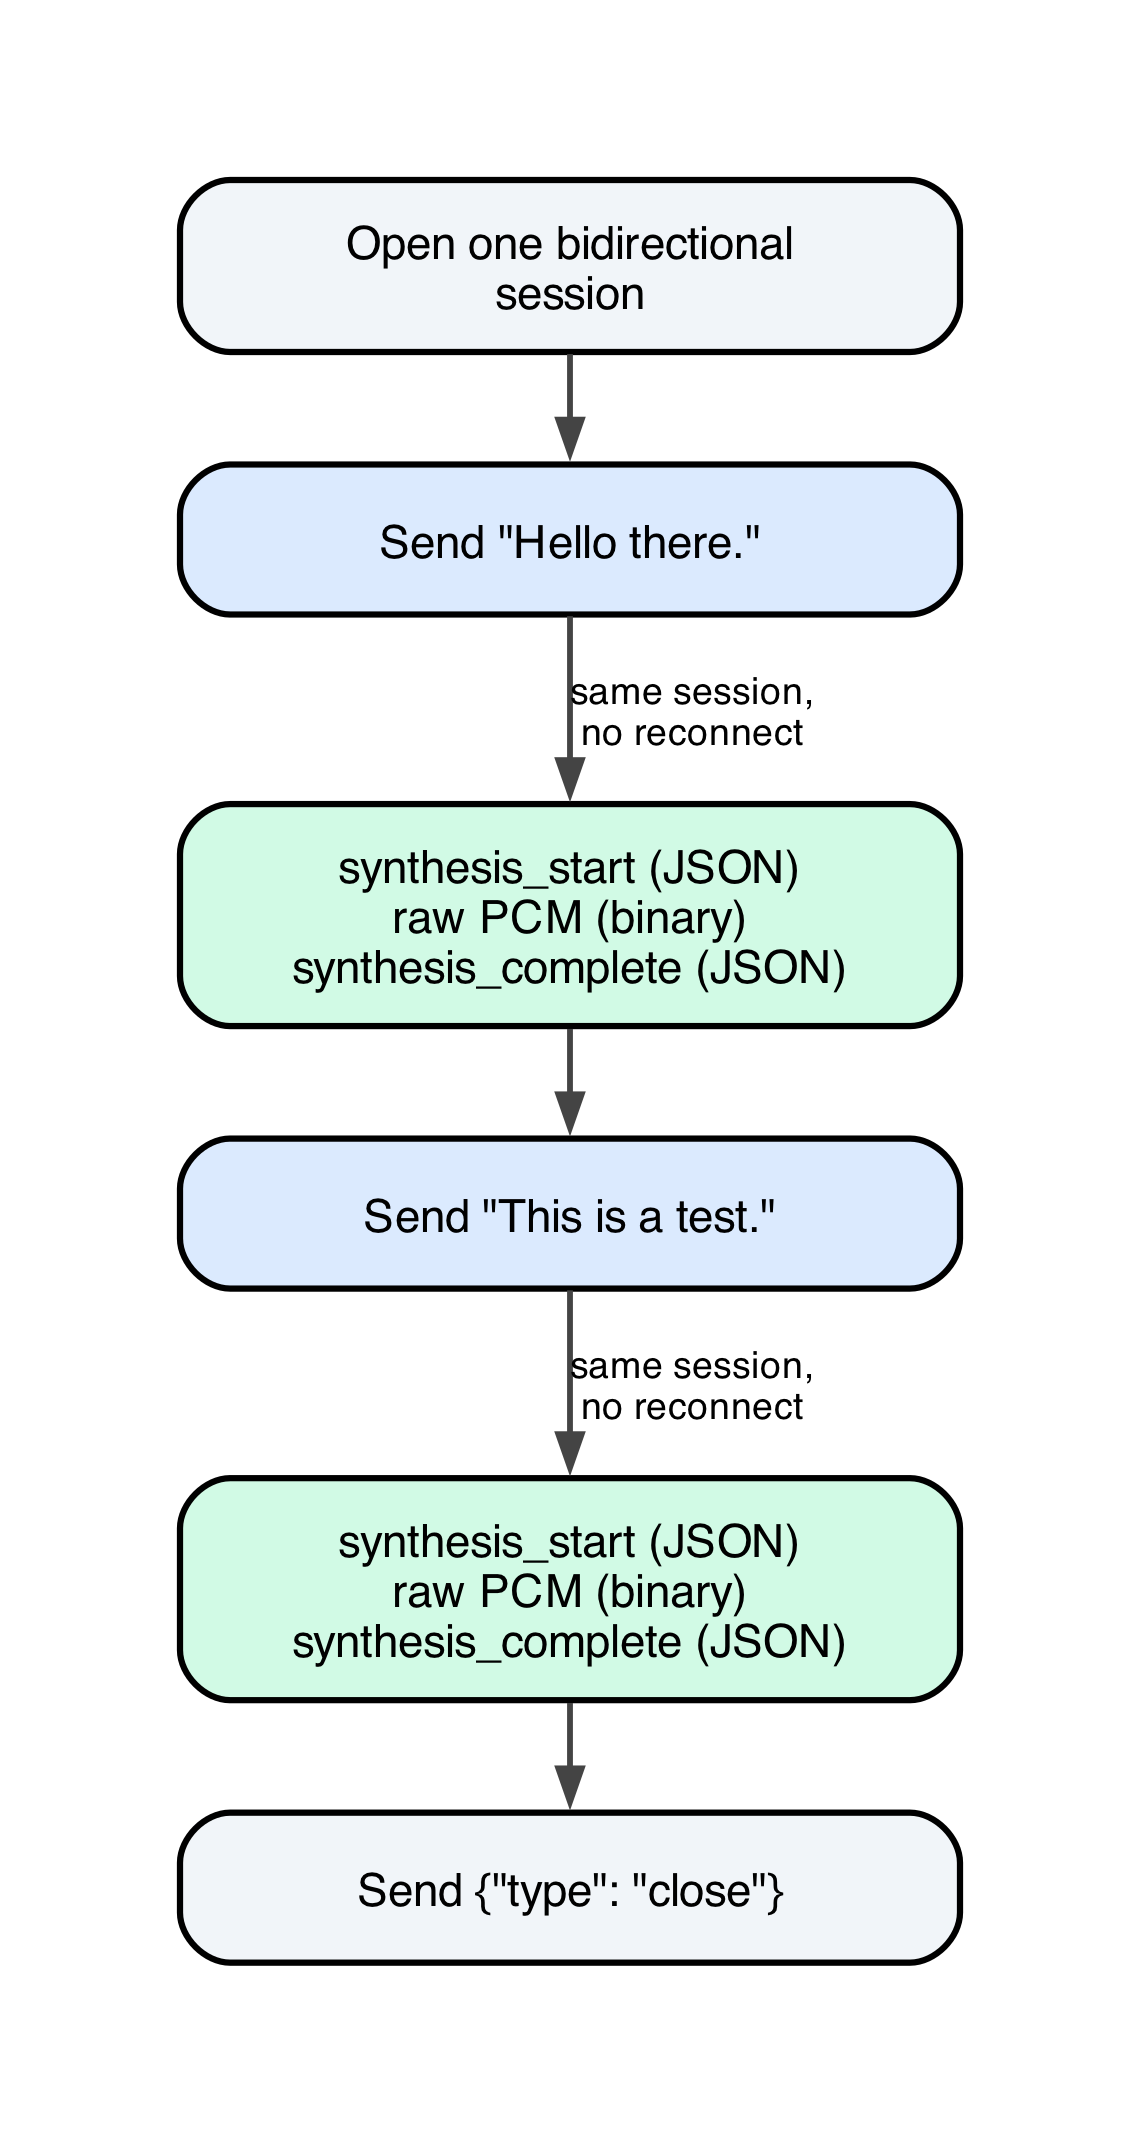
图 2:一个双向会话按顺序承载两个句子,仅在最后关闭
这样,你可以在一个持久会话上依次发送多个句子,而无需在它们之间重新连接。在一次响应后急于关闭会迫使每个句子都建立新连接,从而抵消大部分延迟优势。
第 3 步:在 agent 生成句子时流式发送
会话行为就位后,针对延迟问题的客户端修复方案是一个类,它规范化两种形式的文本:预先已知的完整字符串,或实时 token 流。无论哪种方式,它都产生相同的输出:完整句子,一旦每个句子完成即可发送。
import re

_SENTENCE_RE = re.compile(r"(?<=[.!?])\s+")


class IncrementalSentenceChunker:
    def __init__(self) -> None:
        self._buffer = ""

    def feed(self, fragment: str) -> list[str]:
        self._buffer += fragment
        parts = _SENTENCE_RE.split(self._buffer)
        if len(parts) == 1:
            return []
        self._buffer = parts[-1]
        return [s.strip() for s in parts[:-1] if s.strip()]

    def flush(self) -> str | None:
        remainder = self._buffer.strip()
        self._buffer = ""
        return remainder or None
每当一段文本到达时,调用一次 feed()。它返回任何新完成的句子,并保留尾部文本。在输入结束时调用一次 flush(),以释放即使没有尾部标点也仍然存在的部分文本。这样可以防止在句号到达之前就结束的流丢失最后一个句子。
这不是并发合成。每个双向处理器都是一个严格串行的循环:接收一条消息,合成其音频,发送该音频,发送synthesis_complete,然后接收下一条消息。第二句的音频不会在第一句仍在传输时生成。增量发送带来的好处更有限:第一句的合成在它一出现时就开始,而不是等待完整响应。对于首句和末句之间具有真实生成时间的多句响应来说,这就是全部的延迟收益。
我们在一个实时端点上验证了这一点,在单个会话中发送了一个三句输入。三个分块到达时,其音频与各自发送的文本相匹配:
| 分块 | 文本 | 音频字节数 | 时长(秒) |
| 1 | “Hello there.” | 73,200 | 1.525 |
| 2 | “This is a post deployment check.” | 108,000 | 2.250 |
| 3 | “It has three sentences.” | 98,400 | 2.050 |
第 4 步:选择一种将音频传回客户端的传输方式
将文本增量流式传入模型解决了问题的一半。另一半是将生成的音频输出到任何渲染它的地方,通常是浏览器。大多数智能体和聊天前端已经通过 Server-Sent Events(SSE)流式传输文本:单向,且大多数浏览器原生支持。SSE 是一种文本协议,并非为承载原始二进制载荷而构建。为现有 SSE 管道添加语音的团队自然会采用已有的模式:对音频进行 base64 编码,并将其包装在 JSON 事件中。
我们在 24 个片段上测量了该方法的成本,通过 Amazon Transcribe 确认不同编码之间的质量没有差异,并比较了 MP3 与 AAC:
| 候选方案 | 原始字节数 | Base64 字节数 | 比特率 |
| 原始 PCM | 2,396,400 | 3,195,200 | 384 kbps |
| MP3 48k | 308,304 | 411,072 | 49.5 kbps |
| AAC 32k fMP4 | 258,039 | 344,084 | 41.6 kbps |
Base64 会使每个载荷膨胀接近预期的 33%。更微妙的成本是帧对齐。SSE 事件以空行分隔,但其中的音频被分隔为 MP3 帧。这两种方案不一定与传输层对数据分块的方式对齐。在一次测量的响应中,四个逻辑 MP3 帧以六个投递分块到达,其中两个在帧中间结束。将每个投递分块视为一个完整单元的消费者会在普通、健康的流量上失败。修复方法是缓冲传入字节,仅在找到分隔符后才采取行动:
buffer = b""
for event in resp["Body"]:
    if "PayloadPart" not in event:
        continue
    buffer += event["PayloadPart"]["Bytes"]
    while b"\n\n" in buffer:
        frame, buffer = buffer.split(b"\n\n", 1)
        handle(frame)
如今用于面向模型这一段的替代方案完全跳过了 base64 和 SSE 帧封装。它在已经承载增量文本输入的同一双向会话上多路复用原始二进制音频和 JSON 控制帧,并用一条规则区分它们。
import json


def _decode_control_frame(chunk: bytes) -> dict | None:
    try:
        decoded = json.loads(chunk.decode("utf-8"))
    except (UnicodeDecodeError, json.JSONDecodeError):
        return None
    return decoded if isinstance(decoded, dict) else None
无法解码为 JSON 对象的分块就是音频,按接收原样转发,路径中没有任何编码步骤。有一个边缘情况值得注意:原始 PCM 音频可以合法地以字节 0x7b 开头,即 ASCII 字符 {,与 JSON 对象的开头字符相同。这条规则避免了将该音频误分类,因为它要求整个分块解析为有效 JSON,而不仅仅是第一个字节,而 PCM 帧基本上永远不会做到这一点。
注意:如果你的前端已经有可用的文本 SSE 管道,那么在 SSE 事件中使用 base64 编码的音频是务实的选择。它带来大约 33% 的额外载荷和一次缓冲重组步骤,但复用了你已经在运营的基础设施。如果你是从头构建语音路径,或者延迟是优先事项,统一的二进制加 JSON 方法避免了这两项成本,并复用了已经承载文本的连接。
第 5 步:在真实智能体中整合起来
更完整的端到端案例是一个实时运行的生成式智能体,它逐 token 组合自己的响应,在句子一存在之前无法知道句子四是什么。这个示例作为 Strands 智能体运行,由 Amazon Bedrock 提供支持,部署到 Amazon Bedrock AgentCore 运行时,并使用第 4 步中的模式调用 Kokoro 端点。此设计中有三条通信链路相连:面向浏览器的链路将 Server-Sent Events 传回调用方,智能体向 Amazon Bedrock 发起流式调用以进行文本生成,以及智能体与 Kokoro 端点之间用于合成的双向会话。
下图展示了这三条通信链路,以及生成与合成之间的重叠发生在何处:
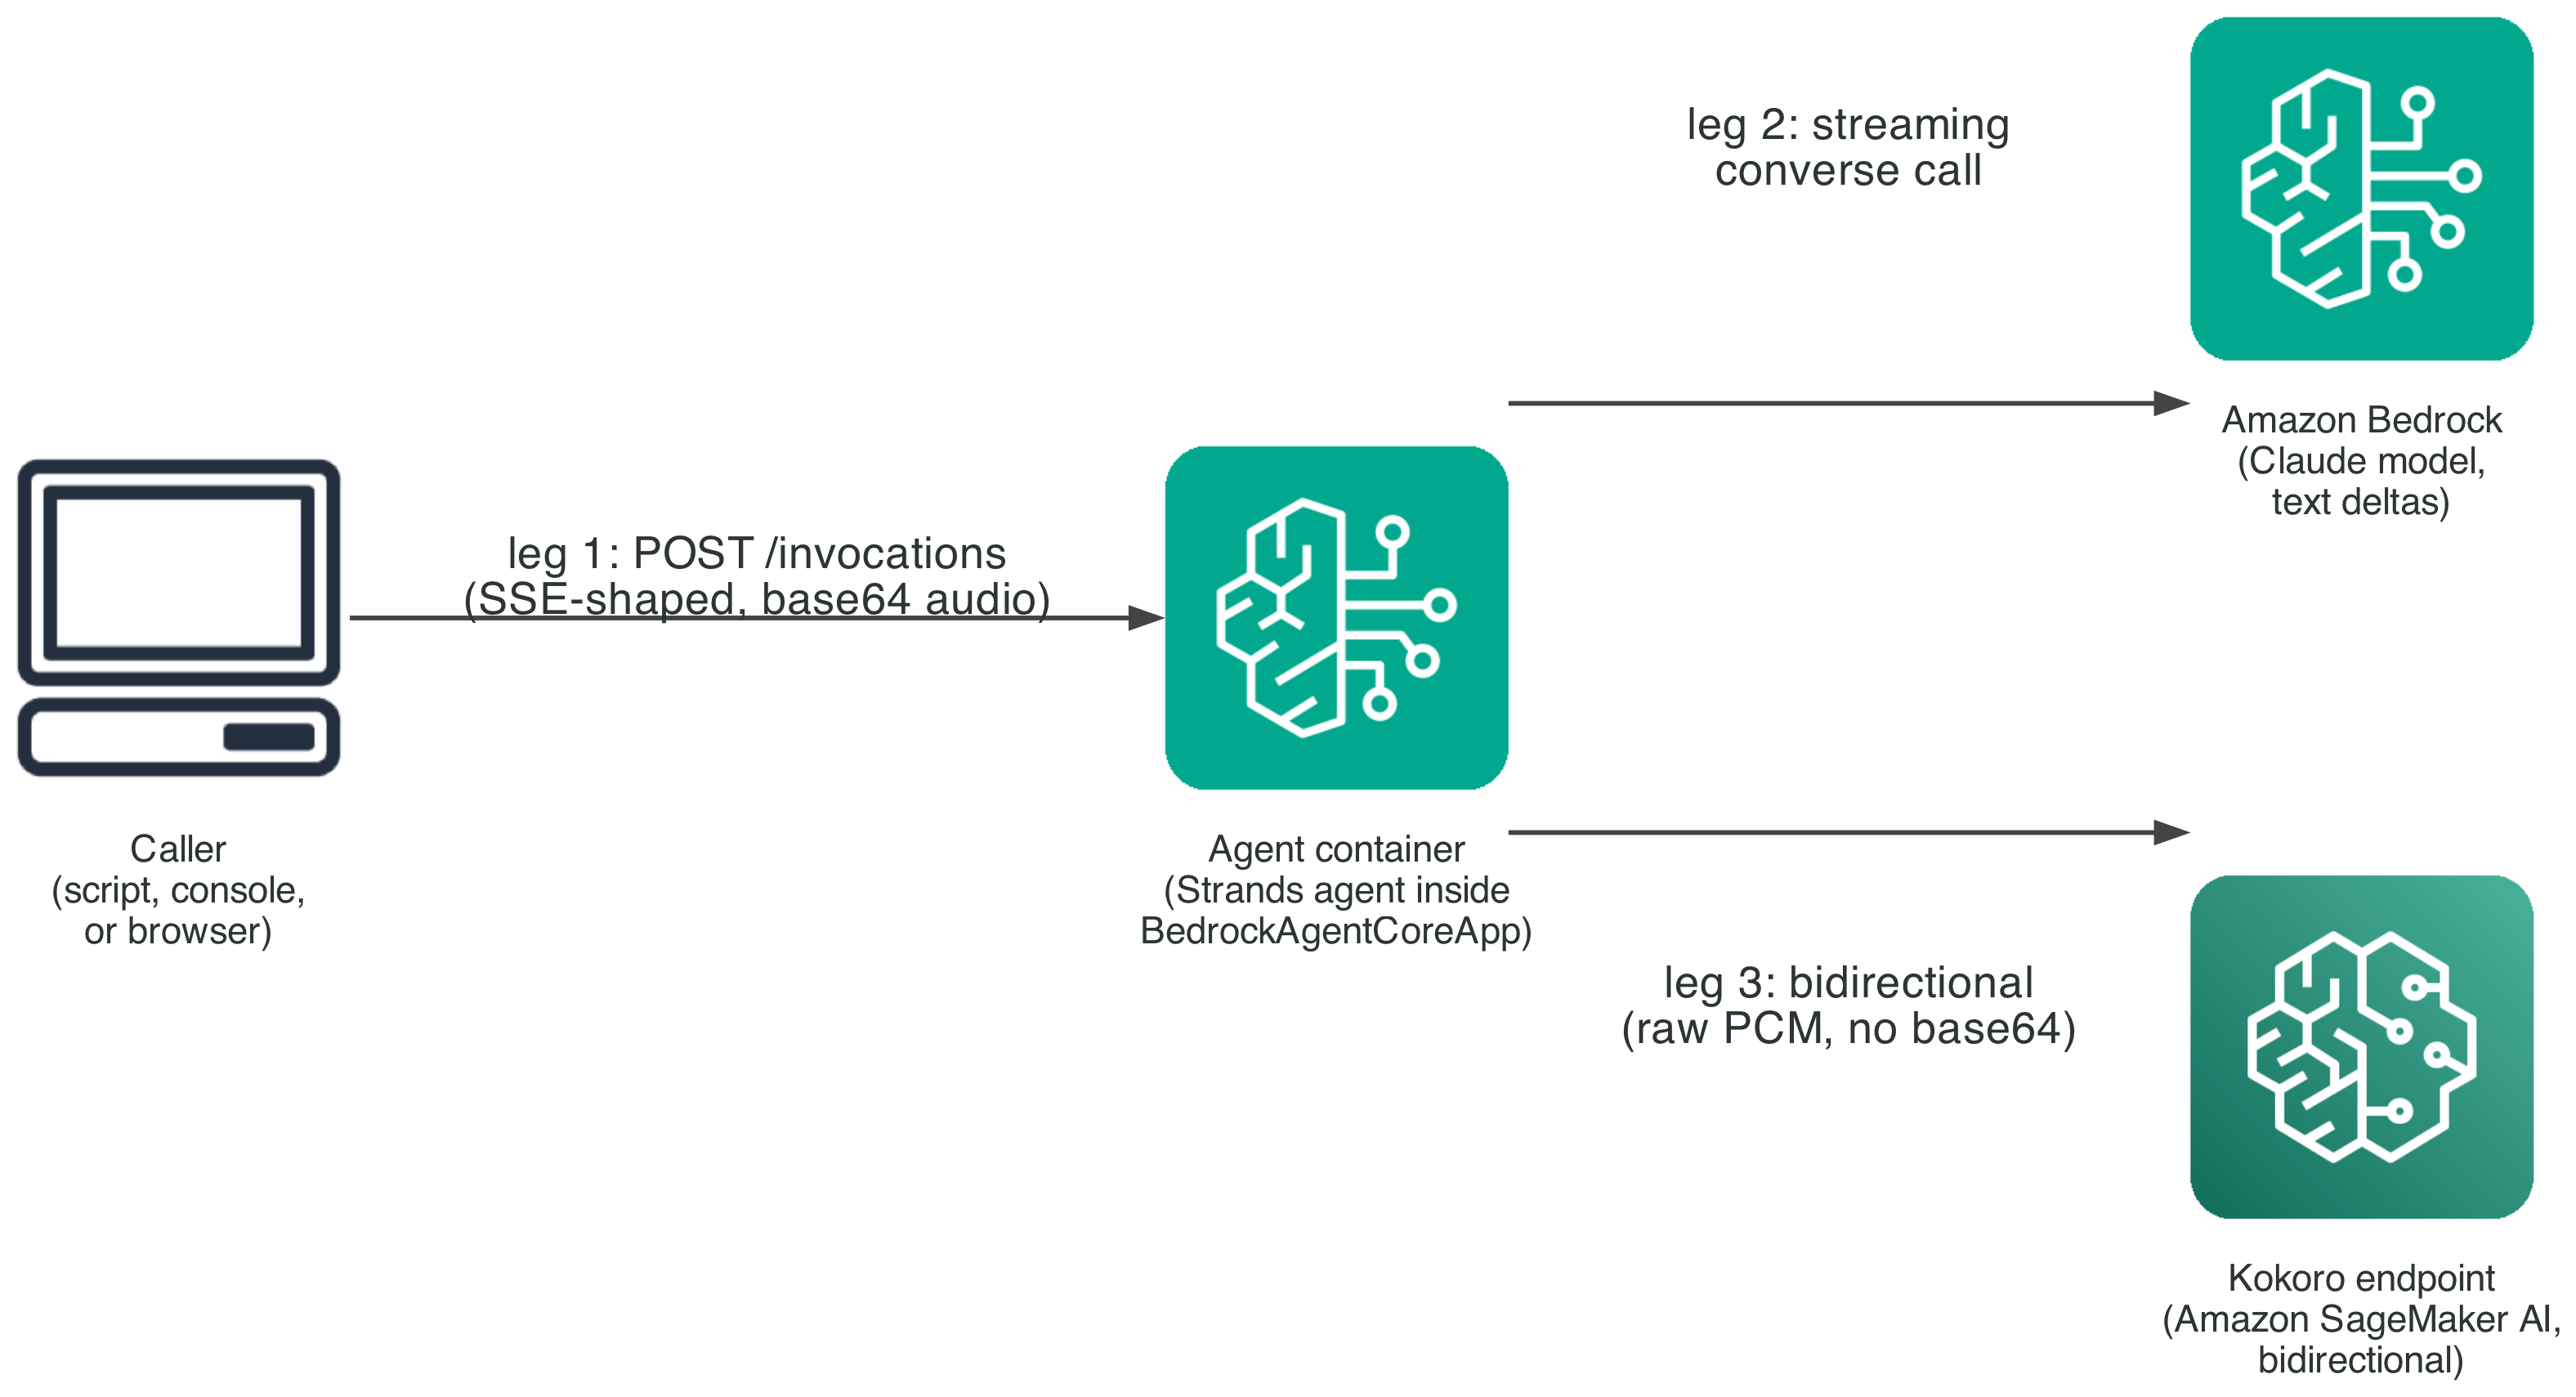
图 3:连接调用方、Amazon Bedrock 和 Kokoro 端点的三条通信链路
请求负载携带一个 mode 字段,取值为 "bidi" 或 "batch",会被分发到同一入口函数内的两条代码路径。两者之间的基准测试只改变一个变量:合成何时开始。在 run_bidi 中,两个任务并发运行。一个任务排空 Bedrock 文本流,并将已完成的句子送入分块器。另一个任务排空 Kokoro 会话,并在音频块到达时将其发出。两者都推入同一个共享队列,因此消费者按真实到达顺序产出事件:较早句子的音频可以在 Bedrock 仍在生成较晚句子时到达调用方。run_batch 则是有意相反的做法:它等待完整响应后再进行一次合成调用,作为公平的基线保留。
反方向上,从智能体容器返回调用方的链路确实使用了 base64,原因与第 4 步所述不同。BedrockAgentCoreApp 的入口点必须产出可 JSON 序列化的普通字典,其 SDK 会自动将其转换为 data: {json}\n\n 帧。无法向它传入原始二进制帧。这是 JSON 原生托管运行时的结果,而不是第 4 步所测量并放弃的选择。run_bidi 和 run_batch 在这条链路上都付出相同的代价,因此它们之间测得的差异纯粹是时序上的:第一个音频块何时发出。
测试与验证
我们通过以两种方式发送同一段 267 个字符、四句话的文本,隔离出 TTS 传输本身对首个音频时间的贡献:作为一条消息发送(批处理),以及仅发送其第一句话(增量)。我们针对实时端点各运行了五次试验。
如前所述,仅发送第一句话将首个音频字节的平均时间从 329.3 ms 降至 156.7 ms,相对提升 52.4%,且仅归因于 TTS 传输本身。
随后,我们测量了更完整的端到端案例:由真实语言模型生成文本,将相同的提示词分别通过 run_bidi 和 run_batch 发送给同一个实时 Bedrock 模型和端点,因此唯一变量是合成何时开始。
使用相同方法,在本地容器上,bidi 模式的首个音频时间测得比批处理模式快 2.4 倍;在部署的 AgentCore 运行时上则快 3.5 倍。
下图展示了两种环境下的这一差距:
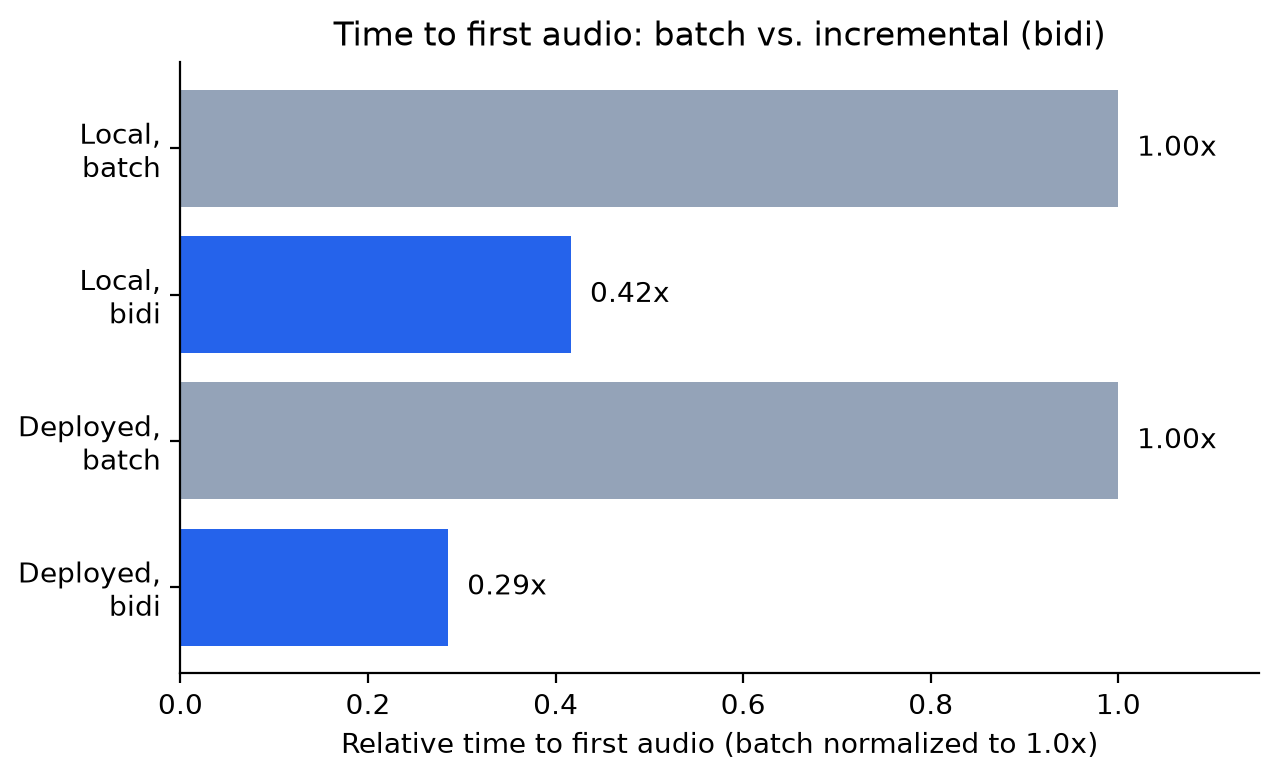
图 4:本地和部署运行时上批处理模式与 bidi 模式的相对首个音频时间
一旦加入真实的网络跳转,部署场景下的差距会扩大而非缩小。run_bidi 在其已经利用的生成与合成重叠中吸收了该跳转。run_batch 没有等效的重叠来隐藏该成本,因为它一次只做一件事,所以每增加一毫秒的网络开销都直接落在其串行等待上。
要针对你自己的部署复现这一对比,请运行 agent 容器所提供的同一个 bidi-vs-batch 测试:
uv run agent-infra demo --endpoint-url <your-endpoint-url> --prompt "<your prompt>"这会将提示词分别通过两种模式发送,并报告每种模式下第一个 audio_chunk 事件相对于 agent_start 的时间戳。如果你看到的是错误,请检查第 1 步中提到的 KeyError: 'text' 症状。如果端点报告 InService 而每个请求都失败,则说明是该 bug,而不是部署问题。
清理
为避免持续产生费用,请按与部署相反的顺序拆除本演练所创建的资源,先拆除 agent,再拆除端点:
uv run agent-infra destroy --bedrock-model-id <your-bedrock-model-id>
uv run speech-infra destroy kokoro-82m
agent-infra destroy 会移除 Amazon Bedrock AgentCore 运行时资源。speech-infra destroy 会移除 SageMaker AI 模型、端点配置和端点。两者都不会清空用于缓存模型权重的 Amazon S3 存储桶,也不会删除存放容器镜像的 Amazon ECR 仓库,因为二者都可能在多个模型之间共享。如果你不再需要它们,请手动清空并删除 Amazon S3 存储桶,并移除 Amazon ECR 仓库,因为存储的模型检查点和容器镜像在被移除之前会持续产生少量存储费用。
结论
我们展示了如何从语音 agent 中消除一个可避免的延迟来源,即在开始语音合成之前等待 agent 的完整响应;以及如何量化第二项更隐蔽的成本:SSE 中的 base64 编码音频会使负载膨胀约三分之一,并且如果不为此进行缓冲,还可能与 MP3 帧边界错位。只要 agent 生成一个句子,就将其流式传输到 SageMaker AI 双向端点,在隔离测试中将首个音频的延迟缩短了一半以上,在已部署的 agent 中缩短了 2.4 到 3.5 倍。在该会话上多路复用二进制音频和 JSON 控制帧,而不是将音频编码为文本,可消除朴素 SSE 中继所需的大小膨胀和帧重新对齐工作。
如果你要为已经通过 SSE 流式传输文本的 agent 添加语音,请先从第 4 步中的 base64 方法开始,等延迟成为优先事项时再重新考虑统一传输。要了解更多信息,请参阅 Amazon SageMaker AI 实时推理文档 和 Amazon Bedrock AgentCore 文档。如果你希望获得帮助,将此模式应用到自己的架构中,请联系你的 AWS 客户团队。
关于作者

Joseph Cottingham
Joseph 是 AWS 生成式 AI 创新中心的一名机器学习工程师,他在那里设计和交付 AI 系统,帮助组织从想法走向生产。他的技术背景涵盖固件、软件和机器学习,并在高吞吐、事件驱动的架构方面拥有深厚专长,这些架构可让 AI 工作负载在大规模下保持高性能。Joseph 专注于前沿研究与运营现实的交汇点,交付能够切实改变组织及其所运营系统的解决方案。