Postman 如何在 Amazon Bedrock 上为 4000 万开发者运行 Agent Mode
How Postman runs Agent Mode for 40 million developers on Amazon Bedrock
AI 导读
Postman 披露其 Agent Mode 在 Amazon Bedrock 上的生产架构,用于支撑 4000 万开发者的 API 测试、文档、发现与实现工作。
正文· AI 翻译
为演示构建一个 AI agent,与为 4000 万开发者运营一个 AI agent,是两个不同的工程问题。Postman 着手构建 Agent Mode,这是一种 AI 原生的方式,可贯穿 API 测试、文档、发现和实现。团队原本以为模型质量和提示词设计会是最难的问题。更深层的挑战来自将一个 agent 集成到一个成熟产品中,该产品多年来建立在界面驱动的假设之上,表面积广,且包含专门概念。
在本文中,Postman 和 AWS 描述了在让一个成熟产品对 AI agent 可理解的过程中浮现出的架构模式。这些模式包括控制工具蔓延、暴露基于 schema 的读取,以及将上下文而非能力视为主要瓶颈。
我们还解释了 Agent Mode 如何利用 Amazon Bedrock 实现模型灵活性、地理范围内的跨区域推理、依赖模型的零数据保留,以及多级提示词缓存。这些经验合在一起,可以帮助团队将生产级 agent 推进到原型之外。
Postman 为什么构建 Agent Mode
Agent Mode 是 Postman 的门户,用于以 AI 原生方式在测试、文档、发现和实现中与产品协作。Postman 已发展 11 年,开发者和用户学会了通过界面定位信息:展开侧边栏、查看标签页、打开请求。为 agent 重新设计这种认知,暴露了产品 API、用户体验和产品知识分布中的结构性假设。agent 是对数据进行推理,而不是在屏幕上导航。图 1 展示了 Agent Mode 如何直接针对应用程序工作。
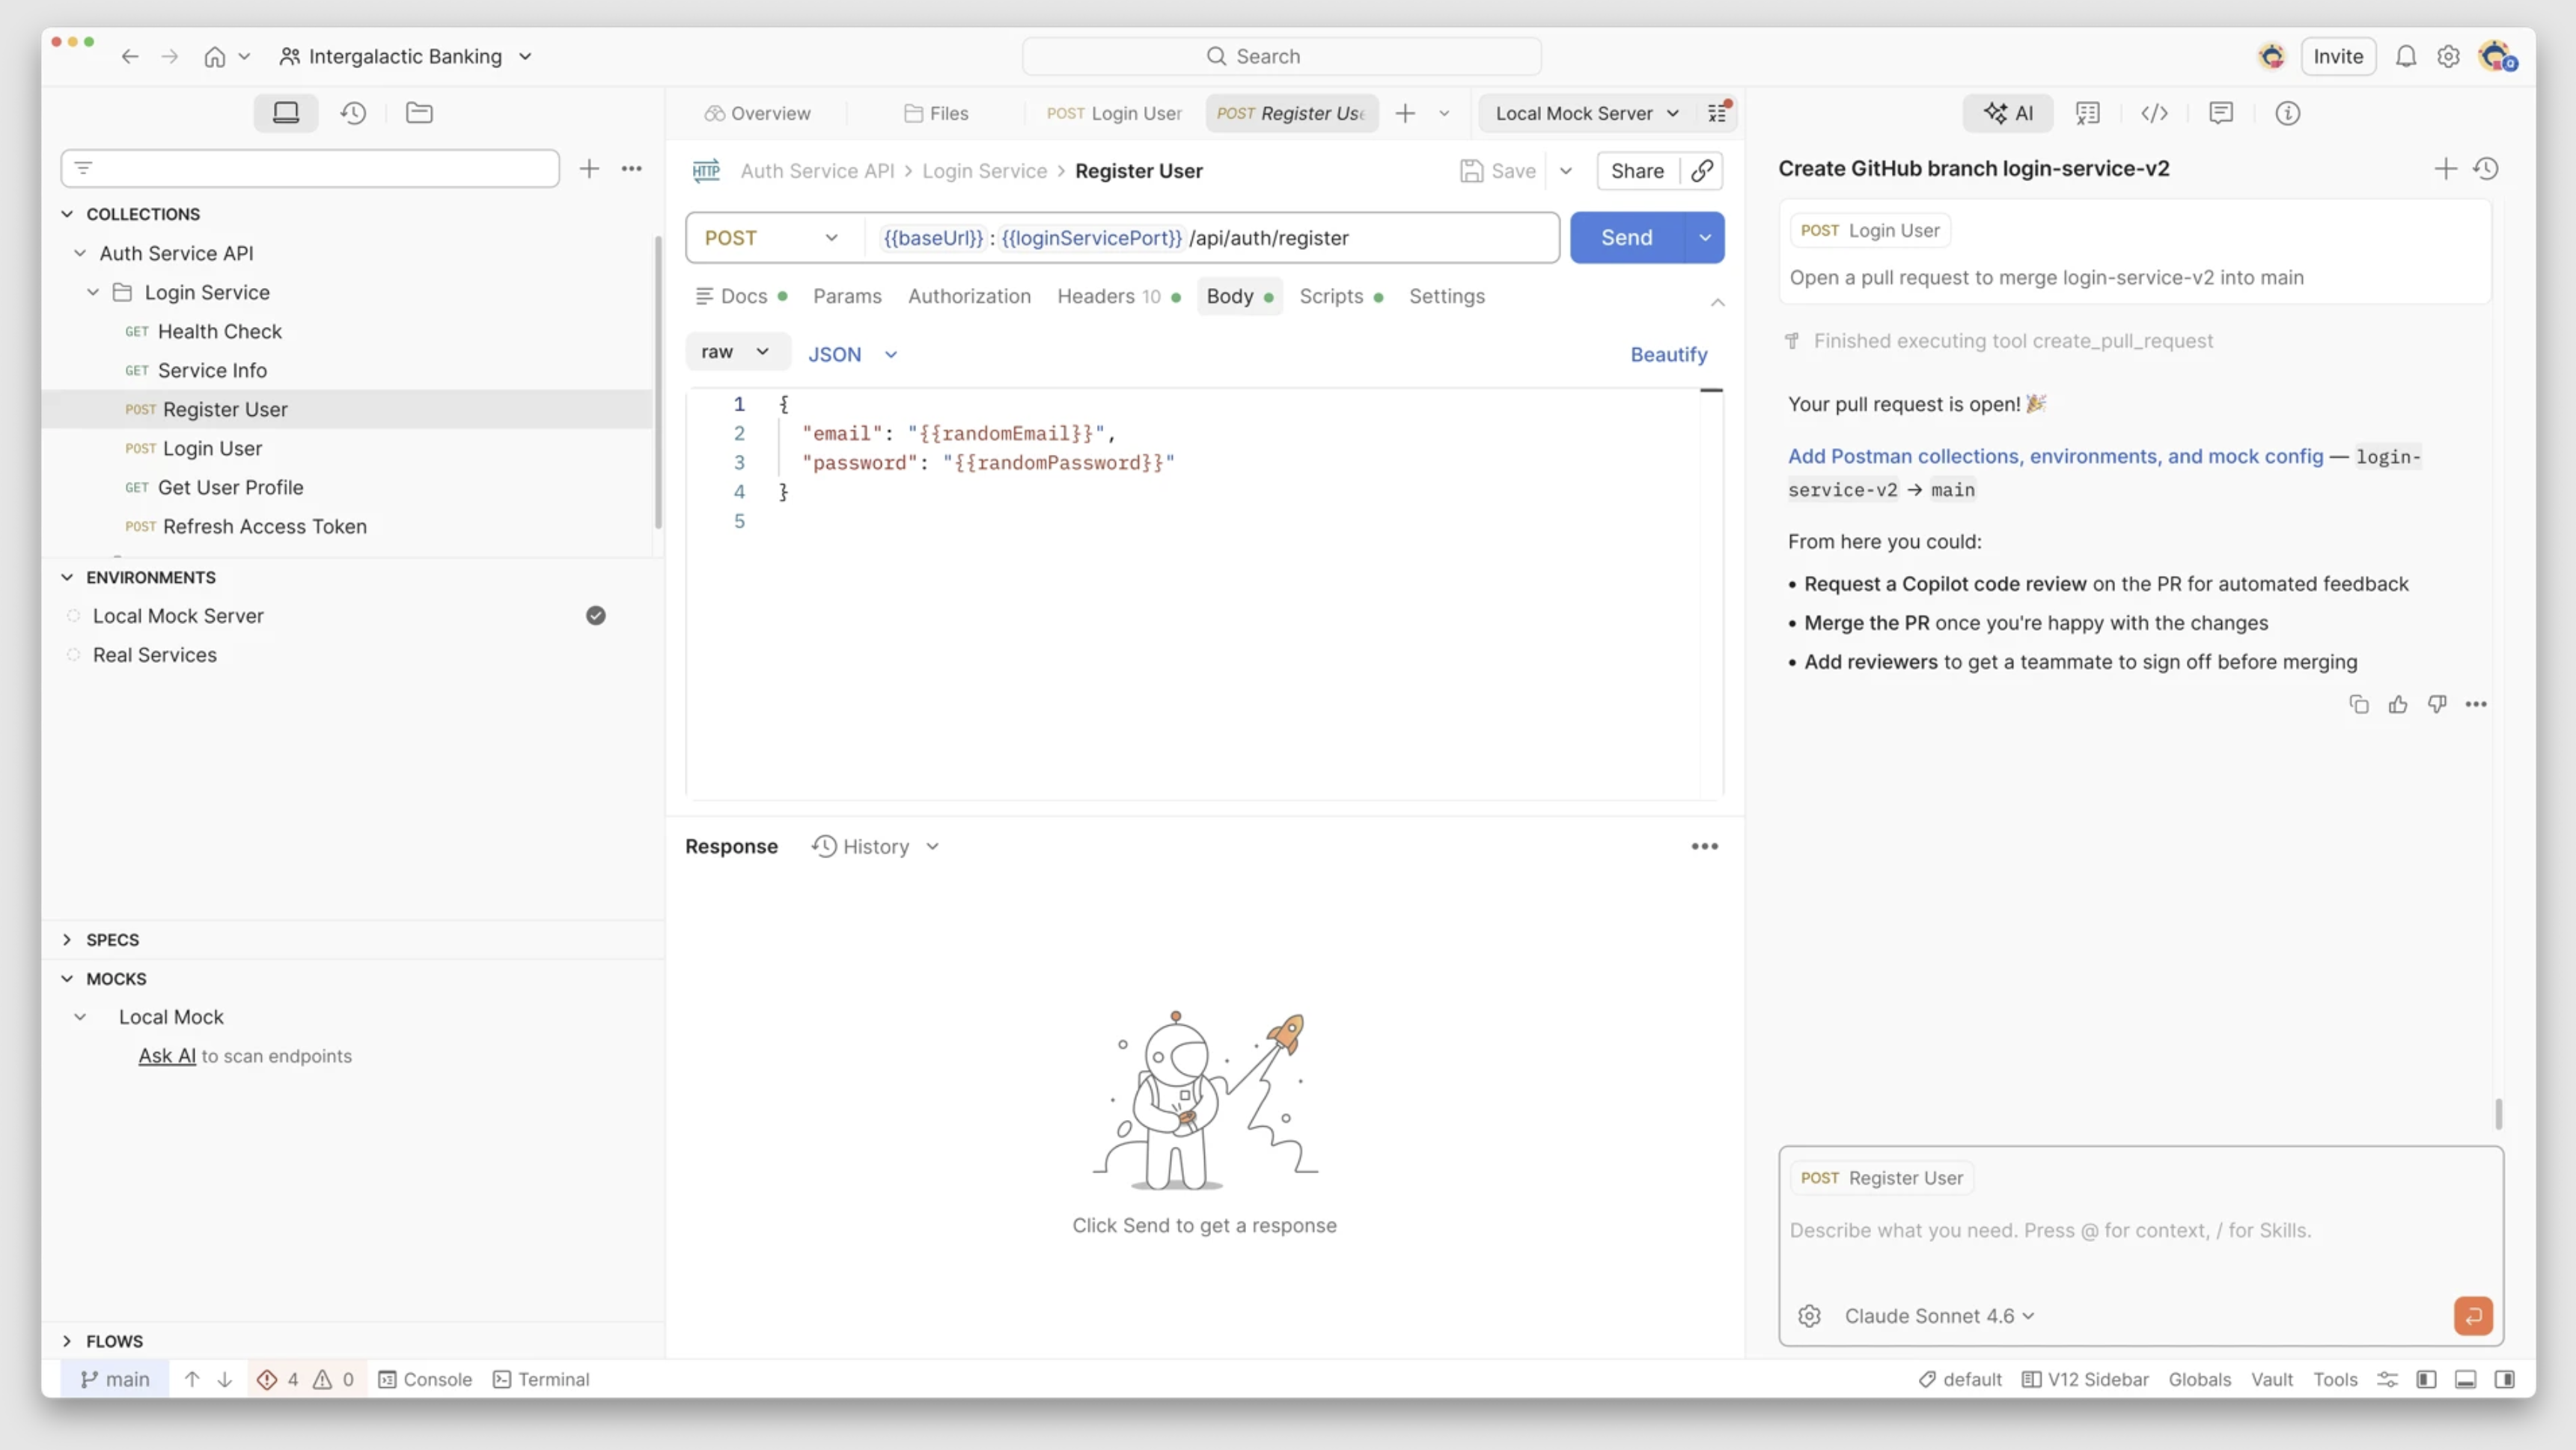
图 1:Agent Mode 直接针对 Postman 应用程序工作。在此示例中,它打开一个拉取请求并提出后续步骤,而无需用户通过界面导航
Agent Mode 运行在 Amazon Bedrock 上,后者提供对 agent 背后基础模型的托管访问。支持 Postman 的全球开发者社区会产生多变、对延迟敏感且带有急剧流量峰值的高需求。借助 Amazon Bedrock,Postman 可以扩展这一生产工作负载,而无需运营自己的模型服务基础设施,同时保留模型选择灵活性以及对吞吐量、地理处理和成本的控制。图 2 提供了生产架构的高层视图,随后各节将审视其组件。
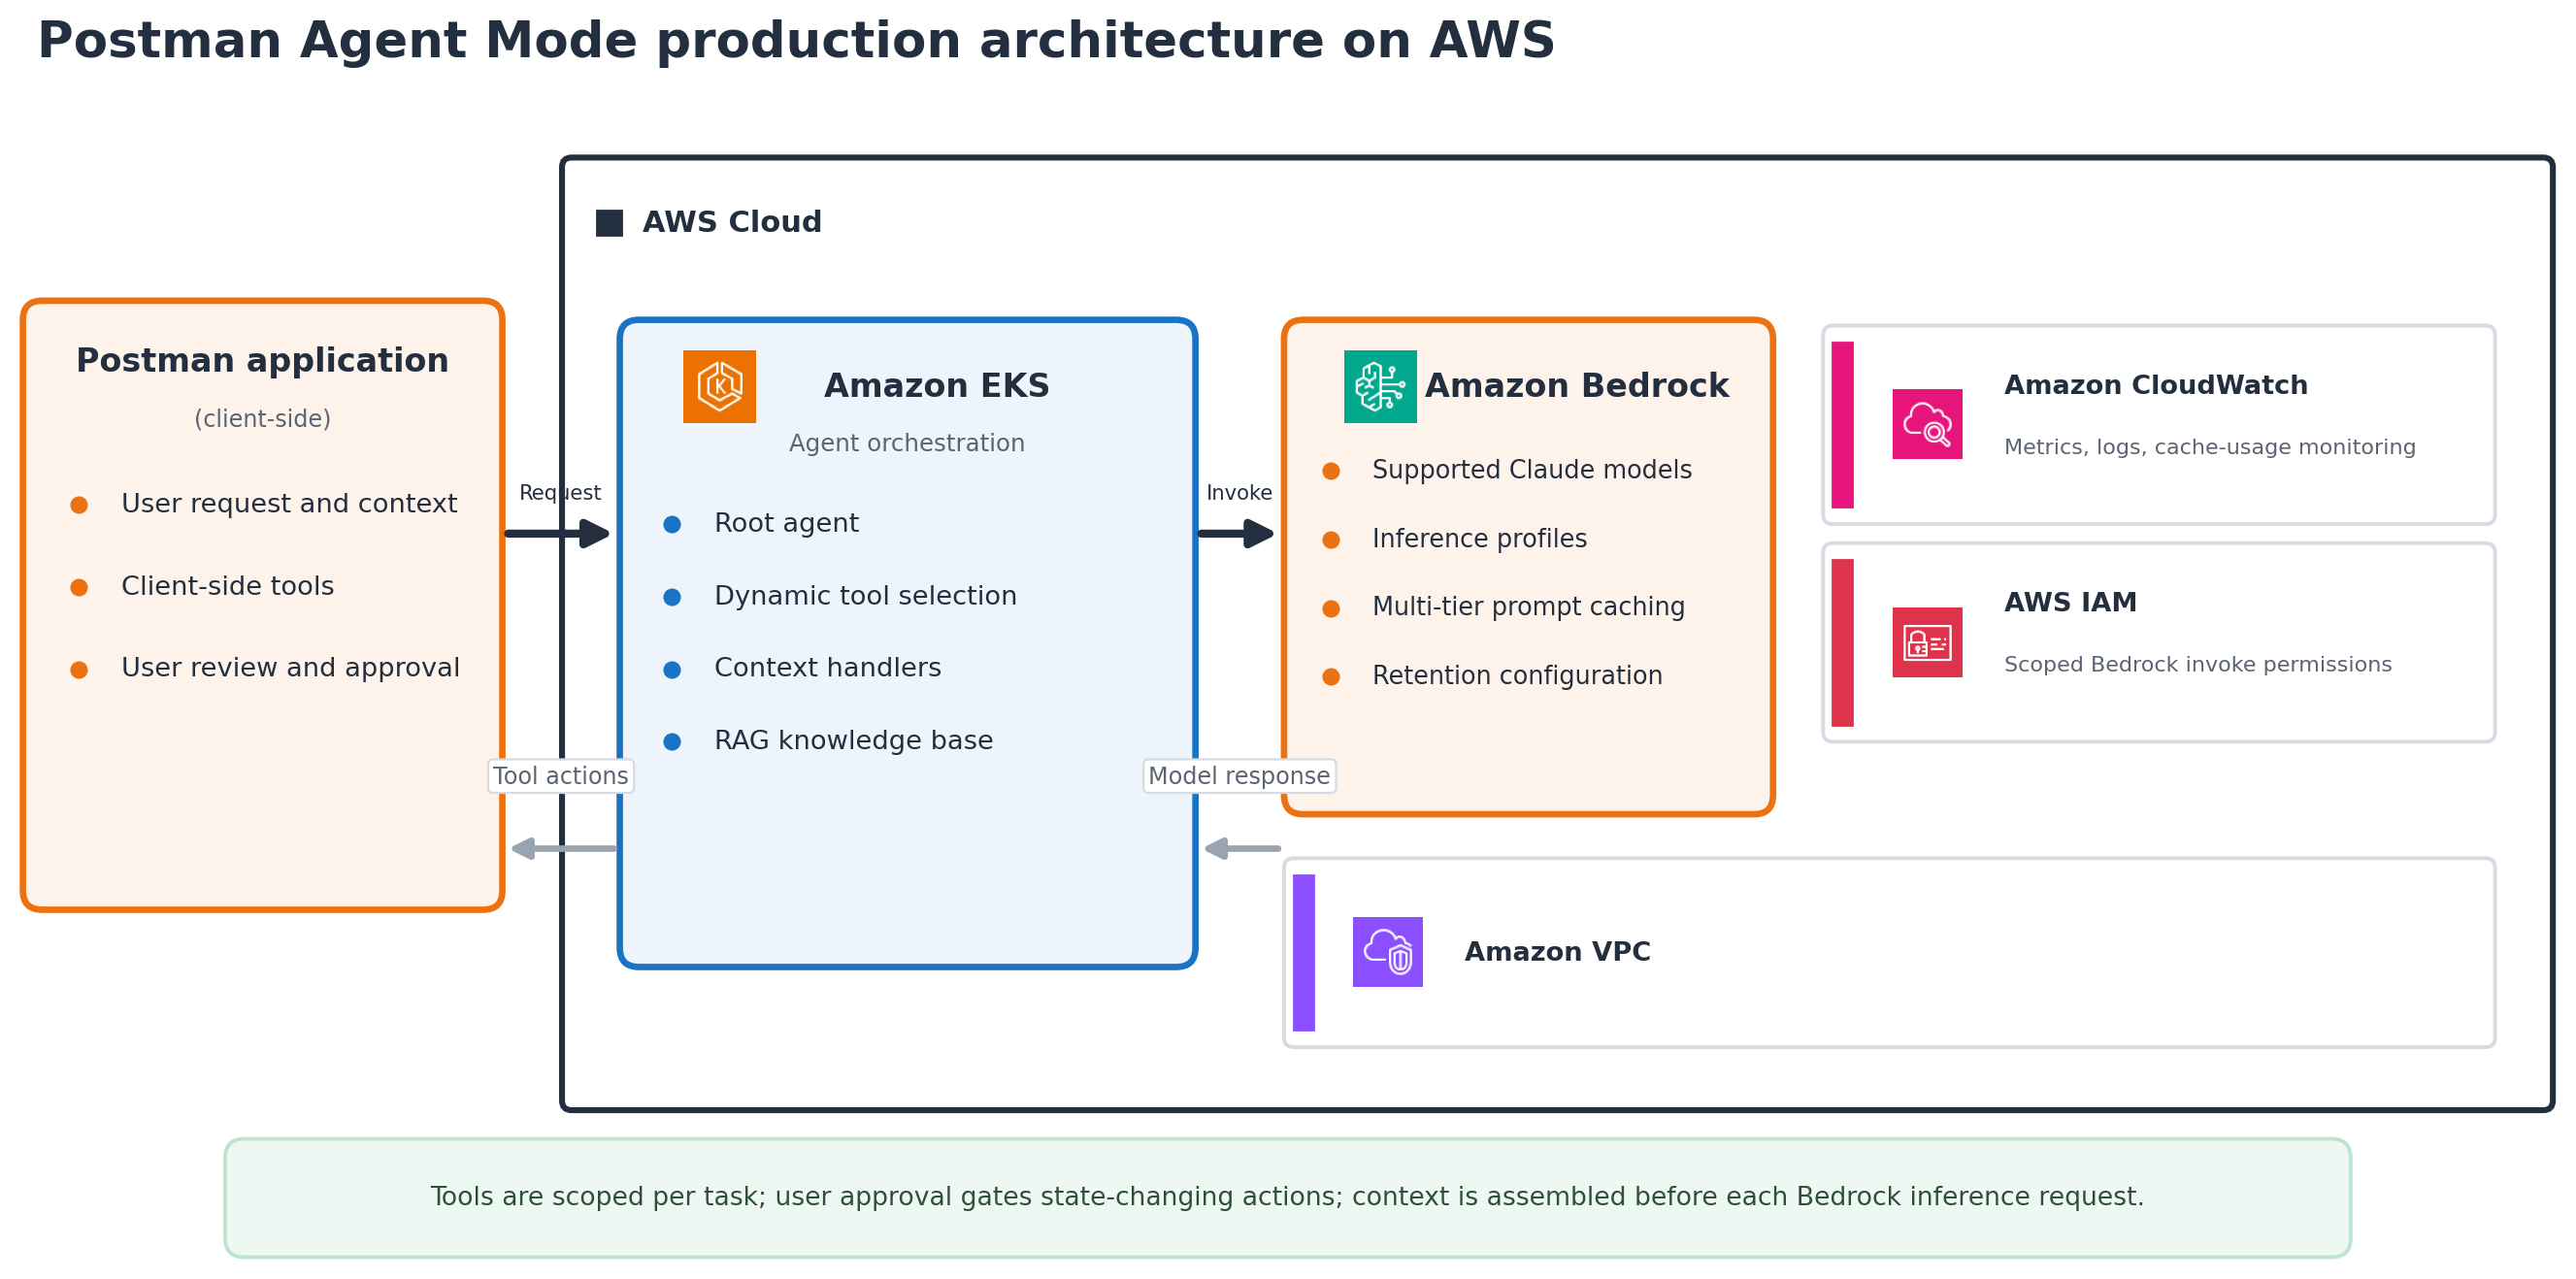
图 2:Postman Agent Mode 结合了客户端工具、agent 编排、专用上下文和 Amazon Bedrock 模型推理。工具按任务范围限定,用户批准仍是修改应用程序状态操作的一部分
人工监督是生产设计的一部分。Agent Mode 在修改应用程序状态的操作之前需要用户批准。Postman 还会将可用工具限定到任务范围、选择专用上下文,并应用依赖模型的数据保留设置。这些控制减少了意外操作和不必要的数据暴露,同时生产测试和监控仍然必要。作为一项负责任的 AI 控制措施,Postman 使用 Amazon Bedrock Guardrails 在个人身份信息到达底层大语言模型(LLM)之前对其进行脱敏。企业管理员可以在 Agent Mode 的护栏设置中开启此功能。
处理工具蔓延
在 Agent Mode 中,工具定义了 agent 在 Postman 内部的行为方式。早期,团队倾向于高度原子化的工具:诸如打开请求、更新单个字段或获取特定元数据片段之类的小而精确的操作。这种方式在早期迭代中保证了正确性和可控性,但也暴露出若干问题。
许多真实工作流需要一长串工具调用。即便每一步都很快,整体体验仍然显得缓慢,因为每个动作都必须先返回模型,下一个动作才能开始。用户只能看着 agent 一步步执行那些在他们心里本属于同一个操作的动作。
在 Postman 的测试中,一旦可见工具集超过约 40 个工具,工具选择错误就会增加。agent 可能调用不存在的工具、在 schema 有效的情况下传入错误参数,或选中语义上看似合理但在当前上下文中错误的工具。更大或更新的模型减少了这种行为,但并未消除它。
超过一定工具集规模后,暴露更多工具反而会降低 agent 的有效性。当前架构根据需求和上下文选择工具,并隔离各个执行线程。模型只能看到与当前任务相关的工具。图 3 展示了这一动态选择过程。
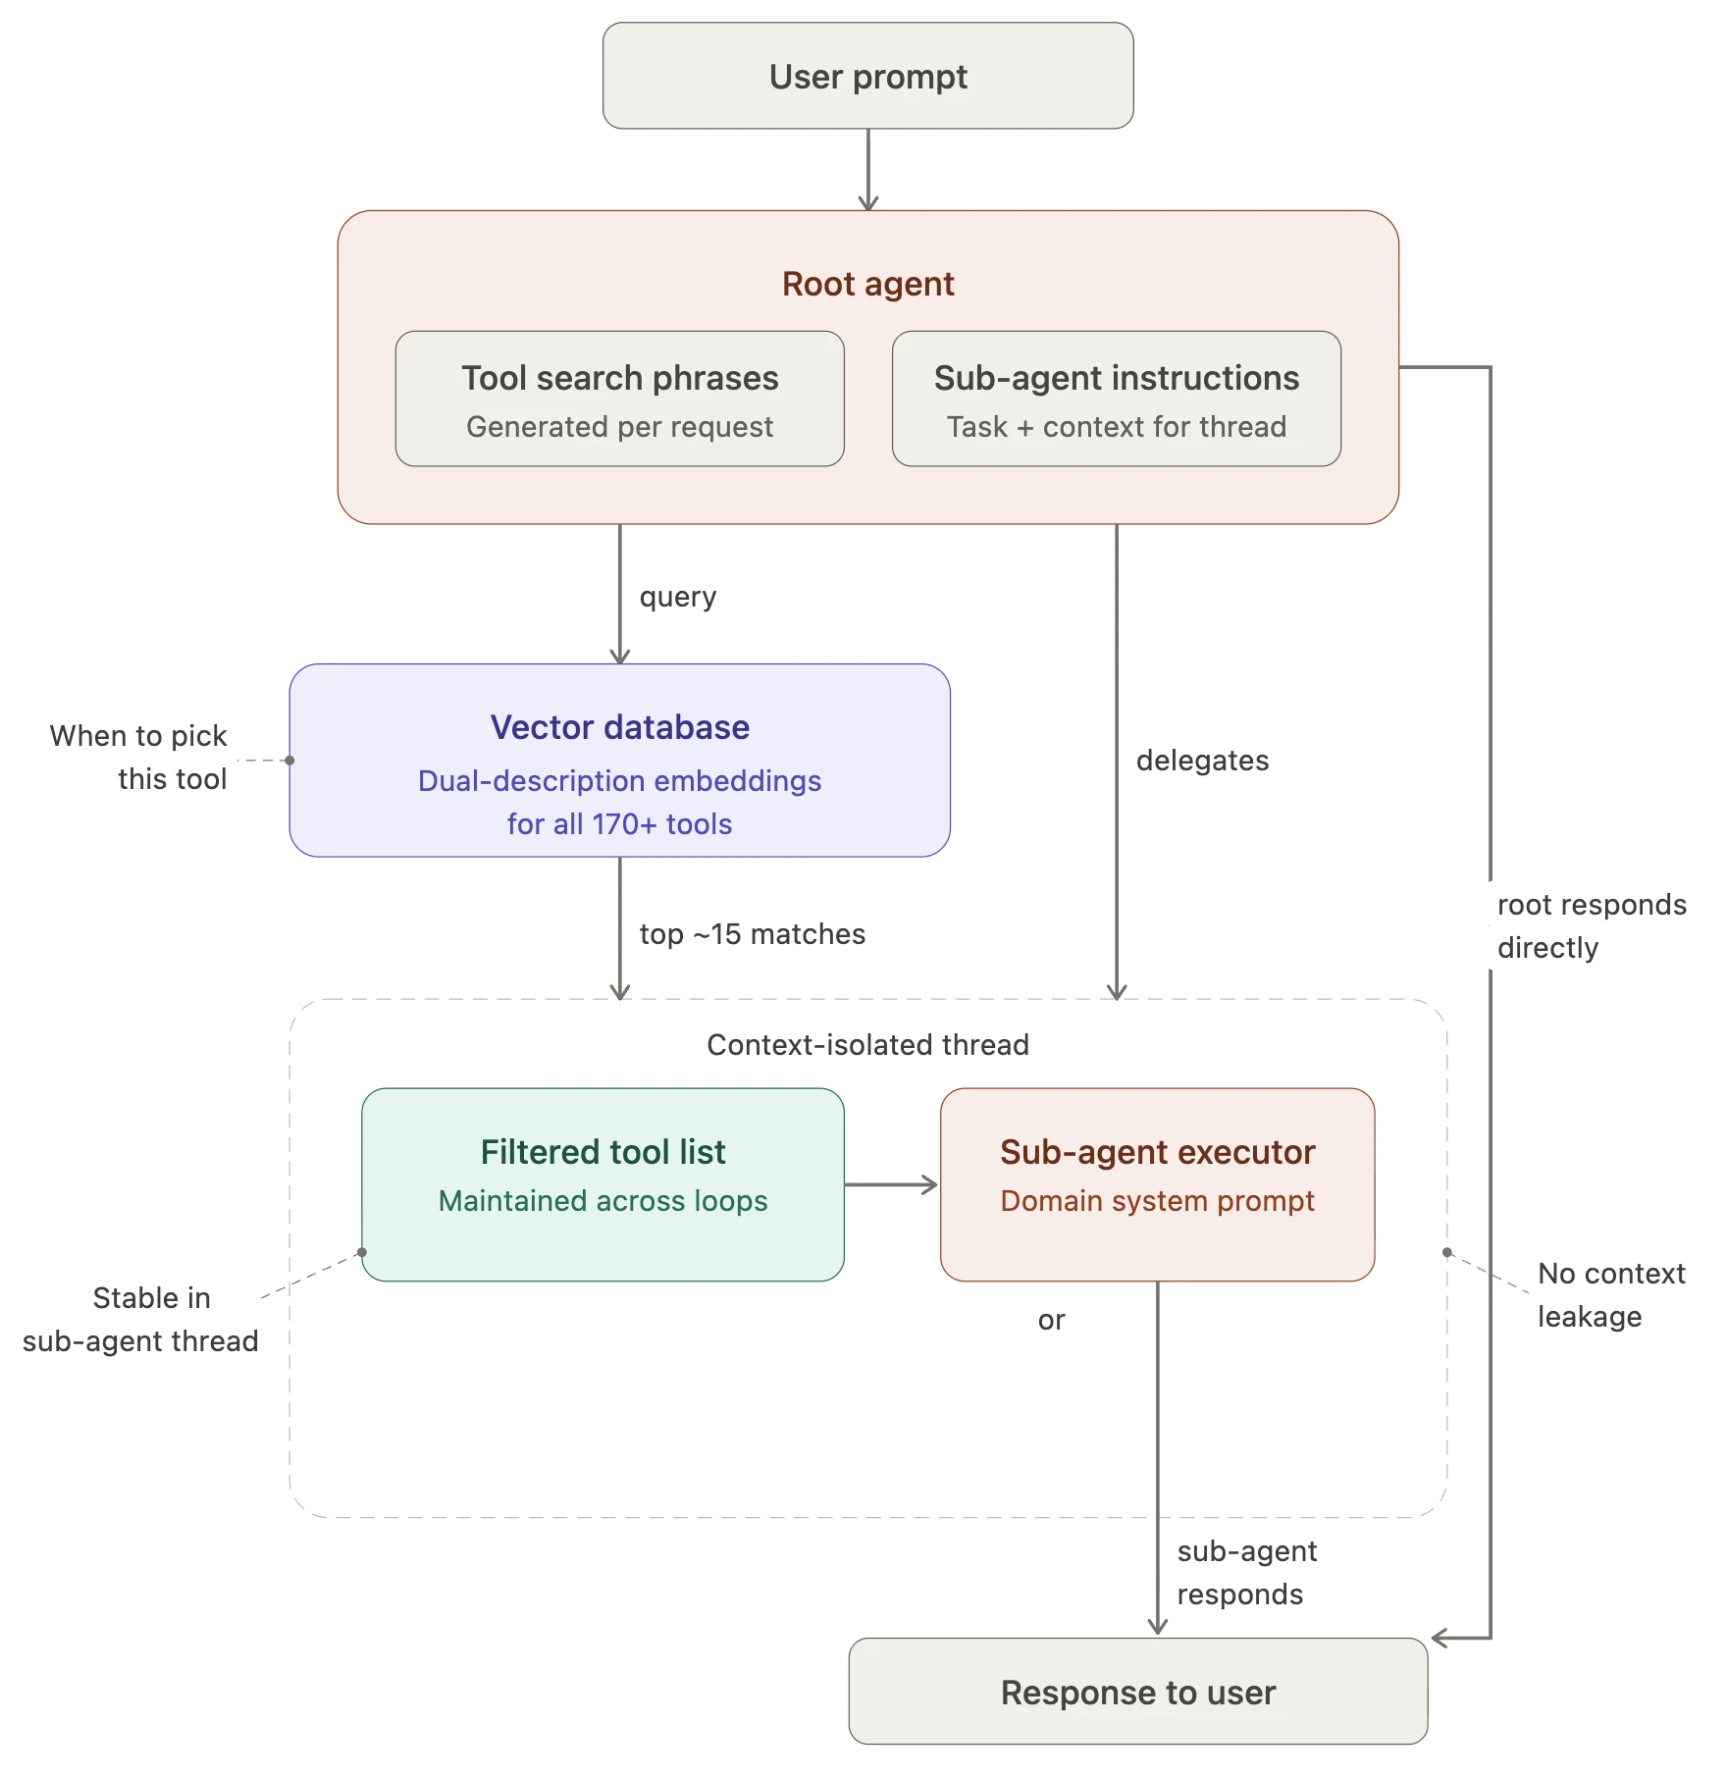
图 3:根 agent 查询工具嵌入向量数据库,将 170 多个工具缩小到与请求相关的约 15 个。随后它把这些工具交给上下文隔离的子 agent,因此模型只能看到任务所需的工具
一个更隐蔽的问题是,许多客户端 API 隐式耦合于界面状态。修改请求的工具需要某些元素处于打开状态,而其他工具则会作为副作用打开新标签页。agent 必须打开请求标签页才能读取它,这模仿的是界面交互,而非对数据进行推理。Postman 正在积极将工具与标签页解耦,其 Native Git 功能大量采用了这一方式。例如,Agent Mode 现在可以在没有打开标签页的情况下于后台发送请求,尽管仍需用户批准。
构建者要点: 将你的工具目录视为上下文预算的一部分。按任务动态限定暴露给模型的工具范围,并将“agent 能做什么”与“UI 恰好打开了什么”解耦。
暴露基于 schema 的读取
对于 API Catalog 等产品,Postman 将多个狭窄视图整合为单一查询工具。这些产品暴露结构化数据,例如跨众多服务的服务正常运行时间、测试结果和端点响应时间。
给定底层 ClickHouse 表的 schema,agent 可以生成带 join 和 WHERE 子句的复杂查询。这大幅减少了回答一个分析问题所需的不同工具数量:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;采用这种方式后,工程工作的重心从为每个问题构建一个工具转向一次性把数据建模做好。随后 agent 能生成的查询种类远超团队以单个工具形式逐一枚举的范围。
构建者要点: 在拥有良好结构化数据的地方,让 agent 以 schema 感知的方式对查询引擎进行读取访问,而不是让单一用途的读取工具不断增殖。你以工具数量换取数据建模,从而获得更好的扩展曲线。
上下文才是真正的瓶颈
Postman 最初以为缺少工具会是最大的障碍。实际上,缺失或不完整的上下文导致的失败比缺少能力更多。
上下文是智能体对用户在 Postman 中所处位置、哪些实体处于活动状态以及已建立何种状态的理解。当上下文错误或缺失时,即使工具正确也会失效。图 4 区分了提供给智能体的两种上下文形式。
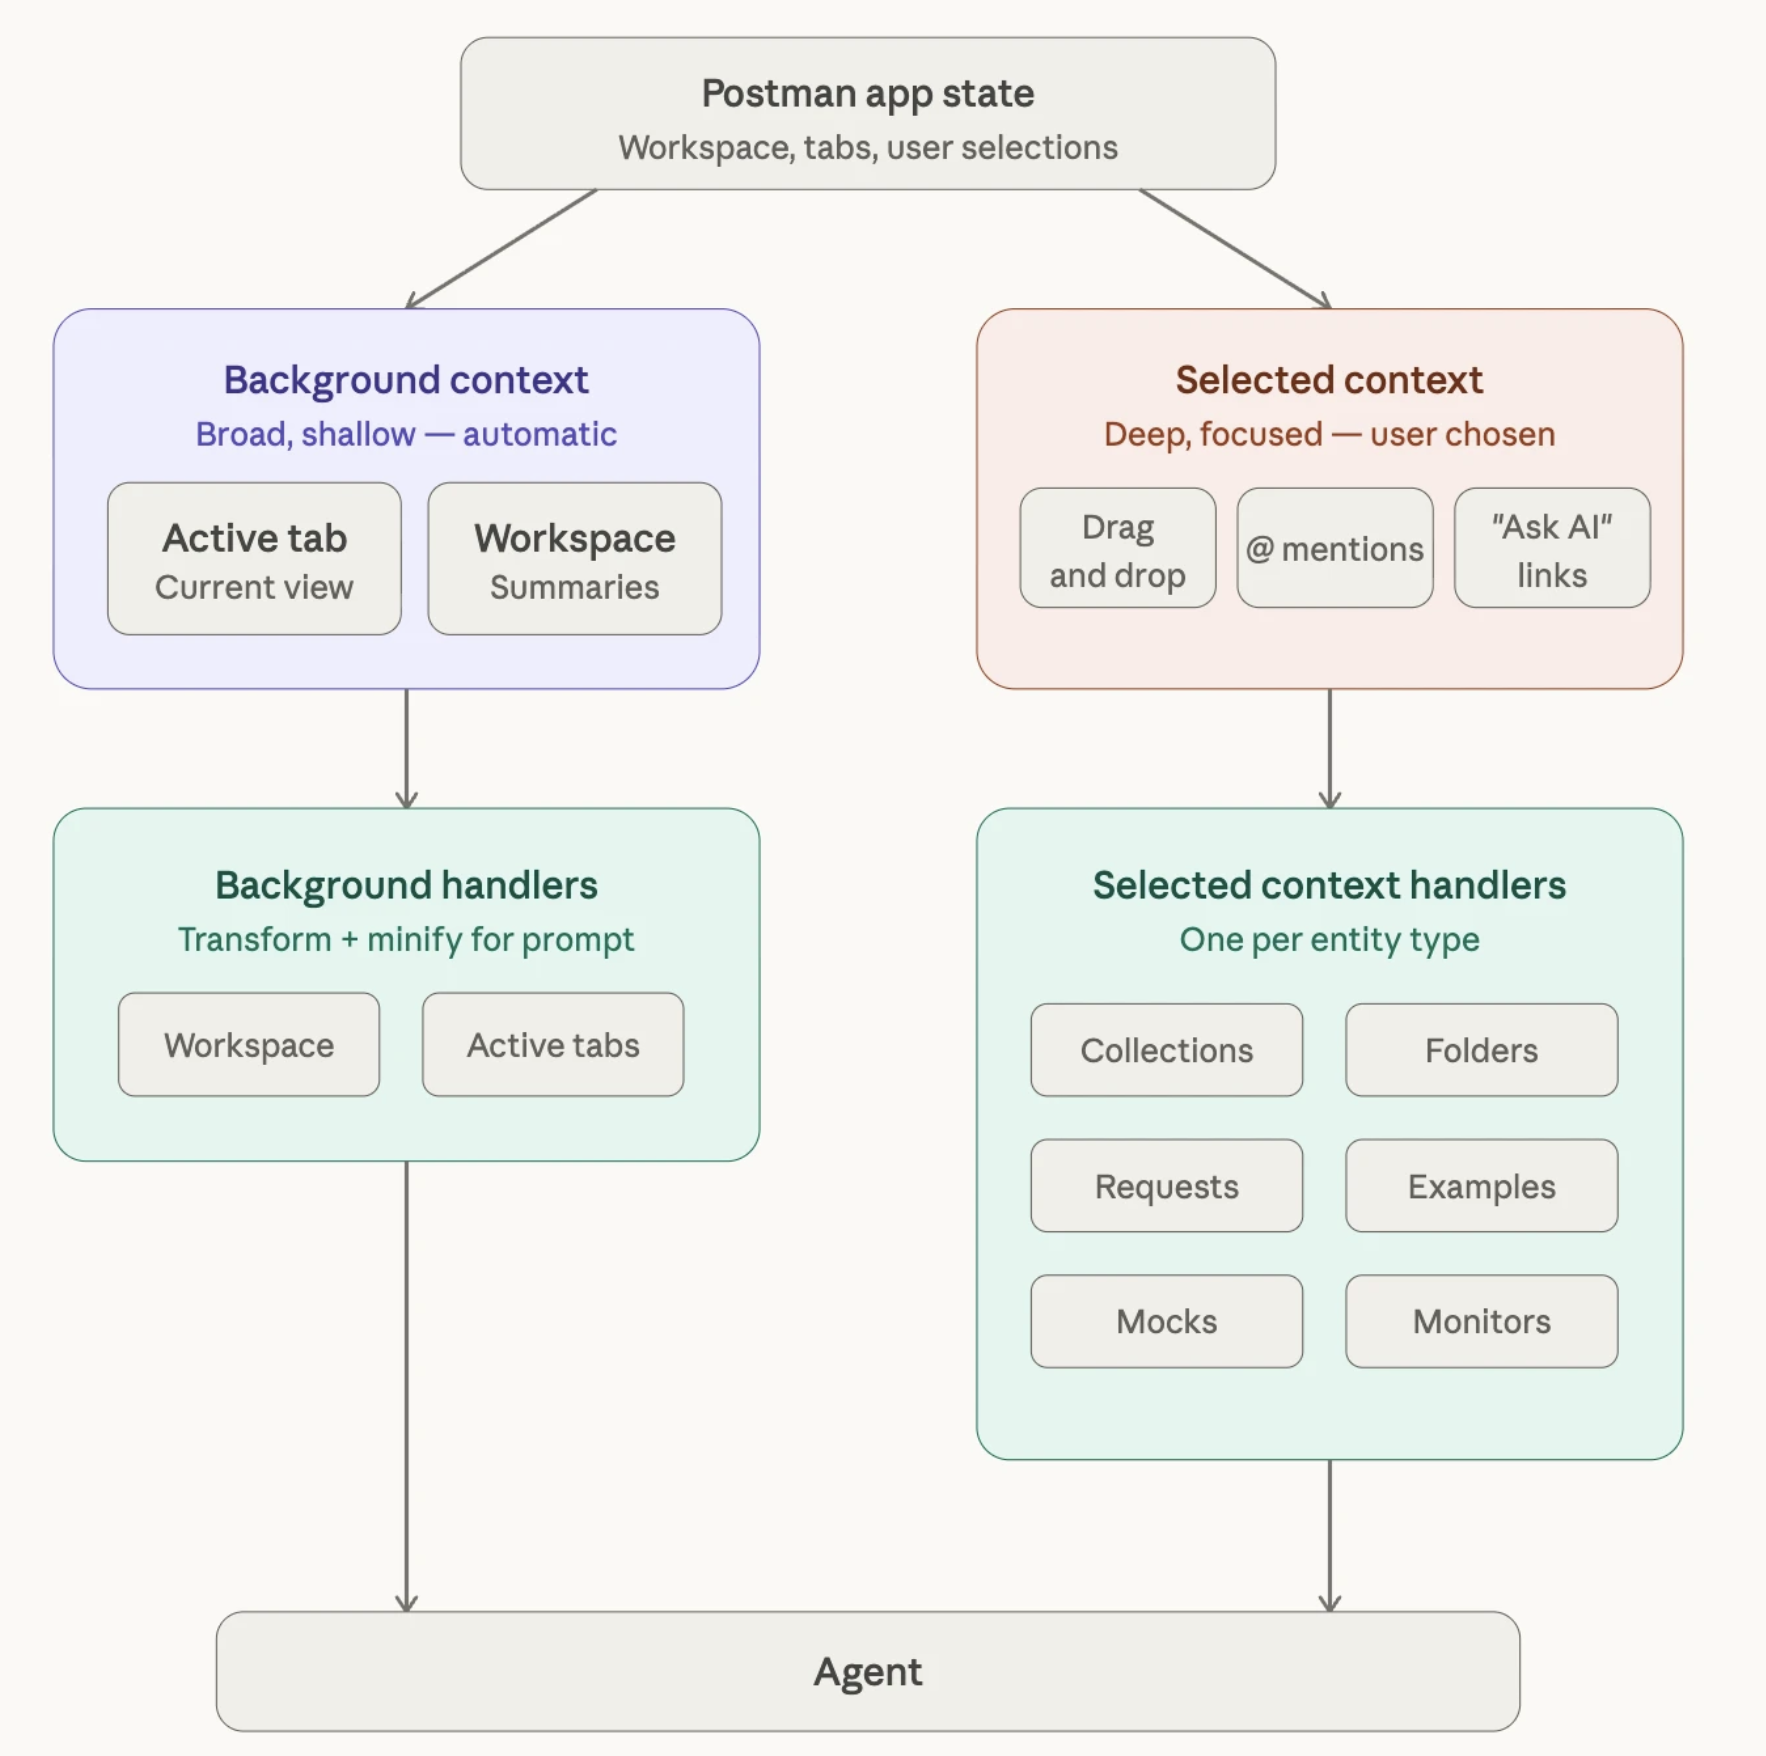
图 4:两种上下文为智能体提供输入。广泛、浅层的背景上下文会被自动收集并精简后放入提示词。深入、聚焦的选定上下文由用户选择,并通过每种实体类型专用的处理器进行路由。每个处理器都会将该实体提炼为智能体所需的信息
挑战是结构性的。在 11 年多的时间里,开发者和用户学会了通过界面查找信息。为智能体重新设计这种认知需要多次迭代,以确定每个工作流中哪些内容重要、哪些是噪声。将现有界面数据模型序列化并不能产生有用的上下文,因为这些对象是为渲染和数据传输而设计的,并非用于推理。因此,Postman 构建了专用的上下文处理器,将每个实体提炼为智能体需要知道的内容。
随着越来越多对象获得处理器,截断成为下一个问题。许多字段包含开放式用户生成数据,包括请求描述、OpenAPI 规范和请求负载。这些数据可能挤占上下文窗口。在大规模场景下,谨慎管理上下文预算至关重要,也支持团队正在探索的文件系统支撑方案,在这种方案中,每个处理器不需要自定义的截断和扩展逻辑。
构建者要点:不要把你的渲染数据模型直接喂给模型。构建面向用途的上下文处理器,并将上下文窗口视为稀缺且需主动管理的预算。在模型达到上限之前很久,噪声就会挤掉信号。
整合起来
随着 Agent Mode 的演进,系统显然必须聚合三个不同的组件,每个组件解决不同的问题。
- 客户端工具位于 Postman 应用中,代表智能体可以执行的最终操作,例如打开请求、修改设置、运行集合和检查身份验证。Agent Mode 还使用服务端工具执行网页搜索和智能体循环管理等函数,但大多数工具都在 Postman 应用上运行。
- 通用智能体指令定义系统级行为,包括 Agent Mode 应有多主动、如何传达不确定性,以及它携带哪些基线产品知识。
- 知识库采用检索增强生成(RAG)方法。Postman 拥有庞大的产品面,包括多种请求协议、模拟服务器、监控器、文档、API Network、工作区治理、变量、辅助工具、代码生成、请求设置和集合运行。
将所有这些内容都编码进静态提示中并不可行,而且其中大部分内容与特定查询无关。在初始种子阶段,团队使用 Postman 的学习中心生成简洁的功能专属文章。在运行时,Agent Mode 会根据传入的查询和可用上下文选择知识文章。例如,当用户选择模拟服务器时,Agent Mode 会自动注入相关文章。这使智能体在默认情况下保持轻量,同时在需要时提供深度。知识库随应用一同演进,因此团队可以随新功能一起发布 Agent Mode 文档。
在 Amazon Bedrock 上运行 Agent Mode
前面描述的三个组件最终都归结为同一个运行时操作:对基础模型(FM)的推理调用。在 Postman 的规模下,流量具有突发性且由开发者驱动。路由、缓存和地理处理控制帮助 Postman 应对流量突发、管理推理成本,并满足特定工作负载的处理要求。Amazon Bedrock 提供了四项在此最为关键的能力。
跨 Claude 系列的模型灵活性
Agent Mode 并不绑定于单一模型。通过 Amazon Bedrock 模型推理 API,Postman 可以访问受支持的 Anthropic Claude 模型,并将每个工作负载路由到合适的模型。更快的模型可以服务高吞吐量、对延迟敏感的交互,而更大的模型可以处理质量比成本更重要的复杂推理。在受支持的 Claude 模型之间切换主要是一项配置变更,而不是新的集成。这种灵活性直接支持了前文所述的工具泛滥和上下文挑战。在 Postman 的测试中,更新、更大的模型减少了工具幻觉,并且 Postman 可以在不重建集成的情况下采用受支持的模型。参见 Amazon Bedrock 中各 AWS 区域支持的模型。
跨区域推理实现高吞吐量
开发者流量具有尖峰特性,在单个 AWS 区域为峰值需求进行预置可能成本高昂。Agent Mode 使用 Amazon Bedrock 跨区域推理,在推理配置文件定义的目标区域之间自动路由请求。在运行时,应用程序将选定的推理配置文件 ID 或 Amazon Resource Name(ARN)作为 modelId 传入 Converse 或 InvokeModel。该配置文件、适用的 AWS Identity and Access Management(IAM)和服务控制策略以及配额必须允许 Bedrock 可能选择的每个目标区域。
- 地理推理配置文件仅在定义的地理范围(例如美国或欧盟)内受支持的区域之间路由请求。此选项将提高的吞吐量与配置的地理处理边界相结合。
- 全局推理配置文件可以在全球受支持的目标区域之间路由请求,以在流量突发期间提供额外吞吐量。仅当工作负载不需要受地理约束的处理边界时才适用。
Postman 可以按工作负载选择推理配置文件:需要最大可用吞吐量时使用全局配置文件,或者当处理必须保持在配置文件定义的地理范围内时使用地理配置文件。这一选择在每个 Bedrock 推理请求所使用的 modelId 中明确体现。
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
数据驻留与企业控制
对于企业客户而言,允许的处理地理范围可能与吞吐量同样重要。地理推理配置文件会将 Bedrock 的路由限制在该配置文件在所选地理范围内支持的目标区域。这并不意味着推理在 Postman 自己的 AWS 环境中运行。Amazon Bedrock 会在该配置文件符合条件的 AWS 区域中处理请求,数据在传输和静态存储时均加密。AWS 表示,Bedrock 不会使用提示和补全来训练 AWS 模型,也不会将其分发给第三方。Postman 已为支持的 Agent Mode 模型配置零数据保留,将 data_retention_mode 设置为 none。可用性和行为取决于具体模型,因此每个生产模型都必须对照当前的 Amazon Bedrock 数据保护与保留文档 进行检查。
用提示缓存控制成本
生产级智能体在每一轮都会重新发送大量稳定的上下文,包括系统指令、通用智能体行为、核心工具集、选定的知识以及对话上下文。每次请求都重新处理未变化的前缀,会带来本可避免的延迟和成本。
Agent Mode 使用 Amazon Bedrock 提示缓存 来复用稳定的提示前缀。近乎不变的核心部分(包括系统提示、智能体指令和核心工具定义)使用一小时缓存检查点。变化更频繁的上下文使用五分钟检查点,并在缓存命中时刷新。Bedrock 要求生命周期较长的检查点出现在生命周期较短的检查点之前。较短层级适合交互式会话,因为空闲上下文会过期;而一小时层级可以通过多次读取来摊薄其较高的缓存写入价格。缓存收益和受支持的 TTL 取决于所选模型。团队可以通过 cacheReadInputTokens 和 cacheWriteInputTokens 用量字段验证行为,并针对自身工作负载测量首 token 时间。
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
构建者要点: 将推理视为路由与缓存问题,而不仅仅是模型选择决策。按工作负载选择 Claude 模型,选择合适的跨区域推理配置文件,并为稳定的提示前缀配置与各层变化频率相匹配的 TTL 缓存。
在生产环境中扩展智能体的最佳实践
提炼自 Postman 的实践历程,面向在 Amazon Bedrock 上工作的构建者:
- 像规划 token 一样仔细规划工具。 按任务动态选择要暴露的工具。在 Postman 的测试中,随着可见工具集变大,工具选择错误有所增加。
- 优先使用具备模式感知的读取,而非不断增加工具。 把数据模型设计好,让智能体去查询它。
- 将智能体操作与界面状态解耦。 如果某个工具需要打开标签页,说明智能体是在操作界面,而不是直接对数据进行推理。
- 有意识地设计上下文。 专门构建的上下文处理器胜过每次都序列化渲染模型。
- 将上下文窗口视为稀缺资源。 截断与扩展策略是一等设计问题,而非事后考虑。
- 功能与文档同步交付。 RAG 知识库只有与产品同步演进,才能持续有用。
- 在 Bedrock 上进行路由和缓存。 将每个工作负载匹配到合适的 Claude 模型,根据吞吐量和地理要求选择跨区域推理,并对稳定的提示前缀应用分层缓存。
结论
构建 Agent Mode 要求 Postman 直面大语言模型能力与成熟产品结构之间的差距:接口假设、耦合的客户端、庞杂的工具目录,以及分散在文档和团队中的知识。动态工具选择、基于 schema 的读取,以及有意识的上下文工程,在 Postman 开发者社区 的规模上成为可复用的模式。Amazon Bedrock 提供托管模型访问、跨区域推理、依赖模型的保留控制以及提示缓存,为生产架构提供支撑。
无论你是在构建第一个 agent,还是在扩展现有的 agent,这些模式都能帮助团队避开常见的 agent 集成与扩展挑战。
如需了解更多,请参阅 Amazon Bedrock 文档,其中包括关于跨区域推理、提示缓存以及数据保护与保留的指南。相关实现指导,请阅读 AWS Machine Learning Blog 上的在 Amazon Bedrock 上高效使用提示缓存和Amazon Bedrock 宣布推出全球跨区域推理以提升吞吐量。如需了解该产品,请参阅 Postman Agent Mode 文档。
Postman 的生产实现为专有代码,不提供公开的示例仓库。
关于作者

Srinivas Kini
Srinivas 是 Postman AI 团队的高级工程师,在分布式系统与 AI 基础设施的交汇处构建企业级 agent。他的工作重点是核心 agent 架构,使 agent 在大规模下保持可靠与准确。

Shubham Gupta
Shubham 是 AWS 的解决方案架构师,常驻印度班加罗尔,为独立软件供应商(ISV)提供支持。他与工程和领导团队合作,在 AWS 上设计、构建并运行他们的产品,从最初的架构到生产环境,尤其专注于生成式 AI 和大规模韧性。工作之外,Shubham 是一位热衷徒步的人,他把从山径上带来的同样充分的准备与坚持,投入到构建持久可靠的系统中。