StateBench 发布:测试语言模型如何在长文档中追踪状态变化
StateBench: Testing how language models track state changes over long documents
AI 导读
Allen AI 在 Hugging Face 发布 StateBench,一个按四级难度测试语言模型长上下文状态追踪能力的基准,并同步公开技术报告、数据和代码。
摘要与补充说明
四级难度从不可变赋值、按值重新赋值,到自引用更新和按引用赋值,对应 Krohn–Rhodes 理论中的不同状态追踪类别。测试显示,Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol、Luna 在较简单层级表现良好,但在 soluble 和 general finite 层级上随输入变长准确率骤降,最长输入时低至 13% 或以下。
正文· AI 翻译
我们推出 StateBench,这是一个用于评估长上下文状态跟踪能力的基准测试——即语言模型在长文档中跟踪实体信息随其演变的能力。
状态跟踪是许多任务的基础,从阅读代码(其中变量被赋值和重新赋值)到跟随故事情节(角色在物理空间中移动、物品易手)。例如,如果一部悬疑小说在谋杀发生前写道“John 把刀给了 Mary”,那么了解每个角色的状态已经发生变化就很重要。然而,并非所有状态跟踪问题的难度都相同:有些只需要找到最新的更新;更难的则需要跟踪一连串变化,其中漏掉一步就可能导致最终答案出错。例如,我们悬疑状态跟踪的一个更难变体是:John 把背包里的物品给了 Mary,而此前已知 Edward 把一把刀放进了 John 的背包。
Transformer 在具有长依赖链的困难状态跟踪变体上存在有据可查的理论局限,这推动了循环和混合架构(如 Gated DeltaNet)的发展,这类架构会携带一个持续更新的记忆。现有的状态跟踪测试往往聚焦于最难的情况,但随着这些设计越来越常见,研究人员需要了解每种架构能够处理哪些类型的状态跟踪。我们希望不仅理解各架构在最难的状态跟踪类型上的差异,也理解它们在更简单、可能更常见的类型上的差异。
为此,我们开发了 StateBench 基准测试,以涵盖不同复杂度的状态跟踪问题,并用它来评估不同架构的语言模型之间的差异。我们发现,当直接在这些任务上训练时,循环模型和混合模型能够比 Transformer 泛化到远得多的范围;而包括 Gemini 3.8 Flash、Claude Opus 5.5 以及 GPT-6 Sol 和 Luna 在内的前沿模型,在输入变长时,面对更难的状态跟踪形式仍然会失效。
状态跟踪的四个层级
StateBench 包含四个难度层级,允许越来越复杂的状态更新操作。对于程序员来说,这些状态跟踪复杂度层级可以理解为允许不同类型的变量赋值操作:
- R-平凡问题使用不可变赋值。变量的值永远不会改变,因此模型只需要恢复它最初被设定的值。在代码中,这看起来像 let x = 4;在日常生活中,这就像出生日期——它保持不变。
- 非周期问题允许按值重新赋值。模型需要找到最近的值,并且可以忽略更早的值。在代码中,这看起来像先 x = 4,之后又 x = 2;在日常生活中,这就像恒温器,最新的设置决定当前温度。
- 可解问题增加了自引用更新。每次更新都基于当前值,因此模型必须将变化向前传递,而不是简单地找到最新的赋值。在代码中,这看起来像 x = x + 5;在日常生活中,这就像游戏得分,每得一分都会累加到总分中。
- 一般有限问题通过引用进行赋值。一个变量可以取另一个变量的当前值,从而在多次更新之间形成依赖。在代码中,这看起来像 x = y 或交换两个变量。想象一位魔术师把球藏在五个杯子中的一个下面,然后反复交换它们的位置。找到球意味着要跟踪这些交换如何改变它的位置。这说明了 S₅ 状态跟踪问题:跟踪连续交换如何重新排列五个对象。它属于我们四个层级中最难的一级,并在此前关于状态跟踪极限的研究中有所讨论。
这些层级可以从变量赋值的角度直观理解,但它们也代表了 Krohn–Rhodes 理论中具有理论动机的状态跟踪区分。Krohn–Rhodes 理论是代数的一个分支,描述状态跟踪问题——可视为有限幺半群上的字问题——如何分解为原子原语。我们层级中的每一级都对应一类状态跟踪问题,这类问题可以由一组不同的原语构建而成。
为了公平比较这四个层级,我们从一个一般的有限变量赋值序列出发,并从中派生出三个更简单的版本,从而生成四个可比较的 StateBench 问题——每个难度层级各一个。这四个问题都使用相同数量的变量和不同的值,赋值出现在序列中的相同位置;只有赋值的类型发生变化。
我们的发现
预训练模型
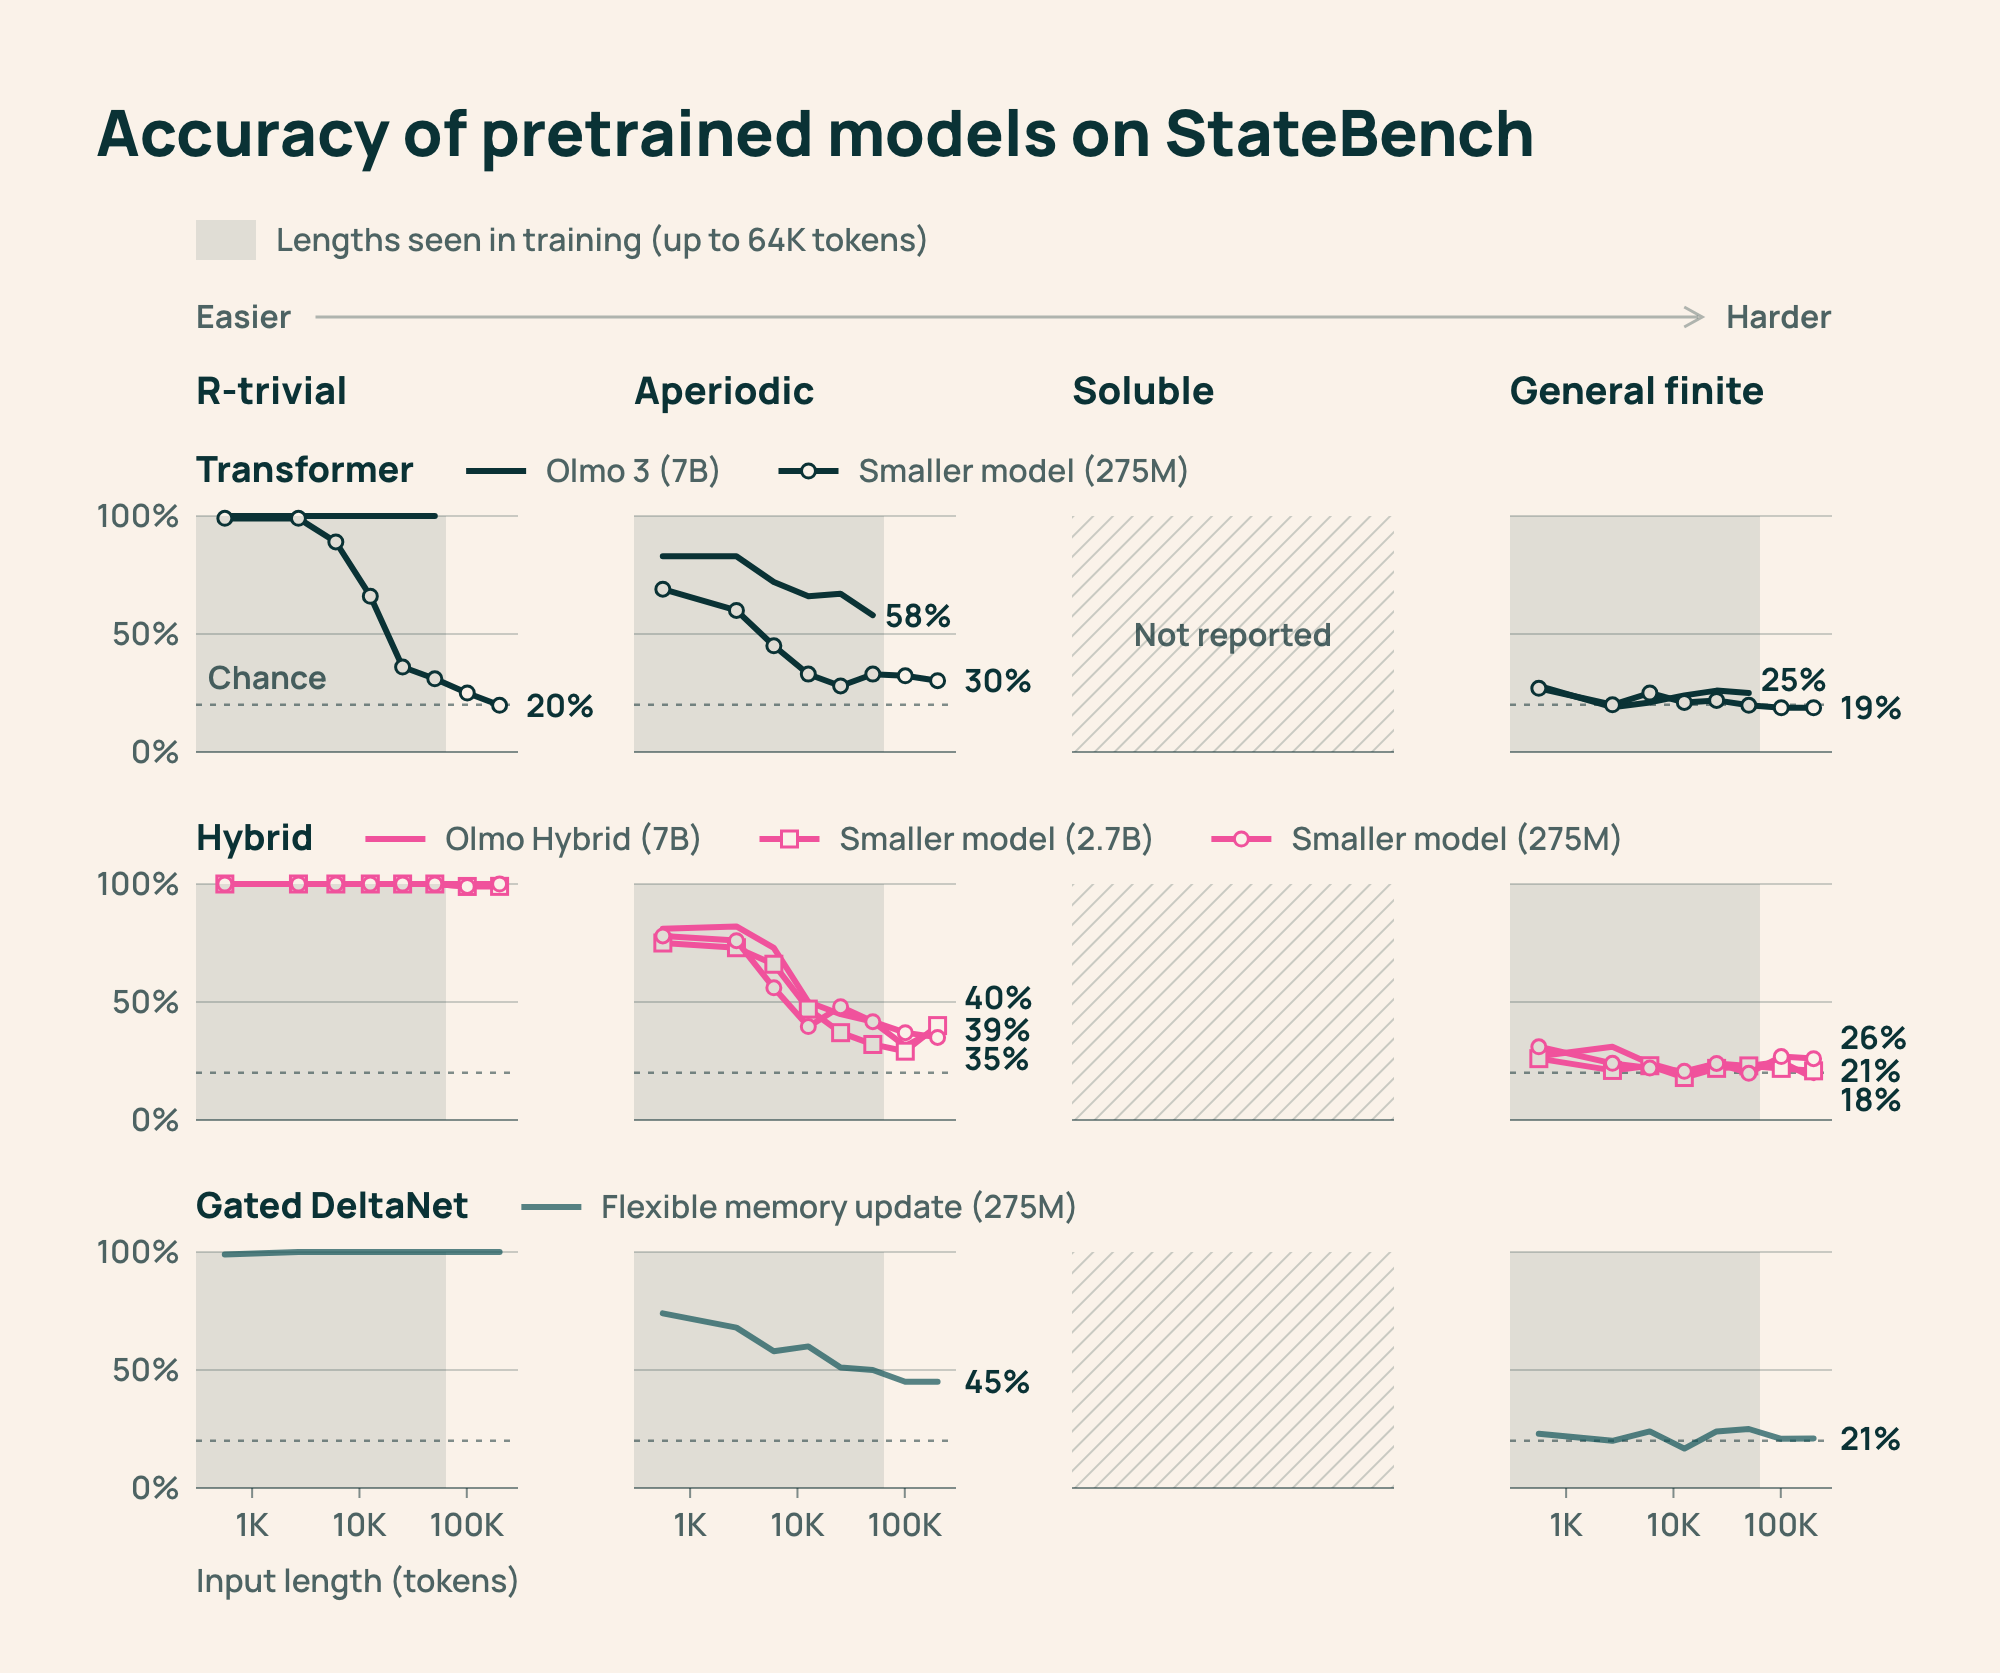
我们在 StateBench 的 r-trivial、非周期和一般有限层级上测试了一系列开放预训练模型,以观察它们的状态跟踪在何处失效,以及不同架构是否会在理论预测的地方失败。在标准理论假设下,transformer 能够稳健地处理 r-trivial(并在一定程度上处理可解和非周期问题),但预计会在一般问题上失败。相比之下,具有更灵活记忆更新的 Gated DeltaNet 原则上可以处理全部四个层级。
我们从开放预训练模型开始,这些模型的训练数据和上下文长度都有完整记录。其中包括两个 70 亿参数模型 Olmo 3(transformer)和 Olmo Hybrid(增加了 Gated DeltaNet 层),以及 2.75 亿和 27 亿参数的较小模型。所有这些模型都在相同数据上预训练;训练期间没有一个模型见过超过 64,000 个 token 的上下文,而我们测试大多数模型时使用的输入远超该长度。
在给每个模型评分时,几乎所有模型在 r-trivial 问题上表现良好,随着输入增长在非周期问题上失去准确率,而在一般有限问题上停留在随机水平。问题格式在这里很重要——2.75 亿参数的混合模型和 Gated DeltaNet 模型在 RULER 风格的 r-trivial 问题上得分接近上限,但在以电子表格编辑形式表述的相同问题上却接近随机水平。这一差距正是 StateBench 以多种格式测试同一底层问题的原因之一。
前沿模型
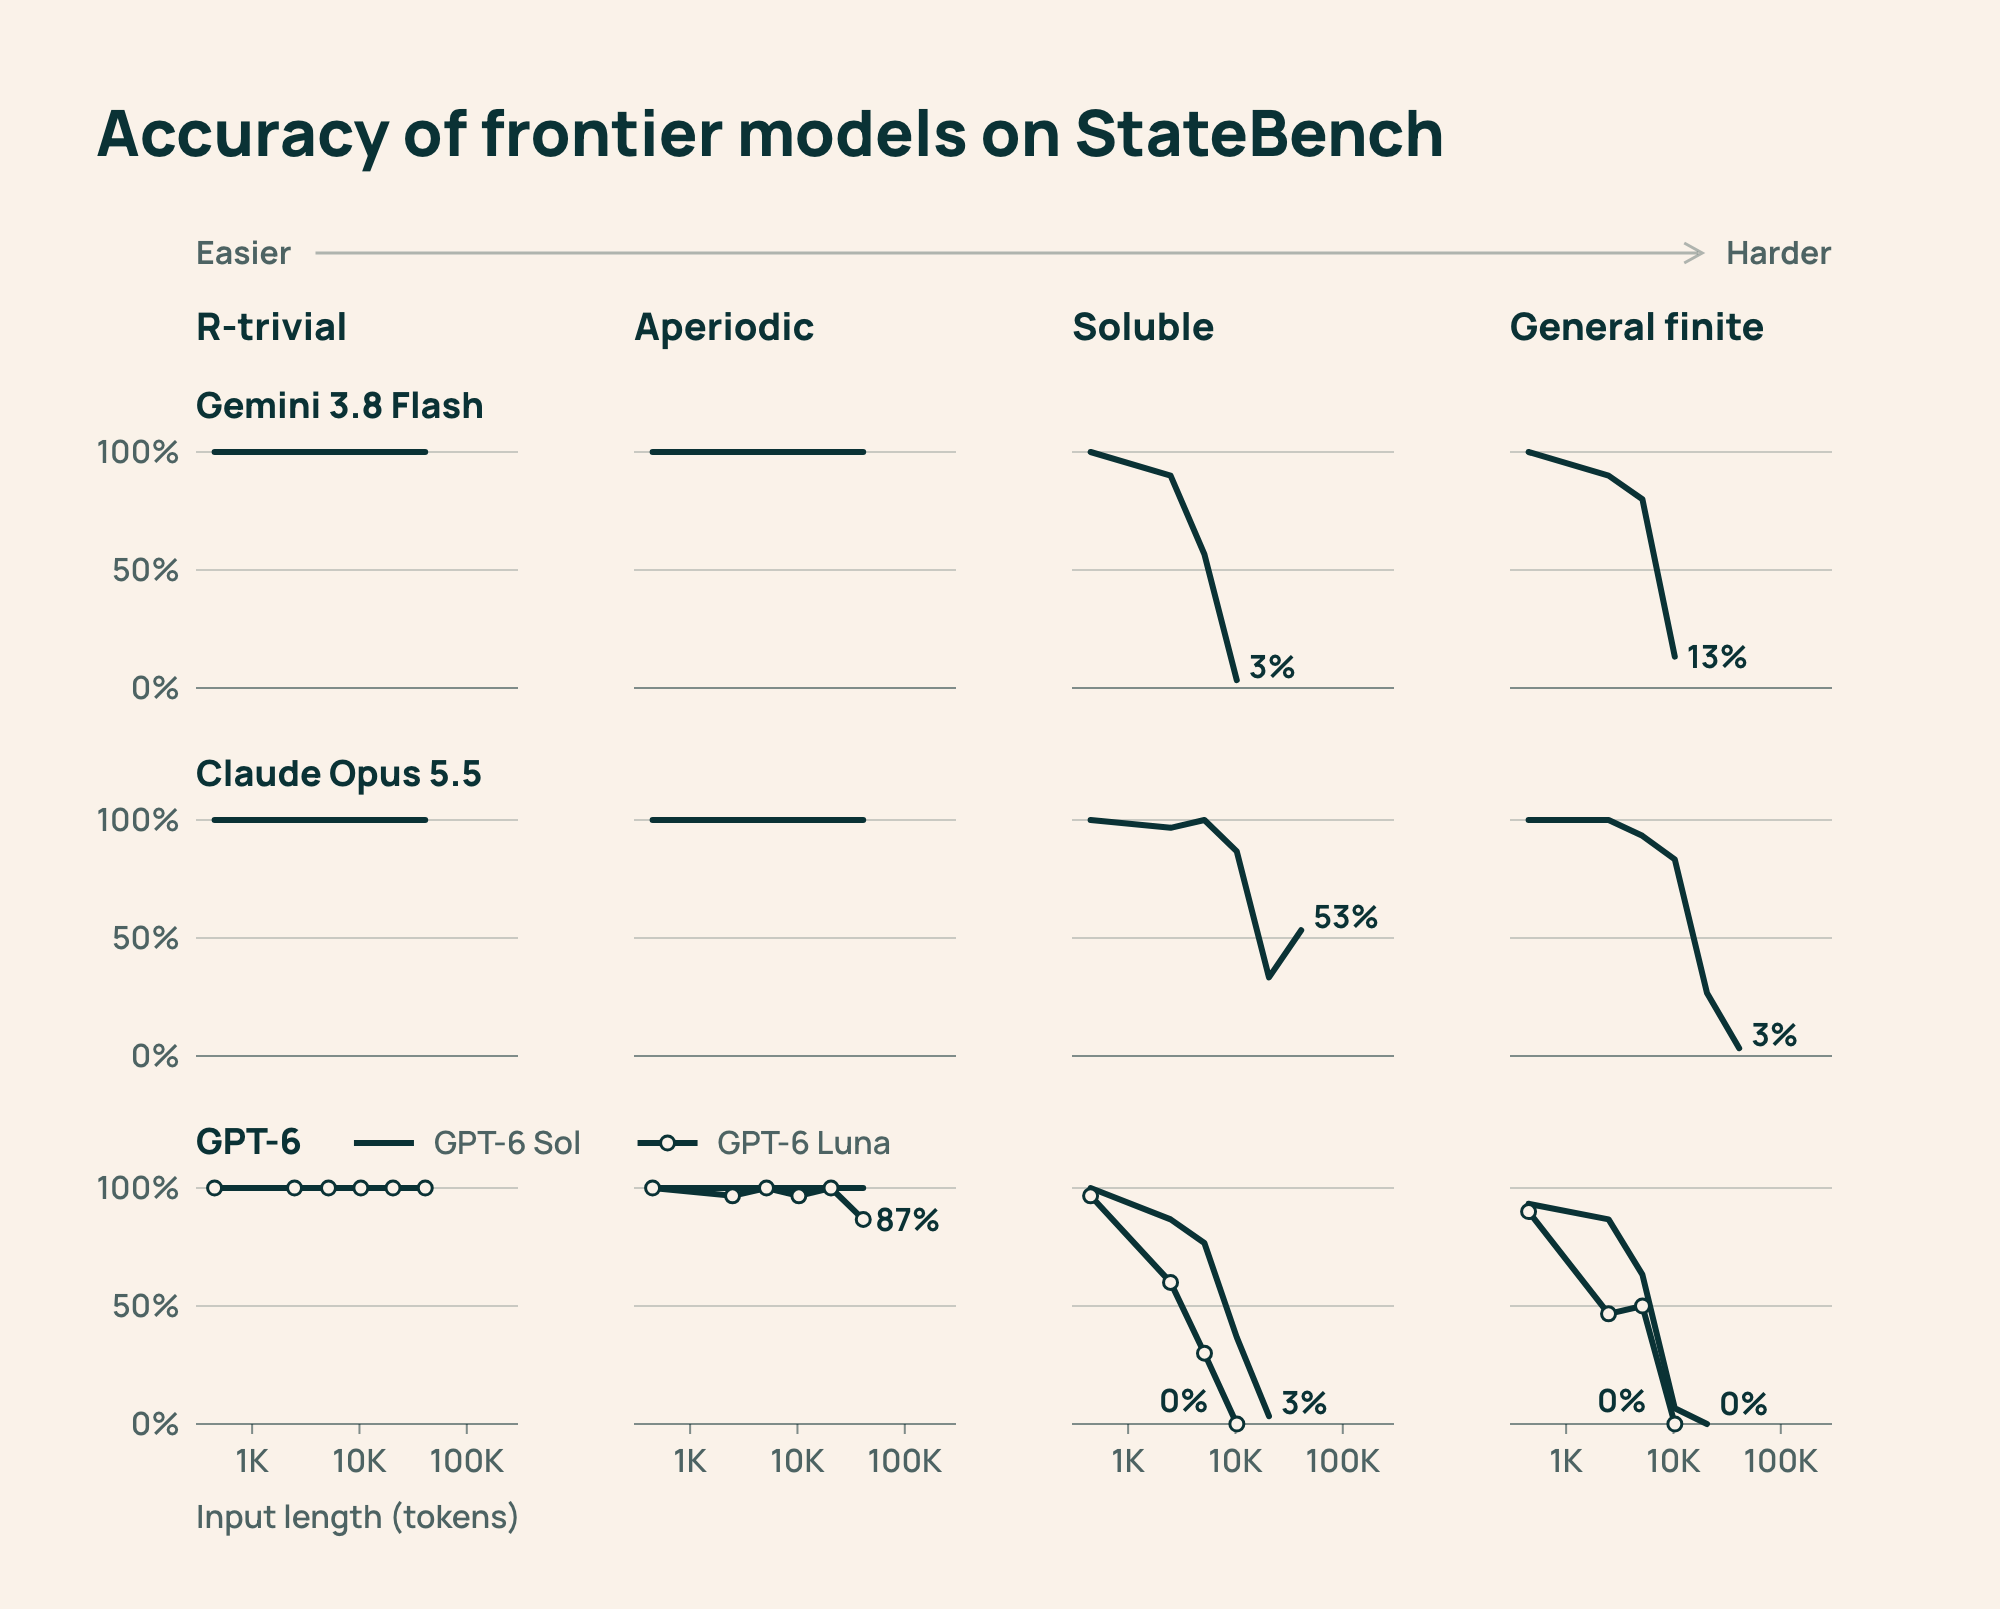
随后我们测试了四个前沿模型——Gemini 3.8 Flash、Claude Opus 5.5,以及 GPT-6 Sol 和 Luna——要求它们读取每个变量赋值序列并生成每个变量的最终值。
这四个模型在 r-trivial 和非周期问题上都表现良好。但在可解和一般有限问题上,随着输入变长,准确率急剧下降,在最长的通用有限问题上降至 13% 或更低。一个可能的因素是敏感性;在这些更难的级别上,更多步骤可能影响最终答案,留给模型在不导致结果错误的情况下漏掉一次更新的余地更小。
直接在任务上训练的模型
接下来,我们研究了模型在更难级别上的困难反映的是架构本身的局限,还是预训练根本没有教会模型解决这些问题。有针对性的直接训练是一种更有利的设置,它揭示了状态跟踪问题在多大程度上源于底层架构和优化器,而非用于预训练模型的数据。
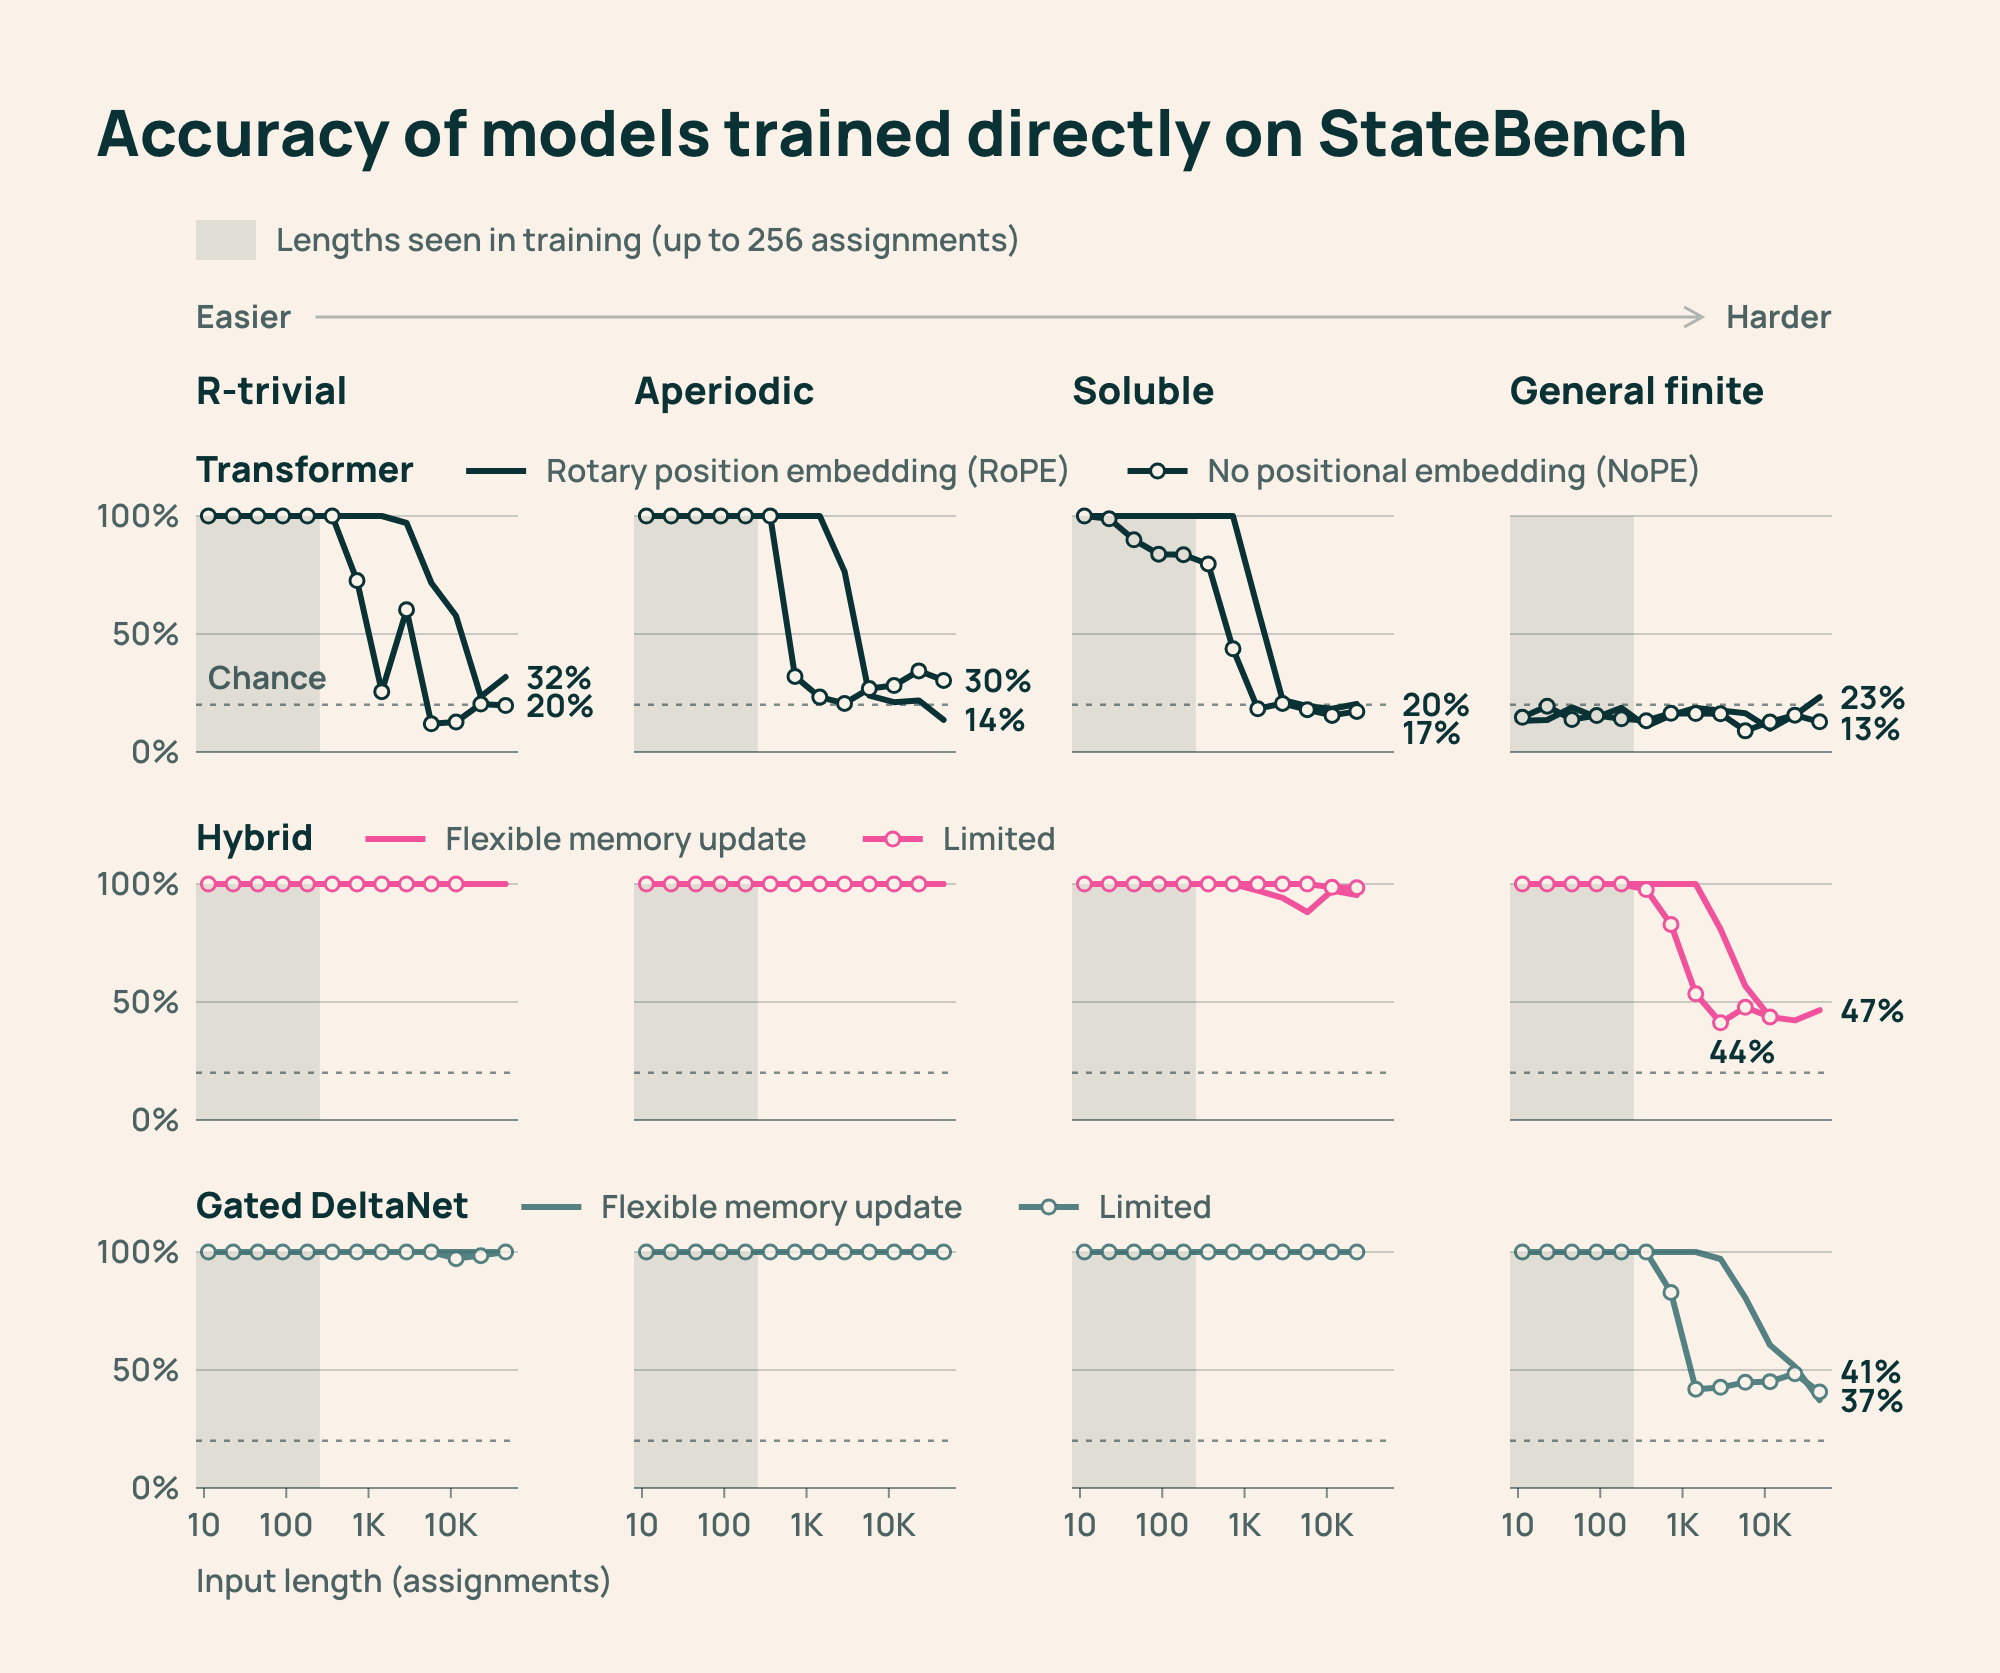
我们从零开始在 StateBench 上训练了若干个 2.75 亿参数的模型:两个 transformer 变体、两个混合模型,以及两个具有不同记忆更新约束的 Gated DeltaNet 变体。这些模型在最多 256 个赋值的序列上训练,并在长达 64,000 个赋值的序列上测试,即最大训练长度的 250 倍。
随着序列变长,各架构开始出现分化。Gated DeltaNet 和混合模型在 r-trivial、非周期和可解问题上几乎完美地泛化到我们测试的最长序列,即数万个赋值。Transformer 学会了较简单的级别,但在更长的序列上性能下降,而且它们从未学会一般有限问题。在最难的级别上,记忆更新更灵活的 Gated DeltaNet 变体泛化得最远,在训练期间所见最长序列长度约 10 倍的范围内保持接近完美。
对于 Gated DeltaNet 和混合模型,这一差距指向训练而非架构;经过直接训练,它们学会了处理其预训练对应模型无法处理的状态跟踪级别。Transformer 则不同——即使经过直接训练,它们也永远无法学会最难的级别。
开放问题与发布
一些问题仍然悬而未决。我们的新证明表明,在论文的带舍入固定精度算术下,记忆更新更受限(非负特征值)的 Gated DeltaNet 可以解决所有非周期任务和某些周期任务,例如跟踪某个重复输入是否出现了偶数次或奇数次。它在层级中的确切位置仍然未知,包括它能否解决所有可解任务,以及数值精度或将其与注意力层结合会如何影响其能力。StateBench 还假设变量数量固定,而真实任务往往随时间引入新实体。例如,在一段长对话中,随着对话展开,新的人物和对象可能出现,模型也必须开始跟踪它们。当前框架尚未涵盖这种设置。
随着新型循环架构和混合架构不断涌现,理解每种架构能处理哪些类型的状态跟踪,有助于指导未来系统的开发和训练方式。我们希望 StateBench 能为研究人员提供一种更细粒度的方法,来找出模型在何处失效——并为仍然不足的能力构建训练和评估数据。更根本地说,我们希望它能成为研究人员开发具有比当前模型更稳健状态跟踪能力的新架构的北极星。