Circle K 如何用 Amazon Bedrock 将 DevOps 事故分诊缩短至 15 分钟内
How Circle K accelerated DevOps incident triage to under 15 minutes with Amazon Bedrock
AI 导读
Circle K 基于 Amazon Bedrock 构建智能体 AI 分诊系统,将事故平均分诊时间从 45–60 分钟降至 15 分钟以内,按其内部事故响应指标计算降幅为 67%–75%。
摘要与补充说明
该系统在 Grafana 告警触发后自动调查事故,并向 Slack 推送结构化摘要,值班工程师可直接获得可执行上下文。系统最初用 Amazon Bedrock Flows 编排多个专用智能体,后迁移至 Amazon Bedrock AgentCore。Circle K 在 27 个国家运营超过 17,200 家便利店和燃油零售店,其 POS、会员及电动汽车充电应用运行在 AWS 上。
正文· AI 翻译
本文与 Circle K 的云 DevOps 工程师 Marek Klatowicz 共同撰写。
许多 DevOps 团队都熟悉事件分诊的模式:告警触发后,在任何人能够解决问题之前,工程师要花 45–60 分钟弄清楚发生了什么。他们拉取日志、检查服务健康状况,并在若干工具之间关联症状。所有这些都发生在补救工作开始之前。
在 Circle K,这一挑战随着业务规模而放大。该公司在 27 个国家运营着超过 17,200 家便利店和燃油零售门店。在门店背后,一套云原生基础设施支撑着运行在 AWS 上的销售点系统、忠诚度应用和电动汽车(EV)充电应用。随着公司扩展其数字运营,分诊开销也随之增长。更多服务意味着更多告警,而每一个告警都需要在补救开始前进行同样的手动调查。
为解决这一问题,Circle K 使用 Amazon Bedrock 构建了一套自动化分诊系统,这是一项完全托管的服务,可通过单一 API 使用基础模型(FM)。有关各 AWS 区域内的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。该系统采用智能体式 AI 架构,自主调查每一起事件,并在告警触发后几分钟内向 Slack 发送结构化摘要。值班工程师现在收到的不再是原始告警,而是可操作的上下文,因此他们可以立即采取行动,而不必花一小时弄清楚发生了什么。
自部署该系统以来,Circle K 已将平均分诊时间缩短至 15 分钟以内,根据团队内部的事件响应指标,降幅为 67–75%。
在本文中,我们介绍初始 Amazon Bedrock Flows 实现以及迁移到 Amazon Bedrock AgentCore 的架构,并分享在扩展该系统过程中获得的经验教训。
分诊开销的挑战
Circle K 的 DevOps 团队使用 Grafana 监控多个 AWS 账户中的基础设施。典型的一天会带来容器重启、错误率升高、延迟飙升和部署失败等告警。每个告警都是有用的信号,但随着系统扩展,团队希望帮助值班工程师快速看到哪些信号需要关注,并附带正确的上下文。
当告警到来时,分诊涉及一系列熟悉的手动步骤:查看 Amazon CloudWatch 中的近期日志,检查 Amazon OpenSearch Service 中的应用级追踪,查看 Amazon Elastic Container Service(Amazon ECS) 任务状态,并将症状与 GitHub 中的内部运行手册进行交叉比对。这为工程师提供了所需的信息,但也表明随着更多服务接入,将需要多少重复性的上下文收集工作。
团队认识到有两个领域可以通过前瞻性投入获益。首先,相同的日志查询、健康检查和运行手册查找会在每起事件中重复进行。其次,分诊的深度和速度可能因值班工程师对受影响服务的熟悉程度而异。随着告警数量和服务归属的增长,每次调查都要在多个工具之间切换,可能会拖慢响应速度,并使团队最佳实践难以一致地应用。
因此,Circle K 的 DevOps 团队启动了一项研发(R&D)计划,探索 AI 如何支持监控和事件分诊。目标是自动化重复性的上下文收集,并提供结构化、可操作的发现,同时在调查过程中支持工程师的运维判断。
Circle K 为何选择 Amazon Bedrock
在构建之前,团队评估了多种方案,包括在自管理基础设施上运行的开源智能体框架。那种方案意味着要自行负责模型托管、提示词版本管理、工具编排和安全控制。
借助 Amazon Bedrock,团队避免了这些额外负担。他们可以通过单一 API 访问基础模型,并在无需重写代码的情况下更换基础模型。由于 Circle K 已在 AWS 上运行,Amazon Bedrock 能够融入现有的 AWS Identity and Access Management(IAM)策略、Amazon Virtual Private Cloud(Amazon VPC)配置和日志管道。
两项托管能力覆盖了编排和检索。Amazon Bedrock 帮助进行智能体编排,为智能体提供原生工具使用能力,使其能够调用 AWS API、查询数据库和检索文档,而无需自定义编排代码。Amazon Bedrock Knowledge Bases 这一全托管检索增强生成(RAG)能力负责内部产品卡片的摄取和检索,因此团队无需运行单独的向量数据库。这让 DevOps 团队能够专注于提示词设计和工具定义。
数据隐私补全了整体方案。Circle K 的事件数据包括运维指标、基础设施详情和可能包含敏感信息的日志。Amazon Bedrock 不会与模型提供商共享客户数据,也不会将其用于训练基础模型。对于一个将生产日志和内部服务详情输入系统的团队来说,这种数据处理方式满足了 Circle K 的安全要求。
解决方案概览
本节介绍初始架构,团队基于 Amazon Bedrock Flows 构建了该架构。后续章节将介绍迁移到 AgentCore 的过程。
该解决方案使用 Amazon Bedrock Flows 作为编排层,协调一组专用智能体,每个智能体负责分析的不同部分。当 Grafana 告警向 Amazon Simple Notification Service(Amazon SNS)发布通知时,流水线启动,SNS 将通知转发到 Amazon Simple Queue Service(Amazon SQS)队列。一个 AWS Lambda 函数轮询该队列,提取告警负载并调用 Flow。
在 Flow 内部,两个智能体被并行调用。AWSResourceExplorerAgent 跨多个由 AWS Organizations 管理的工作负载账户查询基础设施。它检查 Amazon ECS 任务状态、Application Load Balancer 目标健康状况以及 CloudWatch 指标和日志。与此同时,OpenSearchExplorerAgent 查询 Amazon OpenSearch Service 以获取应用级日志和分布式追踪。该智能体单独运行,因为 OpenSearch 会返回大量日志数据。将其隔离可使每个智能体的上下文窗口保持可控。它还拥有对知识库的独占访问权限,该知识库包含描述每项服务及其依赖关系的产品卡片。
两个 agent 都返回结果后,GitHubExplorerAgent 开始运行。它接收前两个 agent 的输出,并找到受影响服务的 GitHub 仓库。然后它搜索这些仓库的应用代码、基础设施定义和最近的提交,以精确定位问题根源并提出具体修复方案。在并行 agent 之后运行它,意味着它确切知道要搜索什么,而不是执行宽泛的查询。
三个输出都汇入一个 AnalysisPrompt 节点,该节点是一次不带任何工具的单一模型调用。它接收 AWS 资源数据、OpenSearch 日志和 GitHub 上下文,然后生成结构化摘要:可能的根本原因、支持证据、受影响的服务及负责人,以及建议的修复步骤。提示输出采用一致的格式,值班团队可在 2 分钟内浏览完毕。
Flow 将此摘要返回给调用它的 Lambda 函数,后者将其发布到 Slack 频道。从告警到 Slack 消息的整个过程耗时 5–15 分钟,具体取决于事件的复杂程度。
下图展示了该架构的端到端流程,从最初的 Grafana 告警到最终的 Slack 摘要。

图 1:使用 Amazon Bedrock Flows 的 Circle K 自动事件分诊架构
分诊示例
一条 Grafana 告警:某服务的 HTTP 5xx 错误率连续 3 分钟超过 5%。
AWSResourceExplorerAgent 检查目标账户中的 ECS 任务健康状况,发现数据库连接池耗尽,ECS 服务正在尝试重启。OpenSearchExplorerAgent 返回的应用日志显示,该服务向其后端 PostgreSQL 数据库报出“connection refused”错误。它还从知识库中检索了受影响服务的产品卡片,其中记录了该服务对该数据库的依赖。GitHubExplorerAgent 搜索该服务的仓库和基础设施文件,找到了 Amazon Relational Database Service(Amazon RDS)的定义。它发现该服务为每个请求都打开一个新的数据库连接,而不是复用现有连接。
AnalysisPrompt 接收全部三个结果。它将时间点与告警前 10 分钟开始的一次计划营销活动关联起来。它结合 GitHubExplorerAgent 的发现,建议进行具体的代码级修复,而不是临时补丁。
最终的 Slack 消息内容为:
Summary: XYZ Service 5xx errors caused by connection pool exhaustion
Root cause: Scheduled marketing campaign drove traffic spike; connection pool max (50) insufficient for load
Evidence: OpenSearch logs show "connection refused" at 14:32 UTC; ECS shows 3 task restarts since 14:30
Owner: XYZ team (backend)
Next steps: Add Amazon RDS Proxy to pool connections, or update the service to reuse existing connections instead of opening a new one per request; consider an Auto Scaling rule for future campaigns
扩展到 Amazon Bedrock AgentCore
Amazon Bedrock Flows 架构运行良好达数月之久,简单事件可在 10 分钟内完成分诊。随着时间推移,尽管服务集合保持不变,但每次调查背后的数据量和上下文都在增长。有些事件需要比单个 Flow 节点所能完成的更长时间的分析。
团队首先在现有设计内进行优化:更积极地过滤日志、缩短上下文窗口,并将某些服务拆分为独立的 Flow。这些措施有所帮助,但日志量和知识库仍在持续增长。
Amazon Bedrock AgentCore 满足了这一需求。AgentCore 是一个平台,可使用任意框架或模型大规模构建、连接和优化 AI agent。对于此工作负载,关键能力是 AgentCore Runtime:整个调查在单个会话中运行,因此每个步骤都可以按其数据所需的时间进行。AgentCore Runtime 支持最长 8 小时的会话,远超当前调查所需。团队将其 agent 逻辑容器化,并部署到 AgentCore Runtime 上。
下图展示了迁移到 Amazon Bedrock AgentCore 之后的生产架构。
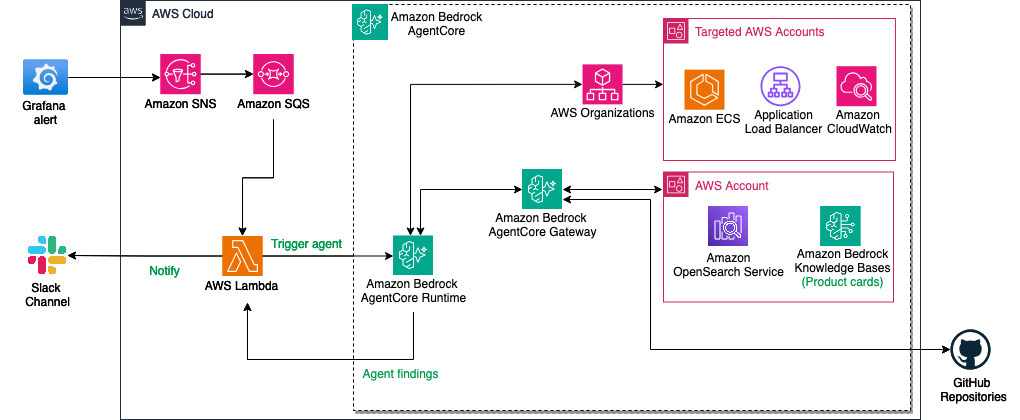
图 2:使用 Amazon Bedrock AgentCore Runtime 和 AgentCore Gateway 的生产架构
分析逻辑保持不变,但运行方式发生了变化。Flows 版本中的三个专用代理现在被整合为一个运行在 AgentCore Runtime 会话中的单一代理。Lambda 函数负责启动该会话,代理则执行与之前相同的步骤。它跨账户查询 AWS 资源、从 Amazon OpenSearch Service 拉取日志、搜索 GitHub,并从知识库中检索产品卡片。代理会在 15 分钟内将发现结果返回给 Lambda 函数,这处于 Lambda 的最大超时时间之内。随后,Lambda 函数将结构化摘要发布到 Slack。
Amazon Bedrock AgentCore Gateway 是 Amazon Bedrock AgentCore 的一项能力,它代理该代理对其数据源的访问,包括 Amazon OpenSearch Service、Amazon Bedrock Knowledge Bases 和 GitHub。Gateway 将每个数据源暴露为代理可调用的工具,从而集中管理访问控制,并使团队更轻松地添加或更改数据源。
AgentCore Runtime 如何支持团队不断扩大的规模
除了支持更长时间的会话之外,Amazon Bedrock AgentCore Runtime 还增加了三项能力来支持团队不断扩大的规模:会话持久性、基于 OpenTelemetry 的可观测性以及框架灵活性。
会话持久性:代理在整个调查过程中保留中间状态。如果对日志的第一轮检查发现了某些线索,代理可以运行第二轮更有针对性的检查,而不会丢失已经建立的上下文。这契合了调查复杂的多服务事件时所采用的迭代方式。
可观测性:AgentCore 使用 OpenTelemetry 标准捕获每个会话的追踪数据,并通过 CloudWatch 呈现。团队可以查看每个步骤耗时多久、代理执行了哪些知识库查询,以及瓶颈出现在哪里。这些洞察会直接用于提示词调优。
框架灵活性:借助 AgentCore Runtime,团队可以部署使用多种框架构建的容器化代理。他们可以迭代代理逻辑、添加分诊步骤,或根据需求变化重构代理的推理方式,而所有这些都在同一个 Runtime 上完成。
AgentCore 架构现已在生产环境中运行,并处理各种范围的事件,从简单的单服务告警到大型多服务调查。
结果
Circle K 于 2026 年 4 月部署了 AgentCore 版本的分诊系统。根据团队内部的 incident-response 指标,平均分诊时间从 45–60 分钟降至 15 分钟以内,减少了 67–75%。简单事件可在 5–8 分钟内收到摘要。复杂的多服务事件此前需要超过一小时的人工分诊,现在可在 15 分钟内完成。
工程师现在从摘要开始,而不是自己收集上下文。团队看到事件处理方式发生了三项变化:
一致的分诊。每位值班工程师都会收到相同的结构化摘要,其中包含相同的日志摘录、知识库参考和推荐的后续步骤,无论他们对受影响服务的了解程度如何。
更快的升级。当问题需要其他团队支持时,摘要会为值班工程师提供相关上下文,以便及时、知情地升级。
更快处理误报。当分析发现服务健康且没有相关错误时,工程师可以确认告警并继续处理其他工作。
经验教训
构建这个系统经历了多次迭代。以下四条经验对使用 Amazon Bedrock 构建类似解决方案的团队具有借鉴意义。
将日志内容直接包含在提示中。早期版本只传入日志组名称和时间范围,然后由代理尝试通过操作组查询 CloudWatch。这增加了延迟,而且返回的数据往往过多,难以处理。Circle K 通过让 Lambda 函数预先查询日志并将相关日志行直接传给代理,获得了更好的结果。当代理能够读取实际的错误消息时,其推理速度更快。
针对用例调整检索和生成。检索配置显著影响了知识库的结果质量。在测试了可用选项后,Circle K 团队发现采用默认配置的 Amazon Bedrock Knowledge Base 最适合他们的数据。Amazon Bedrock 端到端处理嵌入、索引和向量存储,因此团队需要维护的组件更少。在生成方面,精心设计的系统提示和调优后的温度设置能够在 Slack 中生成一致的摘要。
利用日志中的发现缩小代码搜索范围。在没有线索的情况下搜索服务的代码仓库会返回过多结果,难以发挥作用。团队在完成 AWS 资源和日志分析后再运行 GitHub 搜索,因此代理已经知道要查找哪个错误、组件或最近的变更。在示例分诊中,代理正是通过这种方式发现该服务为每个请求都打开了一个新的数据库连接。
保持分析逻辑独立于编排层。分析时间随数据量增长,因此要预计调查耗时会越来越长。团队将提示、工具定义和分析步骤与流程结构分开。这使得他们能够将这些内容整合到 AgentCore Runtime 上的单个代理中,而无需重写分诊逻辑。
后续步骤
目前,分诊系统会找出可能的根本原因并建议修复方案,然后由工程师执行修复。接下来,团队计划与 AWS DevOps Agent 集成,使系统还能处理简单的修复操作。示例包括重启任务、扩展服务或回滚部署。工程师将在 Slack 中批准每个操作后再执行。
团队还计划为代理提供更多可用的上下文:
- Jira,用于将每个事件关联到相关工单并跟踪后续工作。
- Confluence,用于将内部文档添加到代理已经读取的代码和日志中。
- 知识库中的运行手册,使代理能够将症状与已知的故障模式和之前有效的修复方法相匹配,而不是仅依赖产品卡片。
结论
Circle K 团队通过自动化工程师过去手动完成的上下文收集工作,将手动事件分诊时间从 45–60 分钟缩短到 15 分钟以内。系统从日志、AWS 资源和代码中收集数据,让代理对其进行推理,并将结构化摘要发送到 Slack。
团队在 Amazon Bedrock Flows 和 Amazon Bedrock Knowledge Bases 上构建了第一个版本。随着调查规模不断扩大,团队迁移到了 Amazon Bedrock AgentCore Runtime 上的单个代理,并由 AgentCore Gateway 提供对其数据源的访问。
如果您的团队将大部分事件响应时间花在收集上下文而不是解决问题上,这种模式就直接适用。要开始使用,请探索 Amazon Bedrock AgentCore 和 Amazon Bedrock Knowledge Bases。如需实践指导或与 AWS 专家讨论您的用例,请访问 Amazon Bedrock 入门页面或联系 AWS。
我们想了解您如何进行事件分诊。欢迎在评论中分享您的经验。
关于作者

Marek Klatowicz
Marek 是 Circle K 的云 DevOps 工程师,他与 AWS 合作,为企业终端客户设计和改进云服务。最近,他将大部分时间投入到 AI 领域,构建能够带来真正商业价值的解决方案。他信奉简单实用的解决方案。

Sefat Noor Orni
Sefat 是 Amazon Web Services 的解决方案架构师,她帮助企业在 AWS 上构建 AI 驱动的运维工具。她专注于生成式 AI 应用、智能体架构和 DevOps 自动化。工作之余,她喜欢尝试烹饪、音乐和家庭自动化项目。