如何在 Amazon SageMaker AI 上用知识蒸馏构建高效智能体
Build efficient agents with knowledge distillation on Amazon SageMaker AI
AI 导读
在 Amazon SageMaker AI 上,可用序列级知识蒸馏(SeqKD)把前沿"教师"模型的多步智能体轨迹迁移到更小、更快、更便宜的"学生"模型。
摘要与补充说明
SeqKD 只需教师模型的文本输出,无需 logits、权重或强化学习基础设施,因此对只能通过 API 访问的闭源前沿模型同样适用。做法是让教师生成搜索、读取、校验、决策的完整轨迹,用程序化评分器只保留真正完成任务的样本,再以监督微调训练学生模型,并在留出基准上评估。DeepSeek-R1 蒸馏模型即用教师生成的推理轨迹微调 Qwen 和 Llama 学生模型的知名例子。运行该示例需要具备 S3 读写权限和教师模型调用权限的 AWS 账户与 SageMaker AI IAM 角色。
正文· AI 翻译
你在前沿模型上构建了一个购物助手,而且它运行良好。购物者提出“来自一家至少 4.5 星店铺的、二十美元以下的黑色腰包”,智能体会搜索商品目录、检查候选商品、核对约束条件,并最终给出推荐。但这次交互的实际成本是多少?智能体助手并不是一次模型调用,而是一个循环:搜索、读取结果、细化、验证、决策。一个完成的任务可能需要对那个前沿模型进行多次调用,而每一次调用、每一位购物者,你都要付费。在生产规模下,这种按任务计算的成本会不断累积,侵蚀项目的 ROI,并导致项目无法上线。
让智能体应用更高效的一种方法是使用更小的模型,它响应更快,托管成本也更低。问题在于质量:小模型通常无法胜任该任务,而这正是当初选择大模型的原因。知识蒸馏通过将更大的“教师”模型的行为迁移到更小的“学生”模型中来弥合这一差距,训练学生模型复现教师模型的输出,从而以更小模型的速度和成本保留大部分质量。
在本文中,你将学习如何使用知识蒸馏,特别是序列级知识蒸馏(SeqKD),在 Amazon SageMaker AI 上微调购物智能体。我们将介绍如何用前沿教师模型生成高质量的多步轨迹并保留那些能解决任务的轨迹,如何将它们编码用于监督微调,如何在无服务器基础设施上运行训练,以及如何针对留出基准评估学生模型。
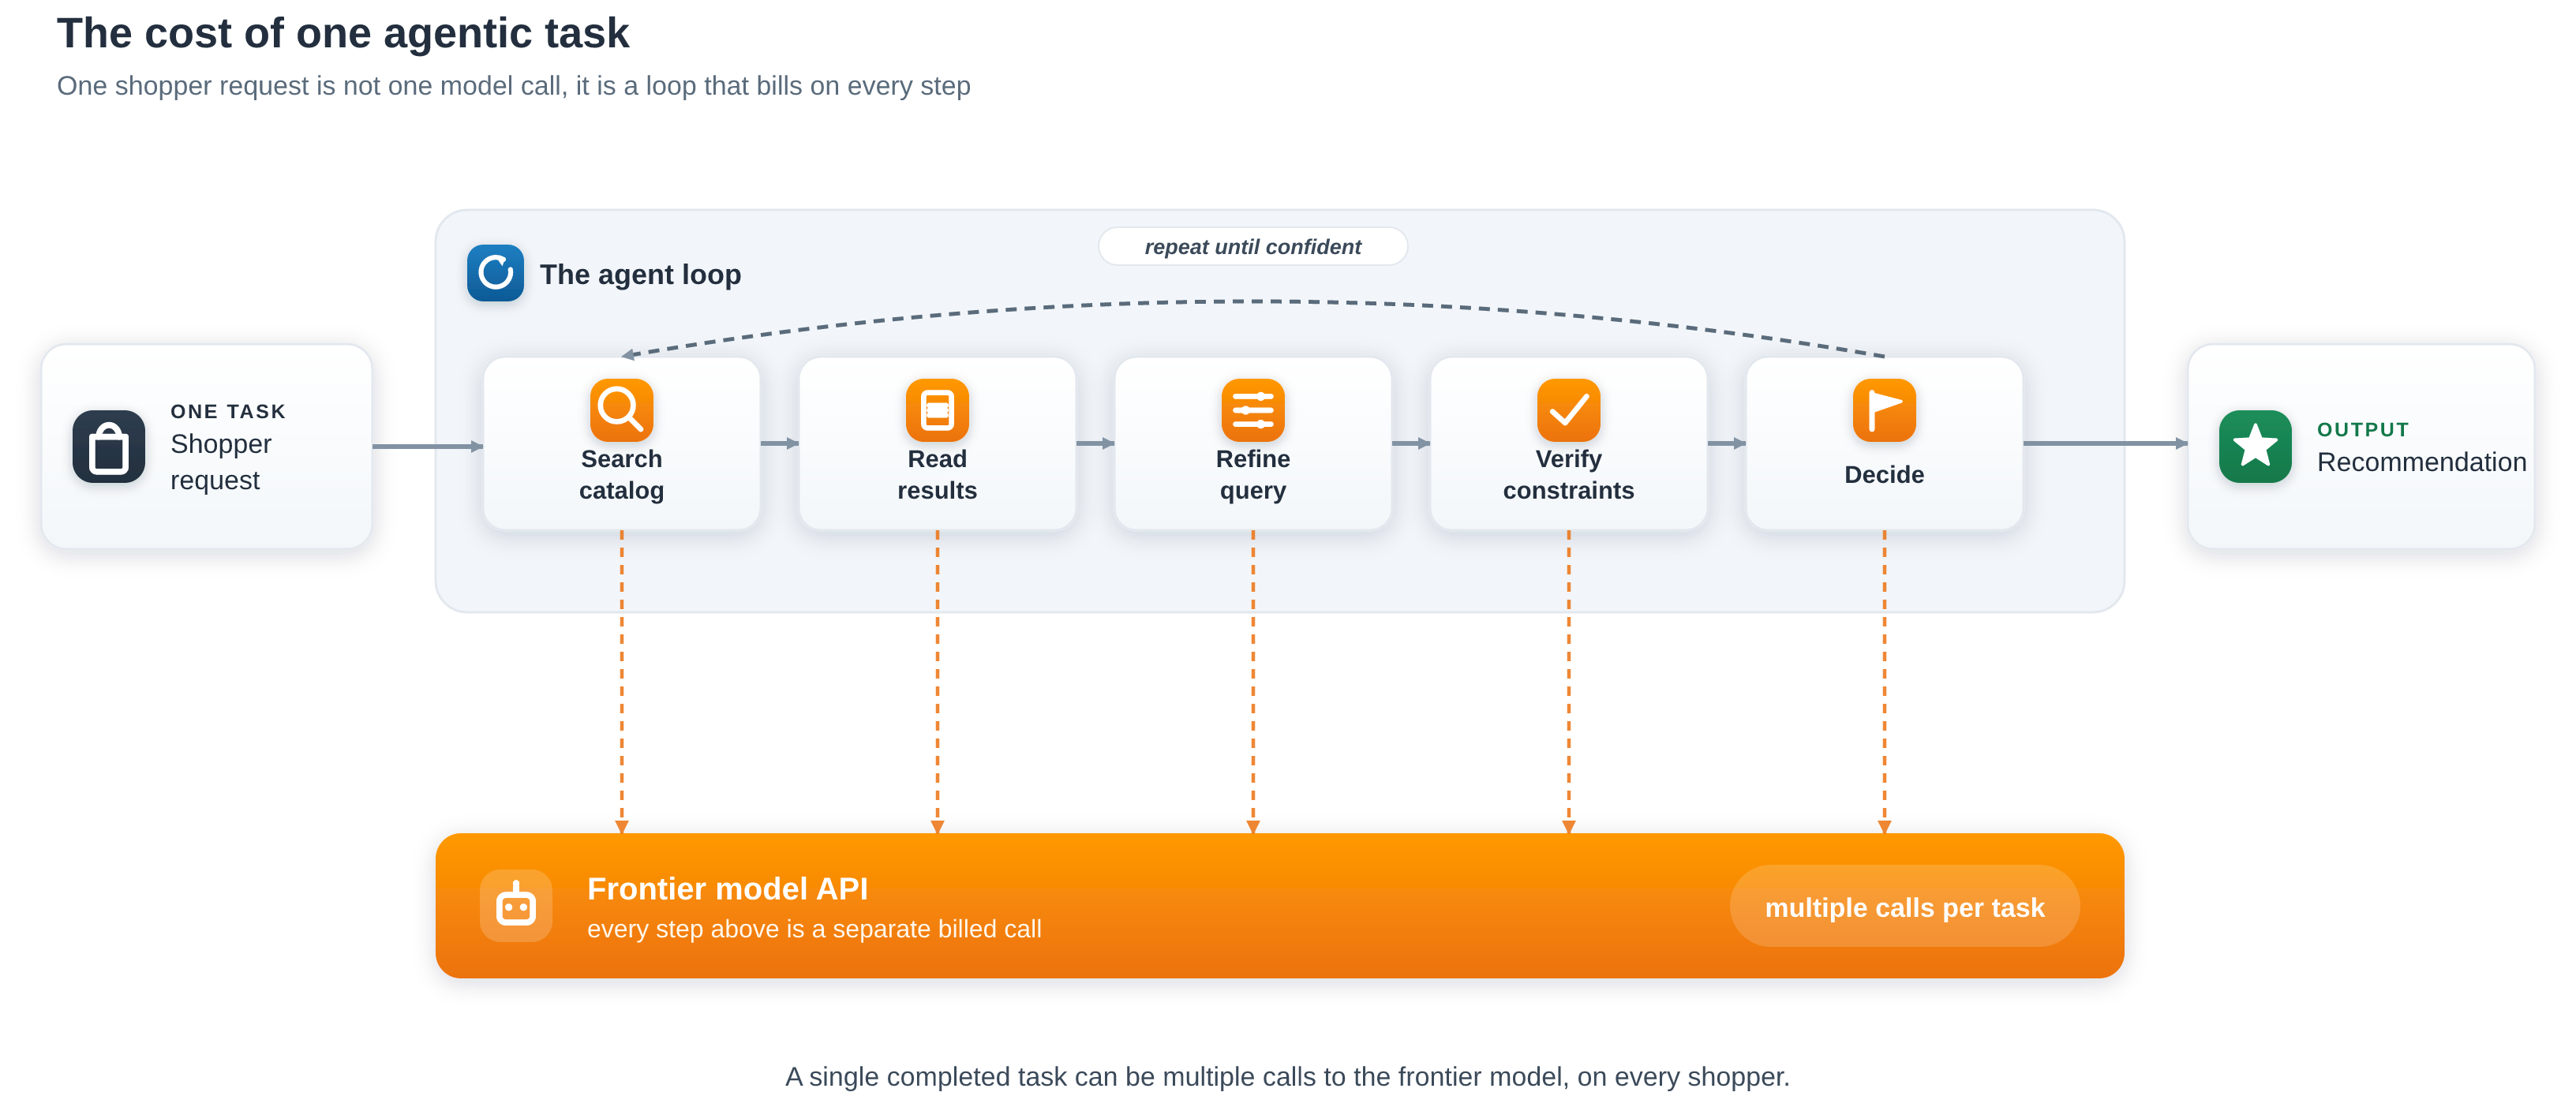
图 1:一个智能体任务是一个循环,而不是单次调用:智能体搜索、读取结果、细化、验证并决策,而每一步都是对前沿模型的一次单独计费调用。一个完成的任务可能包含多次调用,且针对每一位购物者
什么是序列级知识蒸馏(SeqKD)?
最简便适用的蒸馏形式是序列级知识蒸馏(SeqKD)。它使用教师模型生成高质量响应,然后通过监督微调(SFT)在这些响应上训练学生模型。SeqKD 只需要教师的文本,无需访问教师 logits,也不需要强化学习基础设施,因此即使教师模型是闭源的或仅提供 API,它也能奏效。与基于 logit 或 on-policy 等其他方法相比,它处于蒸馏谱系中最具成本效益且最易移植的一端。教师写出答案,学生则在这些答案上微调。由于这些答案会作为数据集持久保存,你可以复用它们来训练或测试不同的学生模型,而无需重新生成数据。
原则上,你会希望学生模型匹配教师模型在可能输出上的完整分布。但需要注意的是,你做不到。可能序列的空间极其庞大,因此精确匹配并不可行。SeqKD 通过用教师实际产生的样本进行近似,绕开了这一问题。
对智能体而言,教师模型产生的序列不是一段散文,而是一条轨迹,即由推理、工具调用及其返回的观察结果组成的有序运行过程,其中每一步都以之前的所有内容为条件。在整个序列上训练学生模型,能让它学会导向每个动作的推理以及多步行动过程本身,而不是单段答案文本。这使得智能体任务成为序列级 KD 最清晰的例证之一,因为被复制的序列就是行为本身。
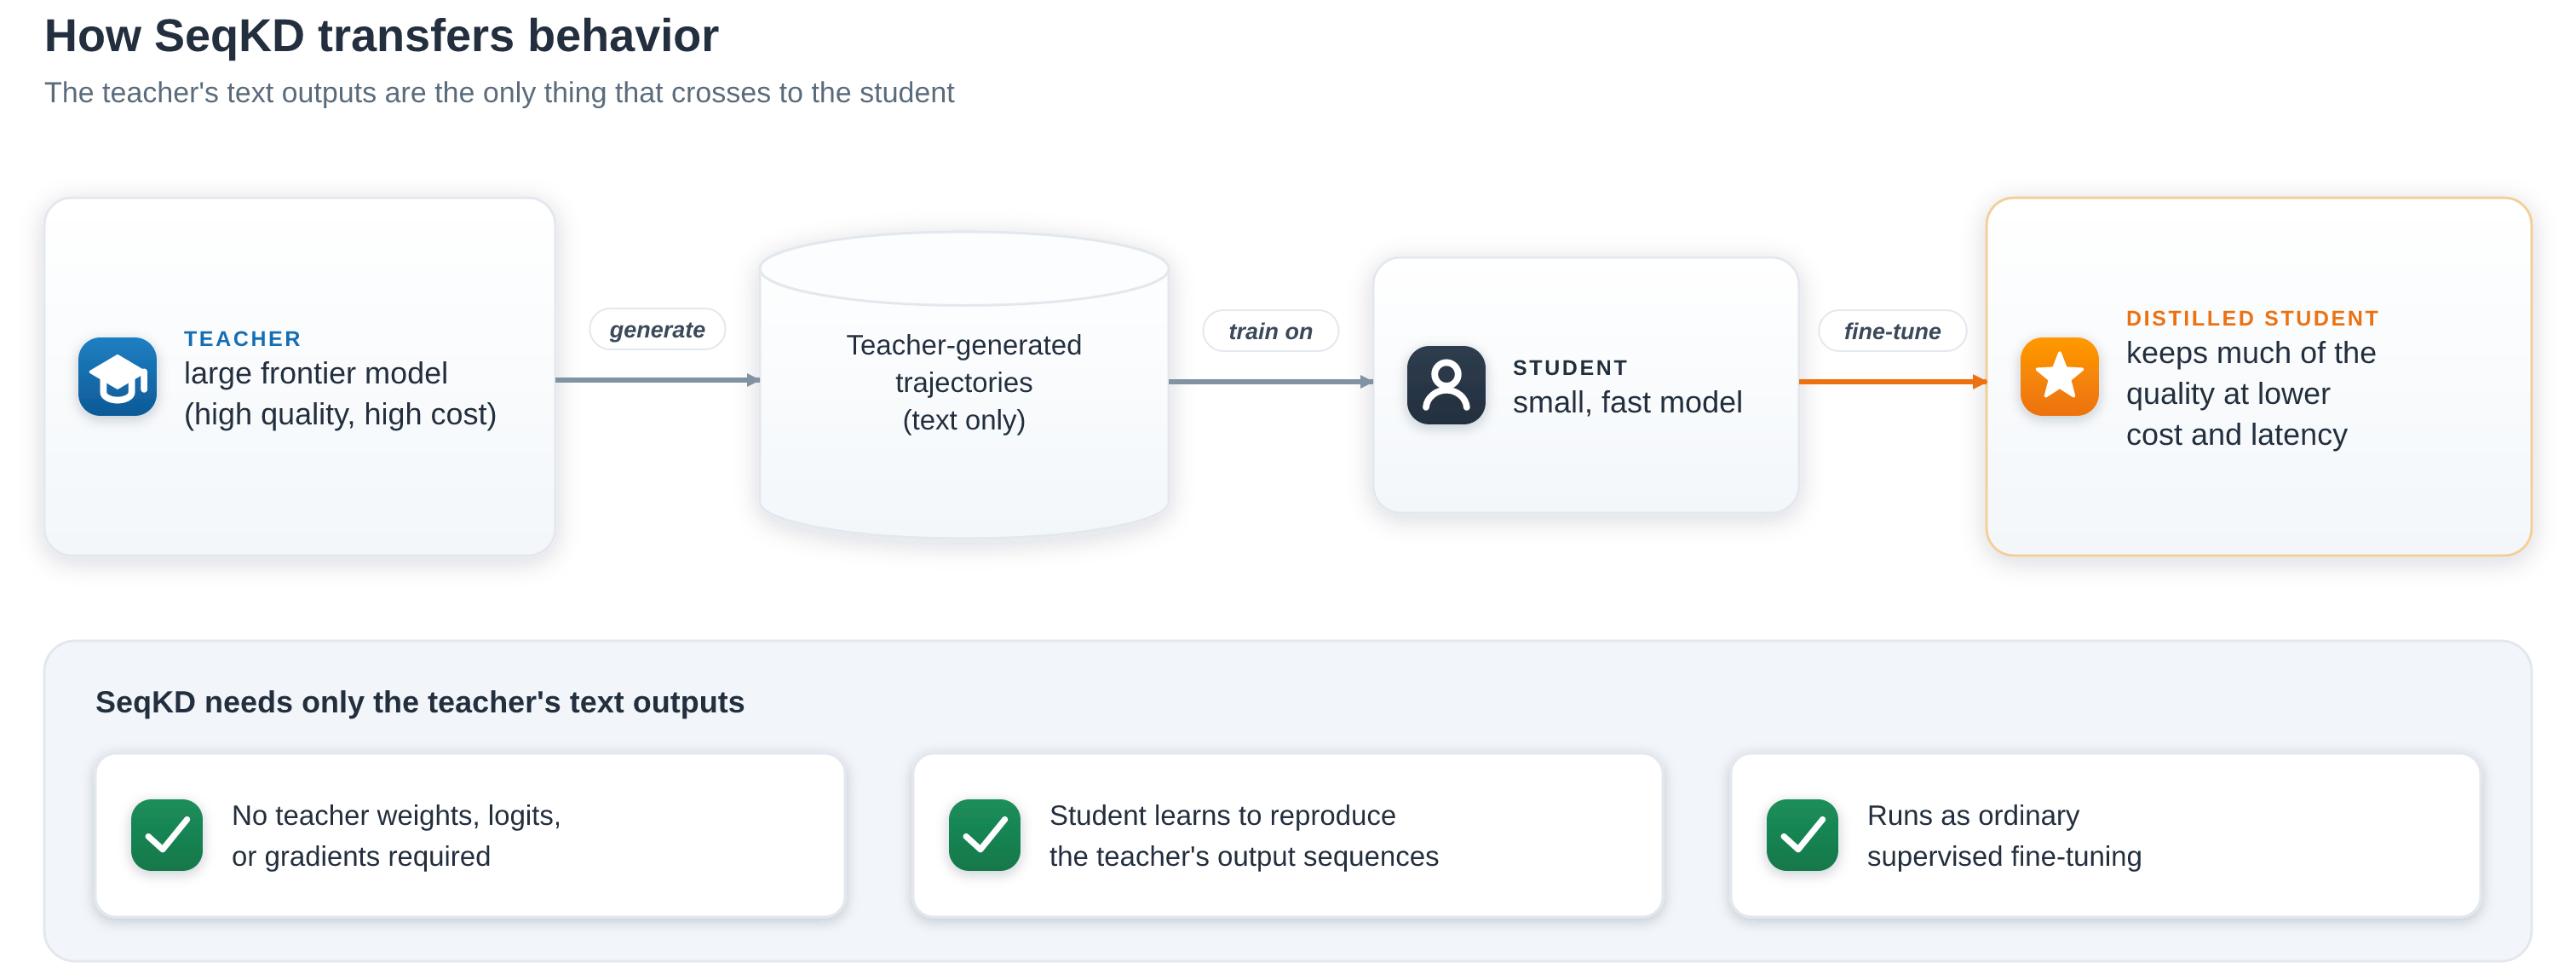
图 2:SeqKD 仅通过教师的文本输出传递行为:教师生成轨迹,学生在其上训练,结果以小模型的速度和成本保留了教师的大部分质量。训练期间不需要教师权重、logits 或梯度,因此它作为普通的监督微调运行
何时选择 SeqKD
SeqKD 适用于一组特定情形:
你有输入,但没有高质量的目标输出
这是 SeqKD 的核心场景,它本质上就是数据生成。你提供输入,教师编写目标,因此你可以在没有现成高质量标签的任务或领域上进行微调。目标可以简单到单个答案,也可以复杂到多轮工具使用轨迹。本文选取该谱系中要求较高的一端——智能体轨迹,这类数据尤其难以获取。单个任务会分支出许多部分正确的运行,而区分已解决的运行与失败的运行需要可靠的评分器。带有程序化评分器的基准恰好提供了这一点,因此你可以让教师生成轨迹,只保留解决任务的轨迹。
你的教师是只能通过 API 访问的前沿模型
这是前沿模型的常见情况。你无法访问权重来自行托管它,无法读取其 logits,也无法微调它。这就排除了基于 logit 的蒸馏和 on-policy 方法,它们都需要这种内部访问权限。SeqKD 只需要教师的文本响应,因此它是唯一仍然可行的方法,并且它让你在学生接手后不必为每次请求支付前沿模型的价格。
你想要一个强大且高性价比的第一步
一些最强的小型推理模型在很大程度上是用 SeqKD(对教师推理轨迹进行监督微调)构建的,因此在条件合适时,它是推理迁移的有效起点。DeepSeek-R1 蒸馏模型就是一个著名例子:通过在大教师模型生成的推理轨迹上微调,将大模型的推理蒸馏到较小的 Qwen 和 Llama 学生模型中。
前提条件
要运行此示例,你需要:
- 一个 AWS 账户,并具有适用于 SageMaker AI 的 AWS Identity and Access Management (IAM) 角色,该角色对 Amazon Simple Storage Service (Amazon S3) 存储桶具有读写访问权限,并有权调用你的教师模型。
- 一个用于生成轨迹的前沿教师模型(本演练使用 Amazon Bedrock 上的一个模型)。
- 在受支持的 AWS 区域中访问 SageMaker AI 模型定制的权限。
- Amazon SageMaker Studio(或已配置好 AWS CLI 的本地 IDE),运行 Python 3.12 或更高版本内核,并安装 SageMaker Python SDK v3 和
boto3(请固定版本)。笔记本环境至少使用 ml.m5.4xlarge 实例,因为数据准备和本地评分步骤都在其 CPU 上运行。 - 具备 Python、监督微调和工具调用智能体的实用知识。
- 配套代码仓库以及一个带有程序化评分器的任务(本演练使用 ShoppingBench 测试集。请替换为你自己的任务和评分器)。
解决方案概览
本节端到端地走一遍整个流水线。一个前沿教师模型——Amazon Bedrock 上的 GLM-5.3——充当 ShoppingBench 智能体来生成轨迹。基准自带的评分器只保留那些成功解决任务的轨迹,这些已解决的轨迹通过 SageMaker AI 模型定制中的无服务器监督微调来微调 Qwen3.5-4B 学生模型。随后,蒸馏后的学生模型在留出的 ShoppingBench 划分上进行评估,并部署在运行工具循环的 SageMaker AI Inference 实时端点之后。
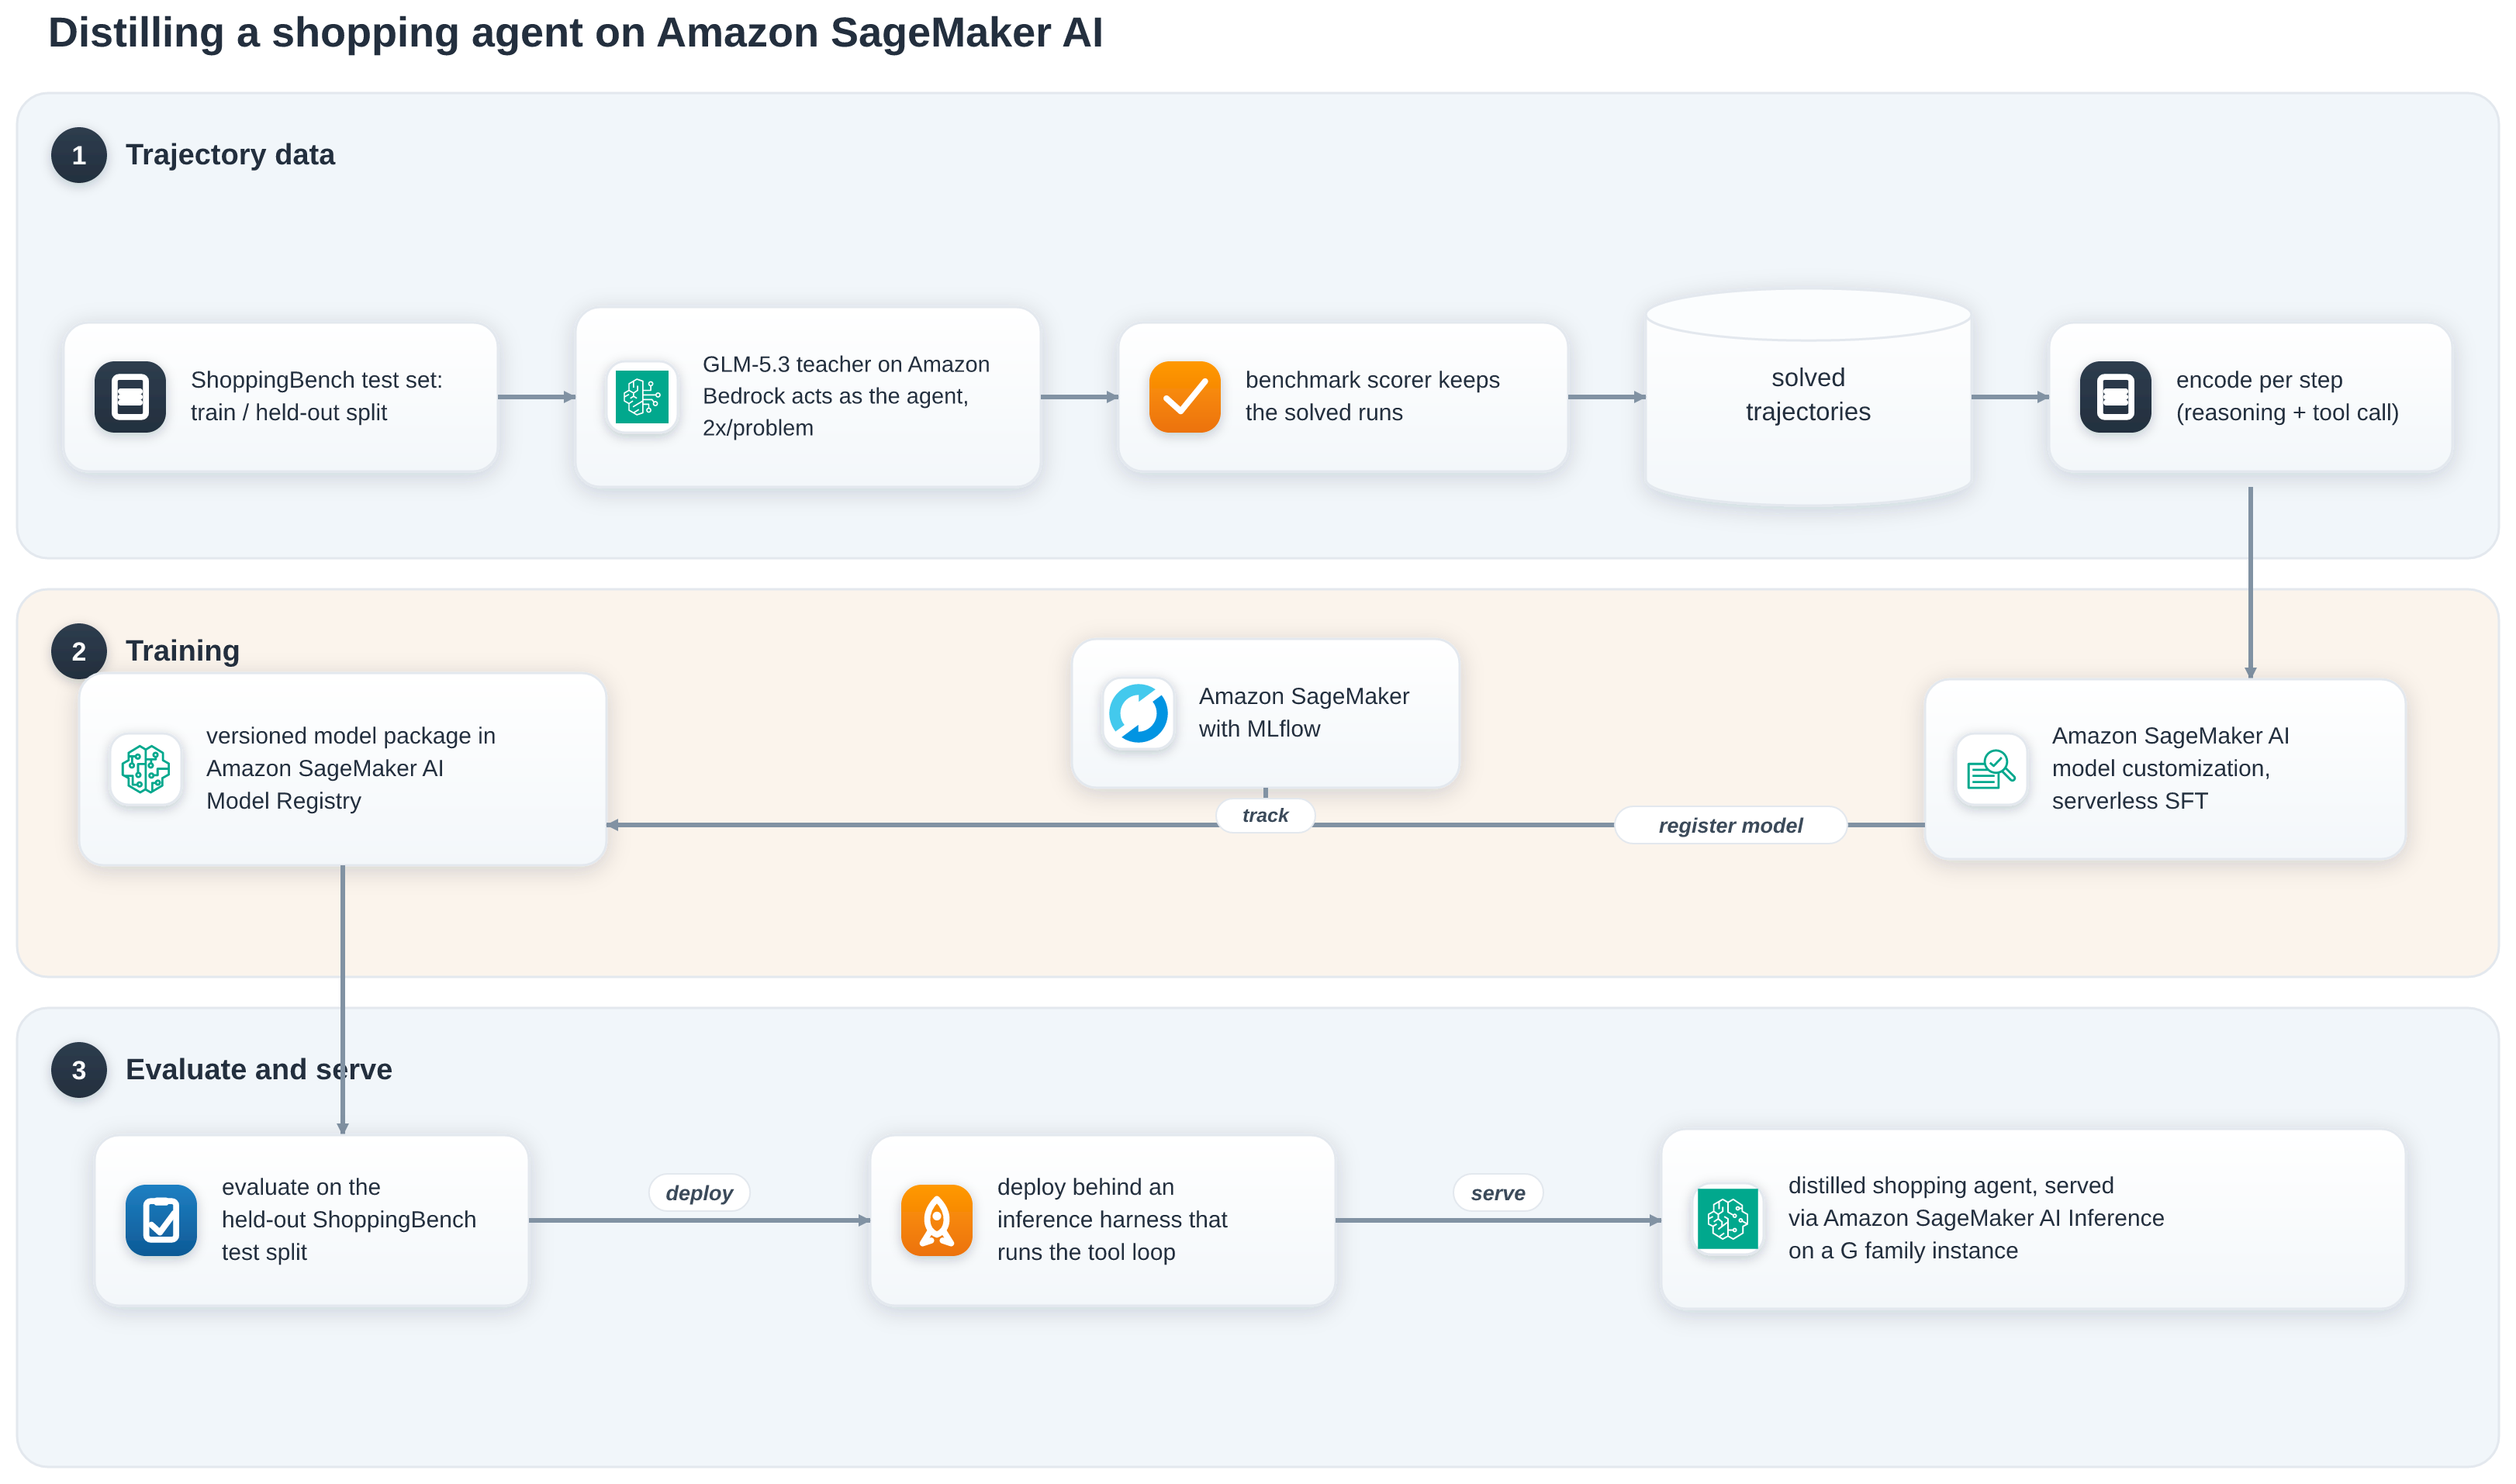
图 3:在 Amazon SageMaker AI 上蒸馏购物智能体:Amazon Bedrock 上的前沿教师模型在训练问题上充当 ShoppingBench 智能体,ShoppingBench 自带的评分器只保留成功解决任务的轨迹(拒绝采样),每条已解决的轨迹按步骤编码,学生模型通过 Amazon SageMaker AI 模型定制进行无服务器微调,结果在留出的 ShoppingBench 测试划分上评估
准备数据集
获取值得模仿的轨迹是难点所在,而 ShoppingBench 评分器正是区分成功运行与失败运行的关键。ShoppingBench 发布了 750 个合成的购物问题,产品、店铺和优惠券意图各 250 个,每个问题都有一个隐藏的黄金答案以及定义成功的约束条件。我们一次性将它们划分为 426 个训练问题和 324 个留出评估问题(产品 103、店铺 105、优惠券 116),以固定索引划分,确保两个集合不重叠。
对于每个训练问题,一个前沿教师模型——Amazon Bedrock 上开启推理、温度为 1.0 的 GLM-5.3——充当 ShoppingBench 智能体。它搜索约 270 万件商品的目录,检查候选商品,并推荐满足约束条件的商品。我们对每个问题采样教师模型两次,得到 850 条轨迹,然后让 ShoppingBench 自带的评分器只保留成功解决任务的轨迹。温度 1.0 是有意为之。采用采样而非贪婪解码,使两次尝试探索不同的查询和推理路径,从而让更多问题至少有一条已解决的轨迹,并得到更多样化的学习集合。这一拒绝采样步骤将一个有能力但不完美的教师模型转化为干净的训练集,因为教师模型只需足够频繁地正确,使已解决的运行值得模仿即可。
每条已解决的轨迹都是一个完整回合:购物者请求、教师模型在每一步的推理和工具调用(搜索、检查、推荐、终止),以及环境返回的观察结果。我们将推理与动作一并保留,结果部分表明,正是这一点让学生模型在很大程度上达到了教师模型的水平。
为训练编码轨迹
序列级蒸馏是对已存在的轨迹进行监督学习,因此训练期间不会调用任何工具,应用也只会看到文本。由于这些轨迹是多步工具使用对话,我们将每条轨迹编码为 messages 的聊天轮次列表,并让学生的聊天模板自行渲染,这样训练器看到的 token 就与智能体在推理时产生的 token 一致。
每条轨迹按步骤展开为一行训练数据。user 轮携带系统提示和到目前为止的对话。assistant 轮携带该步骤的推理及其引出的工具调用,即一个 … 块后跟一个 [{…}](采用 harness 的原生格式)。损失仅落在 assistant 轮上,因此模型学习的是生成下一步的推理与动作,而不是预测环境返回的观测。包含多个步骤的轨迹会展开为多行。在这里,经过滤后,已解决的轨迹展开为约 2,600 行训练数据和 130 行验证数据。
单行将到目前为止的对话(user)与要学习的下一步(assistant)配对:
{
  "messages": [
    {"role": "user", "content": "You are a shopping assistant. ...\n# Task\nFind a black waist bag under $20 from a shop rated 4.5 or higher.\n# Observations so far\n(none yet)"},
    {"role": "assistant", "content": "<think>Start with a broad search and let the price filter work before I narrow by shop rating.</think>\n<tool_call>[{\"name\": \"find_product\", \"parameters\": {\"q\": \"black waist bag\", \"price\": \"0-20\"}}]</tool_call>"}
  ]
}
后续每个步骤都成为独立的一行,新的观测追加到用户内容中,下一步的推理与工具调用作为 assistant 目标,直至最后的 recommend_product 和 terminate 调用。使用你模型的确切聊天模板渲染每一行。
按问题而非按行划分数据。教师模型对每个问题采样两次,且每条轨迹会展开为多个步骤,因此许多行共享同一个问题,按行划分会导致近乎相同的上下文在训练集和验证集之间泄漏。留出整个问题(约百分之五)可保持验证集的真实性。
按步骤编码的代价是上下文重复,因为每一行都会重述不断增长的对话,而无服务器微调会截断超过 dataset_max_len 的任何内容,因此超出限制的行会丢失其所需的部分内容。与其让限制决定截断什么,不如让行保持在预算之内。最有效的修复方法是压缩工具观测,因为它们在 token 数量中占主导地位。对于产品搜索结果,只保留下一步决策所依赖的字段(id、价格、评分以及正在检查的约束),丢弃原始列表文本,并限制每次搜索保留的结果数量。如果轨迹仍然超出预算,则限制每条轨迹的步骤数。此处 dataset_max_len 为 16,384 个 token,在裁剪观测后能容纳大多数轨迹。
每个划分的 JSONL 进入 S3 后,使用 SageMaker Python SDK v3 中的 DataSet.create 将每个注册为自定义 数据集资产,它会返回训练作业所需的 train_dataset 和 val_dataset。
微调学生模型
训练使用 SageMaker AI 模型自定义 和无服务器 SFT。你从 模型中心 选择一个基础模型,将作业指向编码后的数据集,托管服务会配置计算资源、运行作业并返回自定义模型,指标在 Amazon SageMaker with MLflow 中跟踪。由于数据已经是受支持的格式,因此无需管理训练脚本、容器镜像或实例。
该作业会将其输出写入一个 模型包组,该组会为其生成的每个模型创建版本,因此请先用 ModelPackageGroup.create 创建该组(如果名称已存在则复用),并将其传递给训练器。然后配置 自定义作业。选择基础模型和训练类型,将其指向训练数据集和验证数据集以及模型包组,然后命名一个 MLflow 实验,以便作业运行时指标流式传输到 MLflow。
from sagemaker.train.sft_trainer import SFTTrainer
from sagemaker.train.common import TrainingType

sft_trainer = SFTTrainer(
    model="huggingface-vlm-qwen3-5-4b",  # Qwen3.5-4B from the JumpStart model hub
    training_type=TrainingType.LORA,  # TrainingType.FULL for full fine-tuning
    training_dataset=train_dataset.arn,
    validation_dataset=val_dataset.arn,
    model_package_group=model_package_group,
    mlflow_experiment_name="seqkd-shopping-exp",
    s3_output_path="s3://<amzn-s3-demo-bucket>/seqkd/output/",
    accept_eula=True,
)
训练器从一组有文档记录的默认超参数开始,你可以使用 sft_trainer.hyperparameters.to_dict() 检查这些超参数,并在启动前覆盖它们。对于本次运行,我们提高序列长度以适配多步轨迹,使用 64 的 Low-Rank Adaptation (LoRA) 秩,并在小数据集上训练三个 epoch:
sft_trainer.hyperparameters.dataset_max_len = 16384
sft_trainer.hyperparameters.max_epochs = 3
sft_trainer.hyperparameters.global_batch_size = 64
sft_trainer.hyperparameters.learning_rate = 0.0001
sft_trainer.hyperparameters.lora_rank = 64
sft_trainer.hyperparameters.lora_alpha = 256  # alpha / rank = 4
sft_trainer.hyperparameters.lr_warmup_steps_ratio = 0.1
sft_trainer.hyperparameters.train_val_split_ratio = 0.95
通过试运行验证配置,然后启动托管作业,并在其完成时读取已注册的 Model Package ARN。该 ARN 是可供部署的产物,供评估和 serving 步骤使用:
from sagemaker.core.resources import TrainingJob

sft_trainer.train(dry_run=True)  # checks the config without launching
training_job = sft_trainer.train(wait=True)  # launch and wait
model_package_arn = TrainingJob.get(
    training_job_name=training_job.training_job_name
).output_model_package_arn
评估学生模型
分两个阶段进行评估,成本最低的优先。完整的端到端评估既耗时又耗费资源。它会在数百万个产品上启动搜索服务器,部署端点,并对每个留出问题运行多步 agent 循环。在运行完整评估之前,使用 SageMaker AI 模型评估运行一次低成本的托管预检查,该检查会针对教师的真实动作,一次对一个生成的步骤进行评分。
预检查需要一个评分函数。模型评估支持你提供的 Custom Scorer 奖励函数,该函数对每个样本运行一次,将学生模型生成的动作与教师的动作进行比较。对于工具调用蒸馏,对工具选择进行评分(模型是否按顺序调用了正确的工具,忽略参数格式),因为这是蒸馏最需要迁移的行为。为了将重点放在选择而非语法上,奖励函数从学生模型的动作和教师的参考中读取工具名称,而不要求精确的格式匹配。
def reward_function(sample, index):
    pred = sample.get("model_response", "")
    ref = sample.get("reference_answer", "") or sample.get("response", "")

    ref_names = tool_names(ref)  # tool names from the teacher's <tool_call>[...]</tool_call>
    pred_names = tool_names(pred)  # tool names the student emitted, parsed leniently
    toolset = 1.0 if (pred_names and pred_names == ref_names) else 0.0

    return {
        "id": str(sample.get("id", f"sample-{index:03d}")),
        "aggregate_reward_score": toolset,  # the gate metric: tool selection
        "metrics_list": [
            {"name": "toolset_match", "value": toolset, "type": "Reward"},
        ],
    }
使用 Evaluator.create() 将该函数注册为带版本的 Evaluator,然后调用 evaluate() 为每个任务运行一个 Custom Scorer 作业,同时对学生模型和基础模型进行评分,以便每个结果都有对比。
决策规则很简单。学生模型必须在这项低成本预检查中胜过基础模型。如果胜出,说明蒸馏生效,值得运行更全面的端到端评估。如果没有,请先修复训练。
部署蒸馏后的 agent
蒸馏后的模型不会自行运行工具。微调教会它在正确的时机以文本形式发出正确的工具调用,但仍然需要有东西来执行该调用并反馈结果。在推理时,你将模型包装在一个小型确定性 harness 中,该 harness 会提示模型,解析它发出的工具调用,运行工具,追加观察结果,然后再次提示,循环直到模型产生最终答案。这是普通的应用程序代码,或现成的 serving 框架,而不是强化学习,也不是 on-policy 训练循环。
学生模型是一个基于开放权重基础模型的低秩适配(LoRA)适配器,这决定了它的部署方式。与其合并适配器并再提供一份完整的权重副本,不如只提供一次基础模型,并将学生模型作为适配器附加在其上,作为单个实时端点上的两个推理组件。在调用时指定推理组件即可选择由哪一个来响应,因此同一个端点可以同时提供基础模型和蒸馏后的学生模型,便于并排比较。
我们使用 Deep Java Library Large Model Inference(DJL LMI)容器来提供开放权重模型,该容器内置了用于高吞吐量生成的 vLLM 引擎,并固定到特定版本而非 latest,因此重新部署具有可复现性。配套的 notebook 将推理组件调用封装在一个小的 kd_serve 辅助函数中,因此,部署启用了 LoRA 服务的基础组件、再附加学生适配器,就简化为:
from sagemaker.core import image_uris
import kd_serve

# DJL LMI container (vLLM engine bundled in); pin the version for reproducible redeploys
image_uri = image_uris.retrieve("djl-lmi", region=region, version="0.36.0")

# 1. Deploy the base model as an inference component, with LoRA serving enabled.
endpoint_name, base_ic = kd_serve.deploy_base_endpoint(
    endpoint_name="seqkd-shopping-agent",
    role=role,
    region=region,
    image_uri=image_uri,
    base_model_id="Qwen/Qwen3.5-4B",
    instance_types=["ml.g5.2xlarge", "ml.g6.2xlarge", "ml.g6e.2xlarge"],
    max_lora_rank=64,
    max_loras=4,
    max_model_len=131072,
)

# 2. Resolve the student's adapter artifacts from its Model Package and attach them
# as a second inference component on the same base.
adapter_uri = kd_serve.resolve_adapter_uri(model_package_arn, region)
student_ic = kd_serve.attach_adapter(
    endpoint_name=endpoint_name,
    base_ic_name=base_ic,
    adapter_component_name=f"{endpoint_name}-student",
    adapter_s3_uri=adapter_uri,
    region=region,
)
instance_types 列表是一个有序的偏好顺序。SageMaker AI Inference 会在第一个有可用容量的类型上部署,并沿列表向下回退,因此学生模型会根据可用性运行在 ml.g5.2xlarge、ml.g6.2xlarge 或 ml.g6e.2xlarge 上。基础权重只加载一次,两个推理组件共享它们,因此添加适配器所消耗的内存仅为适配器大小,而不是模型的第二份副本。
结果
我们在留出的 ShoppingBench 测试集上评估蒸馏后的学生模型,并与一组参考点进行对比,这些参考点界定了“好”的标准:
- 基础 Qwen3.5-4B:未经微调的现成学生模型。这是下限。
- 蒸馏学生模型(SeqKD):在教师轨迹上微调的同一个 4B 模型,即本文所述的方法。这是关键结果。
- GLM-5.3 教师:生成训练数据的前沿模型,运行在 Bedrock 上。我们同时报告其采样模式(温度 1.0,即生成数据时的设置)和贪婪模式(温度 0)。
- 中等规模前沿模型:作为智能体运行的强大专有模型,作为实际性能上限纳入。
每个模型都在三种购物者意图(商品、店铺和优惠券)上运行相同的、未经修改的 ShoppingBench 智能体循环。我们报告绝对成功率(ASR),即智能体解决的留出问题所占比例,在三种意图上取平均,缺失的轨迹计为失败。当推荐的产品满足所有声明的约束时,该问题才算解决。以下数字来自使用 LoRA 学生模型的单次运行,因此预计会有几个百分点的运行间波动。
任务成功率
主要结果是在 324 个留出问题上的绝对成功率,按意图细分并在三者上取平均:
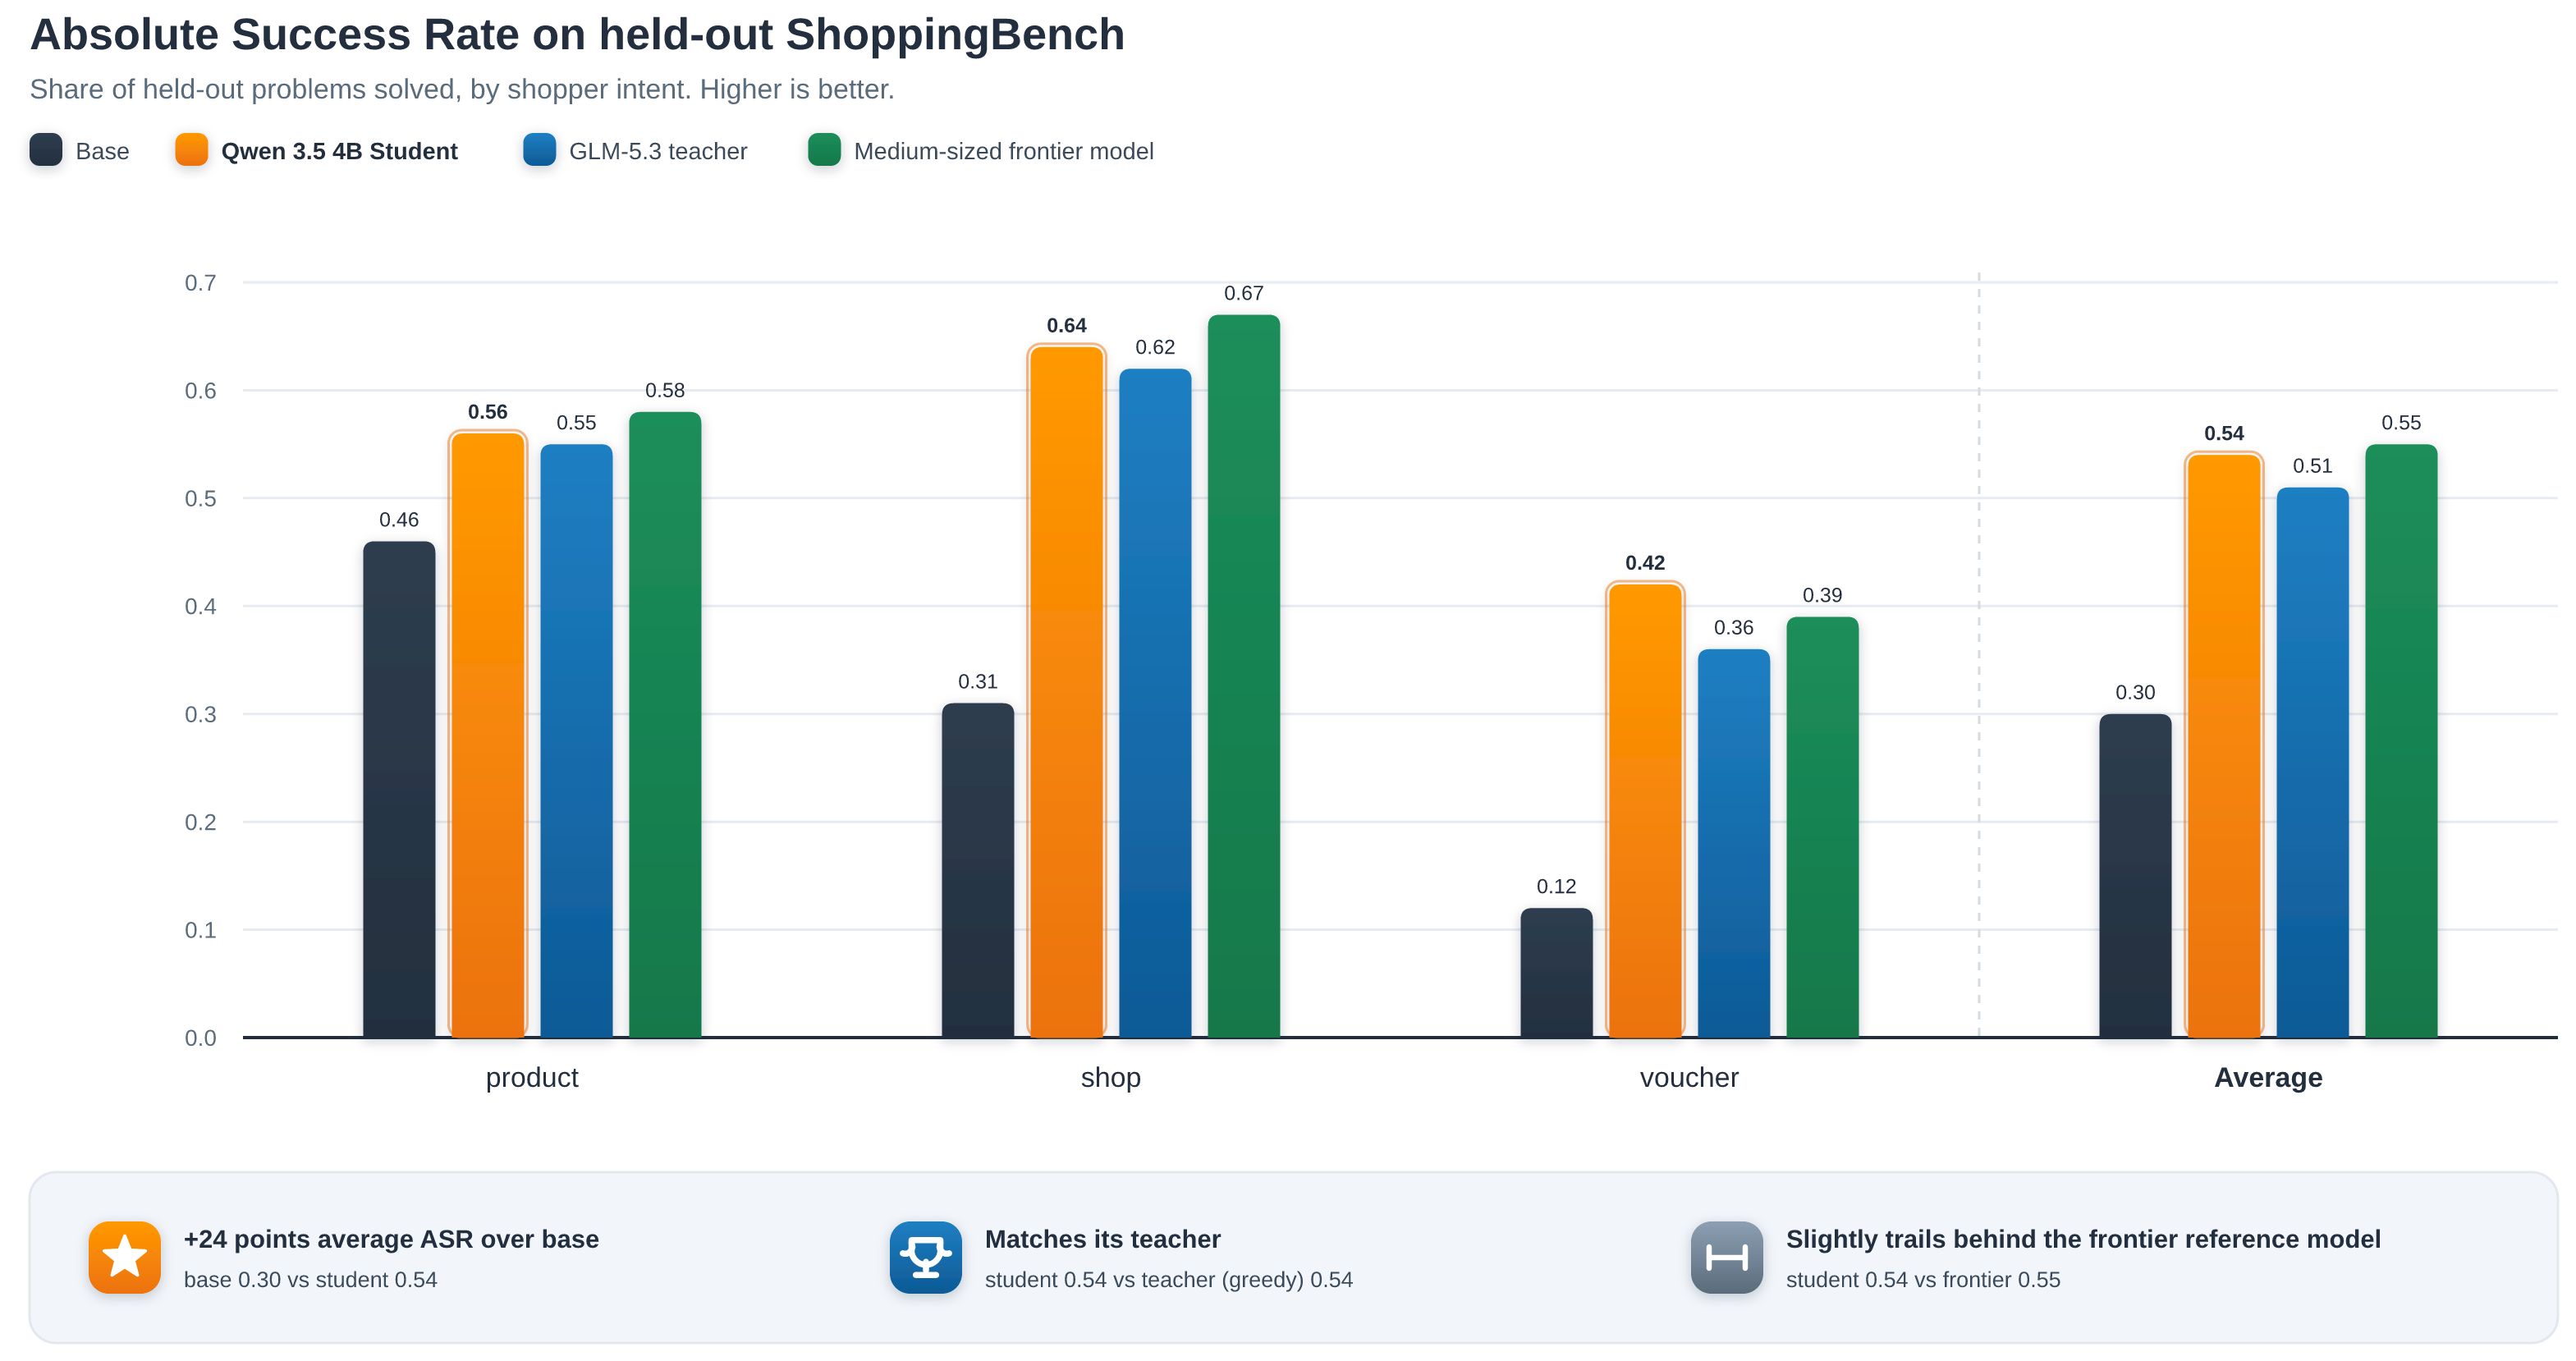
图 4:在留出的 ShoppingBench 测试集上按购物者意图划分的绝对成功率(ASR)。蒸馏后的 4B 学生模型(橙色)平均比基础模型提升 24 个百分点,达到生成其数据的 GLM-5.3 教师以及中等规模前沿模型的水平
| 模型 | 商品 | 店铺 | 优惠券 | 平均 |
| 基础 Qwen3.5-4B(未微调) | 0.456 | 0.314 | 0.121 | 0.297 |
| 蒸馏学生模型(SeqKD) | 0.563 | 0.638 | 0.422 | 0.541 |
| GLM-5.3 教师(采样,温度 1.0) | 0.553 | 0.619 | 0.362 | 0.511 |
| GLM-5.3 教师(贪婪,温度 0) | 0.544 | 0.638 | 0.439 | 0.540 |
| 中等规模前沿模型 | 0.583 | 0.667 | 0.388 | 0.546 |
总之,一个 4B 模型基本恢复了其前沿教师模型的全部任务质量,在运行间噪声范围内与之持平。我们以两种方式报告教师模型的结果,因为它们回答的是不同的问题。贪心解码返回单条最可能的轨迹,当每个模型对每道题只有一次尝试机会时(如本次评估),这是更强的选择,这也是贪心教师模型得分为 0.540、而采样教师模型为 0.511 的原因。我们以另一种方式生成训练数据,在温度 1.0 下采样,使重复尝试探索不同路径,评分器可以保留那些成功解决任务的路径。这种过滤也正是学生模型能够略胜其所学习的采样教师模型的原因:拒绝采样只用在教师模型成功解决的运行上训练它,而非其平均输出,因此它模仿的是最优切片,而非全部尝试的分布。
目标中的推理很重要
学生模型既从教师模型的工具调用中学习,也从其推理中学习,这一选择是结果中很大一部分的成因。在相同轨迹上训练同一个学生模型但剥离推理、只保留裸工具调用,平均 ASR 从 0.541 降至 0.415:
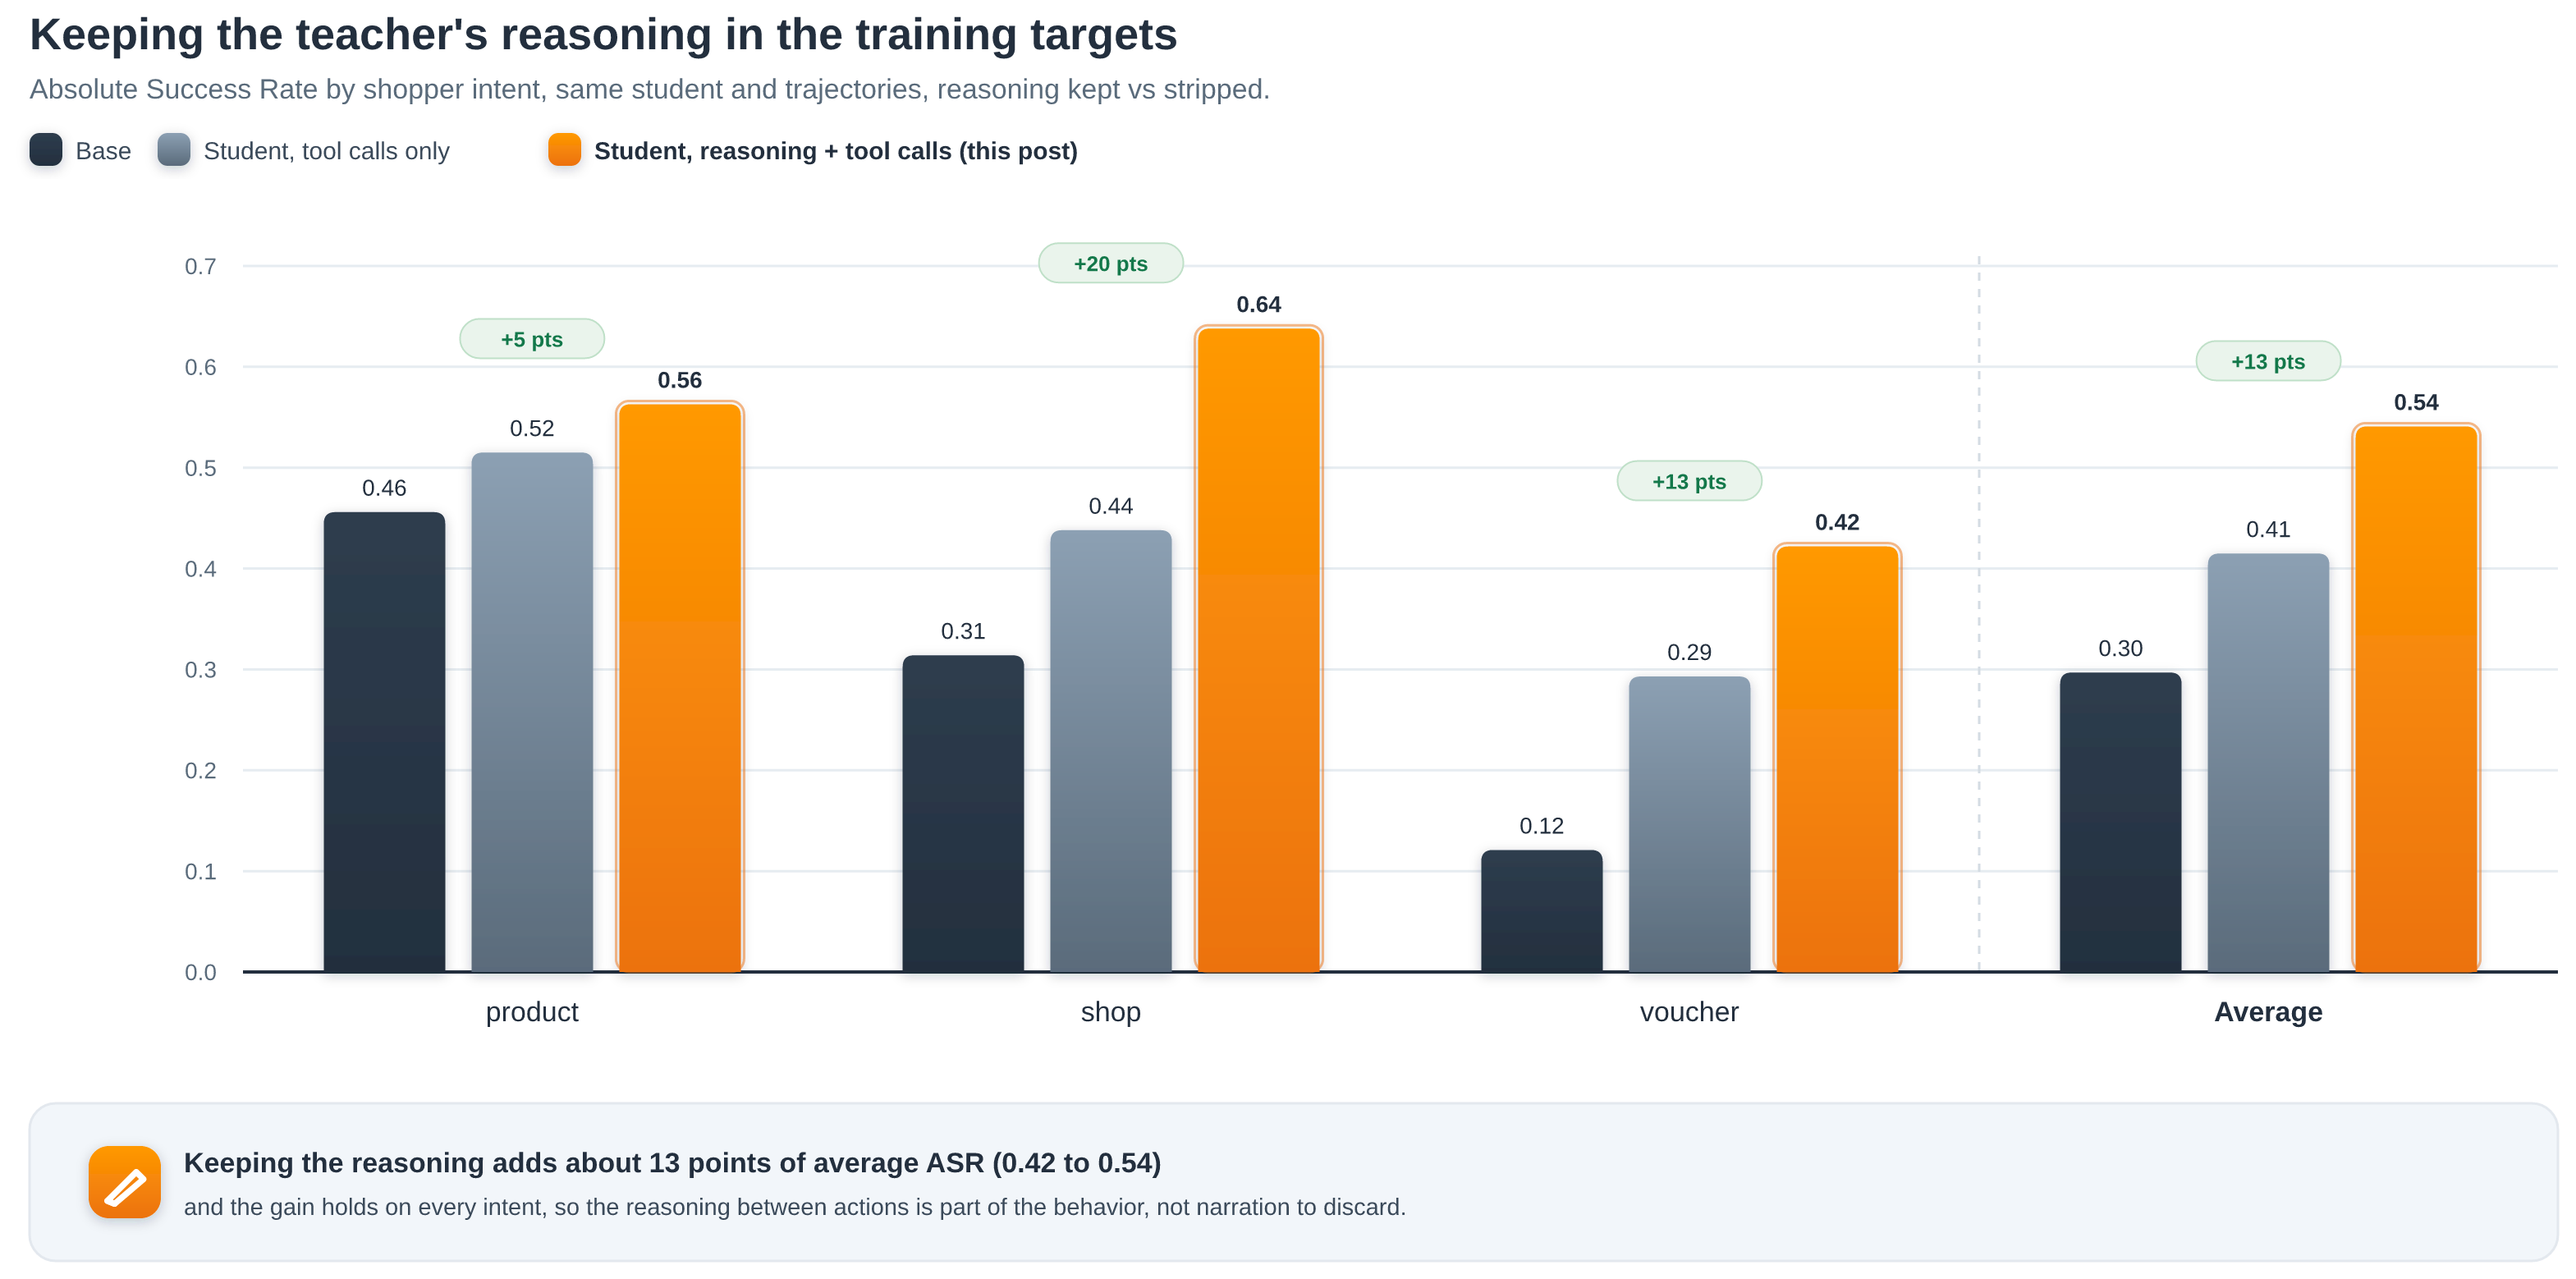
图 5:基础模型、仅在工具调用上训练的学生模型,以及在教师模型推理加工具调用上训练的学生模型的绝对成功率。保留推理使平均 ASR 提升约 13 个点,且该增益在每个意图上都成立
两个学生模型都超过了基础模型,因此即使仅工具调用版本也是实实在在的改进,但保留推理才是把学生模型一路带到其教师模型水平的关键。动作之间的推理不是可以丢弃的叙述,而是解决任务的行为的一部分。
保持通用能力
ASR 衡量的是我们所蒸馏的技能。与之相权衡的是学生模型是否保留了通用指令遵循能力,还是过拟合到购物任务上。我们用 IFEval 来检查,这是一个通用指令遵循基准,对可验证的格式指令(如“恰好用三个要点作答”)进行评分。请将其视为回归检查,而非排行榜。学生模型的 prompt-strict 分数从基础模型的 0.819 降至 0.741,instruction-strict 分数从 0.872 降至 0.813,下降约 6 到 8 个点(图 6)。这是专业化的预期代价。学生模型用部分通用指令遵循能力换取了购物任务上的大幅提升。若下降幅度大得多,才是蒸馏使模型过度收窄的警示信号。
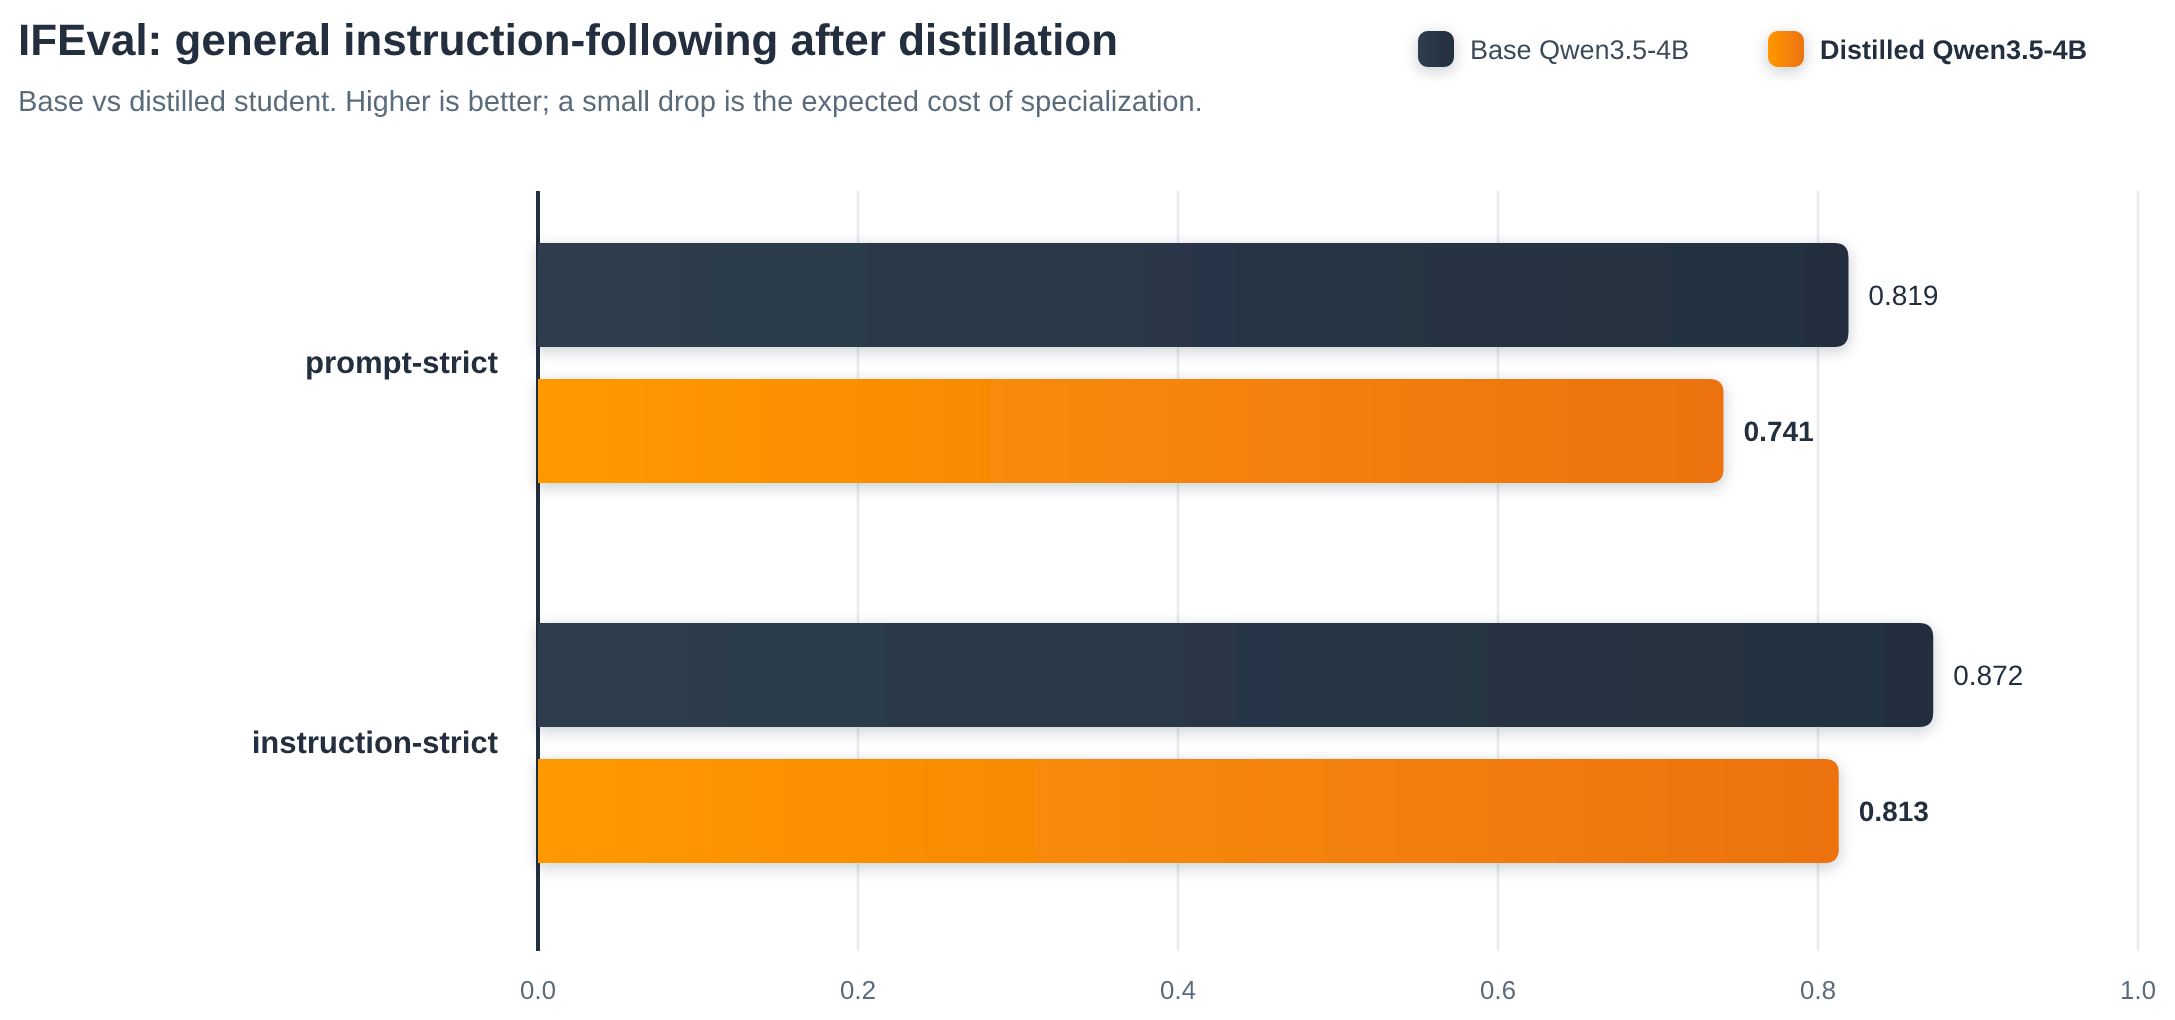
图 6:基础模型与蒸馏后学生模型在 prompt-strict 和 instruction-strict 指标上的 IFEval 通用指令遵循表现。小幅下降是在购物任务上专业化的预期代价
收益与权衡
仅凭成功率本身并不足以证明切换的合理性。蒸馏的理由在于:以小模型的成本和速度获得更强模型的大部分质量。这里最清晰的证据是,4B 学生模型达到了其前沿教师模型和中等规模前沿模型的任务质量,同时小到足以在单个 G 系列实例(本例中为 NVIDIA A10G/L40/L40S)上提供服务。
成本差异既关乎规模,也关乎形态。通过 API 访问的前沿模型按 token 计费,在每项任务的每个步骤上都要计费,因此成本随用量增长而不会停止,引言中提到的智能体循环每次都要支付这笔费用。蒸馏出的学生模型运行在你自行托管的端点上,按小时对实例计费,无论它服务一项任务还是数千项任务,因此在横向扩展之前,增加的流量不会带来额外成本。你是在用按请求计费的变动成本换取按小时计费的固定成本,而你能采用的学生模型越小,这项固定成本就越低。
我们在此不公布每项任务的成本或延迟数字,因为这取决于你的流量:G 系列实例所能维持的吞吐量,以及由此摊到每项任务上的成本,都是你的请求模式、序列长度和并发度的函数。请在你自己的工作负载上,对照当前的 SageMaker AI 定价 和你的前沿提供商的 token 定价进行测量,而不是依赖某个单一的头条数字。
局限性与最佳实践
任务是否适合学生模型(容量墙)
蒸馏传递的是学生模型已经能够表示的分布,而不是它本身不具备的原始能力。差距过大时,学生模型会复制教师的格式,却学不会如何求解。用大型教师的思维链训练的小模型,会产生冗长、结构良好的推理,但答案仍然是错的;以同样方式训练的智能体则会发出格式正确的工具调用却毫无进展,用改写的查询反复搜索,并在未满足约束的情况下跑到步数上限。两者的症状相同:轨迹变长,而准确率持平。一旦出现这种情况,就应停止添加数据,要么增大模型,要么降低任务难度。
决定这一点的是任务与学生模型之间的差距,而不是学生模型与教师之间的差距。只要任务本身在学生模型的能力范围之内,小的学生模型就能恢复大得多的教师的质量。这正是这里的购物智能体能够奏效的原因。教师是一个混合专家模型,约有 400 亿活跃参数,约为学生模型 40 亿参数的十倍,但购物任务完全在 4B 模型的能力范围之内,因此学生模型恢复的是教师的质量,而不只是拉长了自己的轨迹。
SeqKD 在何处不再有效
SeqKD 能提升简单和中等难度的问题,但在最难的问题上会趋于停滞,因为在这些问题上学生模型必须从自己的错误中恢复。这对智能体而言比单步任务更为突出。在多步循环中,早期的错误会不断累积,因为学生模型看不到自己的错误所导致的状态。弥合这一差距正是 on-policy 方法的目标,这也是 SeqKD 通常只是第一阶段而非终点线的原因。SeqKD 对基础设施的要求也最低,因为它只使用教师的文本,而 logit 蒸馏需要教师的逐 token 分布,on-policy 方法则要对学生模型自己的 rollout 打分。先做纯文本的 SeqKD 热启动,再接一个 on-policy 阶段,是一种常见的做法,因此本文涵盖第一阶段,而突破这一停滞则是自然的下一步。
决定结果的两个选择
首先,将训练目标与你期望的行为对齐。在这里,这意味着在每次工具调用时保留教师的推理过程,而不是压缩为最终答案,因为推理是解决问题的一部分(结果部分量化了这一差距),并且用智能体在服务时使用的聊天模板来渲染每个目标。其次,诚实地评估。在模型未见过的数据上进行测量,因为泄露的基准会抬高分数,并且要与学生必然能超越的未训练基础模型之外的更多对象进行比较,将其与教师模型和一个独立的前沿模型并列,这样数字才能显示学生与其蒸馏来源的接近程度。
清理
实时推理端点只要运行就会计费,因此在获得结果后,请拆除你为提供服务而启动的端点。由于学生模型是作为基础推理组件之上的适配器推理组件来提供服务的,因此各部分必须按依赖顺序拆除:先拆除适配器组件,再拆除基础组件,最后拆除端点及其配置。随附的 kd_serve 辅助工具会为你完成此操作,它会从结构上查找适配器,因此无论组件的确切名称是什么,它都能进行清理:
import kd_serve

# Deletes the adapter IC, then the base IC, then the endpoint and its configuration
kd_serve.teardown_endpoint(endpoint_name, region=region)
训练作业本身无需清理。无服务器训练会自动配置计算资源、运行并释放它,因此已完成的作业不会产生持续费用。注册的模型包及其组不产生计算成本,因此你可以保留它们用于追溯来源并在以后重新部署。唯一持续产生费用的是你在 S3 中的数据(编码的轨迹和输出产物),只要保留就会产生存储费用,因此请删除不再需要的内容,或将其移至成本更低的存储类别。
结论
在本文中,我们展示了如何使用序列级知识蒸馏(SeqKD)将智能体购物助手蒸馏为一个更小、成本更低的学生模型。我们使用 Bedrock 上的前沿教师模型生成了高质量的单轮、多步轨迹,并使用 ShoppingBench 自带的评分器仅保留那些成功完成任务的轨迹,将每一步编码为聊天格式的消息,在保留教师推理的同时保留其工具调用,使用 SageMaker AI 模型定制在无服务器基础设施上微调学生模型,使用 MLflow 跟踪训练,使用 SageMaker AI 模型评估运行质量门禁检查,并将结果部署在运行工具循环的推理端点之后。回报是一个 4B 的学生模型,它基本恢复了其前沿教师模型的全部任务质量。由于 SeqKD 只需要教师的文本输出,因此即使教师是你通过 API 访问的封闭前沿模型,它也能发挥作用,并且在学生模型接管后,你可以停止为每一步支付前沿模型的价格。
SeqKD 是强有力的第一步,但也有实际局限。将学生模型的规模与任务相匹配,在留出测试集上针对强参考点进行评估,而不仅仅是未训练的基础模型,并且当最难的长尾问题难以模仿时,在 SeqKD 之后采用本文未涵盖的 on-policy 方法,让学生模型从自己的 rollout 中学习。
要自行尝试,请参阅随附的代码仓库和 SageMaker AI 文档。
关于作者

Giuseppe Zappia
Giuseppe 是 AWS 的首席 GenAI 专家解决方案架构师,专注于帮助大型企业在 AWS 上设计和部署生成式 AI 解决方案。他拥有超过 20 年的全栈软件工程师经验,过去 7 年在 AWS 专注于 AI 领域。

Ankita Agarwal
Ankita 是 AWS 的软件开发工程师,负责 Amazon SageMaker AI 的分布式训练和强化学习工作。她拥有南加州大学计算机工程硕士学位。工作之余,她喜欢旅行。

Amin Dashti
Amin 是 AWS 的高级数据科学家和研究员,负责训练后和模型定制工作:强化学习、微调和知识蒸馏,以适配大型模型并将其能力压缩到更小、可部署的模型中。他拥有超过八年的经验,在计算机视觉、自然语言处理和金融系统统计推断领域构建和部署机器学习系统。他拥有理论物理学博士学位,这影响了他对模型行为和评估的处理方式。

Michael Oguike
Michael 是 Amazon SageMaker AI 的产品经理。他致力于将技术和 AI 应用于解决现实世界的问题。在 AWS,他帮助各行业客户大规模构建、训练和部署 AI/ML 模型。在加入 AWS 之前,Michael 设计和运营海上油气井和设施。工作之余,他喜欢通过书籍和播客探索行为科学和心理学。